Prompt templates zijn vaste skeletten die je telkens opnieuw invult. Geen toverspreuken, maar structuur: je vertelt het model wat zijn rol is, wat je precies wilt, welk materiaal het heeft en hoe het antwoord eruit moet zien. Zodra je dat skelet eenmaal hebt, scheelt het je elke keer denkwerk én geeft het stabielere antwoorden.
Hieronder vijf sjablonen die je vandaag kunt gebruiken in ChatGPT, Claude of Gemini. Kopieer ze, vul de blokken in, en pas ze aan op jouw situatie. Ze zijn opgebouwd volgens dezelfde logica als mijn KOMPAS-methode: kader, opdracht, materiaal, eisen en sturing.
Waarom prompt templates beter werken dan losse vragen
Een losse vraag laat te veel open. Het model raadt naar je context, je doel en de vorm — en raadt vaak verkeerd. Een template dwingt je om die dingen vooraf op te schrijven. Niet voor het model, maar voor jezelf: de meeste slechte antwoorden komen door een vage opdracht, niet door een dom model.
Wat een goede template doet:
Rol — wie moet het model spelen? Een redacteur denkt anders dan een marketeer.
Taak — wat moet er concreet uitkomen, in één zin.
Context — de feiten, het bronmateriaal, de doelgroep.
Vorm — lengte, structuur, toon, taal.
Grenzen — wat het model níét moet doen.
Die vijf blokken zie je in elke template hieronder terugkomen. Meer over de denkstappen erachter lees je in betere prompts schrijven.
De 5 prompt templates
1. Tekst schrijven
Voor blogs, mails, productteksten, social posts.
Je bent [rol, bijv. een nuchtere copywriter]. Schrijf een [tekstsoort] over [onderwerp] voor [doelgroep]. Doel van de tekst: [actie of gevoel]. Toon: [bijv. direct, geen jargon]. Lengte: [aantal woorden]. Gebruik deze punten: [3-5 bullets]. Vermijd: [clichés, holle superlatieven].
Werkt omdat je doelgroep én doel expliciet maakt. Zonder die twee krijg je gladde, nietszeggende tekst.
2. Samenvatten
Voor lange documenten, transcripts, artikelen.
Vat onderstaande tekst samen voor [wie het leest]. Geef eerst de kernboodschap in één zin, daarna [aantal] bullets met de belangrijkste punten. Laat details weg die [doelgroep] niet nodig heeft. Tekst: [plak hier].
De truc is de losse opdracht “vat samen voor wie” — een samenvatting voor je baas ziet er anders uit dan eentje voor jezelf.
3. Coderen / vibe coding
Voor Cursor, Lovable, Bolt of gewoon ChatGPT.
Ik bouw [wat] met [taal/framework]. Doel: [gedrag dat je wilt]. Schrijf [functie/component] die [taak]. Houd rekening met [randgevallen]. Leg in commentaar uit waarom je keuzes maakt. Vraag door als iets onduidelijk is voordat je code schrijft.
Die laatste zin is goud bij vibe coding: hij voorkomt dat het model honderd regels code uitspuugt op basis van een aanname.
4. Beslissen / afwegen
Voor keuzes waar je tegenaan hikt.
Ik moet kiezen tussen [optie A] en [optie B] voor [situatie]. Wat telt voor mij: [criteria]. Geef de sterke en zwakke kanten van elke optie tegen die criteria, en sluit af met een aanbeveling plus de belangrijkste twijfel daarbij.
Door je criteria vooraf te benoemen, dwing je een afweging af in plaats van een algemeen lijstje voor- en nadelen.
5. Feedback vragen
Voor je eigen tekst, plan of idee.
Geef kritische feedback op onderstaande [tekst/plan] als [rol, bijv. strenge redacteur]. Noem de drie zwakste punten en hoe ik ze oplos. Wees concreet, vermijd algemeenheden. Materiaal: [plak hier].
Vraag om de zwakste punten, niet om “feedback” — anders krijg je vooral complimenten.
Hoe je een template naar je eigen situatie buigt
Een template is een startpunt, geen eindstation. Drie aanpassingen die het meeste opleveren:
Maak de rol specifieker. “Een ervaren redacteur van een vakblad voor bouwers” stuurt veel scherper dan “een schrijver”.
Voeg een voorbeeld toe. Plak een stukje tekst in de stijl die je wilt en zeg: schrijf in deze toon. Een voorbeeld zegt meer dan tien bijvoeglijke naamwoorden.
Itereer. Krijg je niet wat je wilt? Vertel wat er misgaat (“te formeel”, “te lang”) in plaats van helemaal opnieuw te beginnen.
Bouw een klein bestand met je beste templates op. Na een paar weken heb je een eigen bibliotheek die past bij jouw werk — en dat scheelt meer tijd dan welke trucjeslijst dan ook. Wil je templates die specifiek op één tool zijn afgestemd, kijk dan ook bij de ChatGPT-prompts.
Veelgestelde vragen
Werken deze prompt templates ook in Claude en Gemini?
Ja. De structuur — rol, taak, context, vorm, grenzen — werkt bij alle grote modellen. De modellen reageren onderling iets anders op toon en lengte, dus test je template kort in de tool die je gebruikt en stel hem bij.
Hoeveel detail moet ik in een template stoppen?
Genoeg om het raadwerk weg te nemen, niet meer. Doelgroep, doel en vorm zijn bijna altijd nodig. Eindeloos lange prompts maken het juist onoverzichtelijk. Begin compact en voeg alleen toe wat je antwoord echt verbetert.
Moet ik elke keer een template gebruiken?
Nee. Voor een snelle vraag is een losse zin prima. Templates lonen bij taken die je vaker doet of waar de uitkomst belangrijk is — dan betaalt de structuur zich terug in consistentie.
Hoe weet ik of mijn prompt goed genoeg is?
Laat hem scoren. De gratis prompt-coach hieronder beoordeelt je prompt en herschrijft hem direct, zodat je ziet welke blokken je miste.
Wil je weten hoe sterk jouw prompt is? Plak hem in de gratis prompt-coach — die scoort en herschrijft hem meteen. Kom je er met de templates niet uit voor jouw vakgebied, dan helpt de coaching je een set op maat te bouwen die je elke dag gebruikt.
GPT-Live verandert hoe je met ChatGPT praat: het model luistert en spreekt tegelijk, je kunt onderbreken, en complexe vragen worden op de achtergrond door GPT-5.5 beantwoord. OpenAI noemde het op X het slimste spraakmodel tot nu toe. Voor vibe coders en prompt-coaches betekent dat: spraak wordt een serieuze werkinterface — niet alleen een gimmick voor onderweg.
Wat is GPT-Live in één minuut?
Full-duplex — geen turn-based wachten; onderbreken zoals bij een mens
GPT-Live-1 (betaald) en GPT-Live-1 mini (gratis) vervangen Advanced Voice Mode
Delegatie — zoeken en redeneren gaat naar GPT-5.5 terwijl het gesprek doorloopt
Visuele kaarten tijdens het gesprek (weer, data, sport)
OpenAI ziet spraak als toekomstige primaire interface voor langdurig agentisch werk — vergelijkbaar met Codex, maar hands-free.
Waarom dit ertoe doet voor prompting
Tekst-prompts zijn gecontroleerd: je ziet wat je typte. Spraak is rommeliger — aarzelingen, halve zinnen, onderbrekingen. GPT-Live is gebouwd voor die realiteit. Dat verandert hoe je instructies geeft:
Begin met context in één adem — “Ik zit in project X, Python, ik wil functie Y — wacht even, ik bedoel Z” — het model volgt mee
Gebruik onderbreken als sturing — “stop, andere aanpak” werkt nu echt
Vraag om zichtbare output — “laat me een kaart zien” triggert visuele cards
Stel een stopregel — “Als je iets niet weet, zeg het hardop en zoek dan” past bij delegatie naar GPT-5.5
Test je gespreksopbouw eerst in tekst via de prompt-coach; spreek daarna dezelfde structuur in.
Sol vs Live: twee launches, één week
Donderdag kwam GPT-5.6 Sol voor developers (API/Codex). GPT-Live zit nu in ChatGPT voor consumenten. Als coach: leer klanten het verschil — Live voor gesprekken en uitleg, Sol voor code en agents zodra ze API-toegang hebben.
Companion is nu een hardwaredoel, geen relatiebelofte
Bloomberg-journalist Mark Gurman meldde op 14 juli 2026 dat OpenAI’s eerste apparaat een verplaatsbare speaker zonder scherm wordt. De gebruiker zou er een band mee moeten opbouwen als met een AI-companion. Dat is bronrapportage, geen productaankondiging van OpenAI.
Voor prompting verandert er wel iets. Als je niets terugleest, moet je opdracht zelf een controlelus bevatten:
Context: “Ik werk aan project X. Gebruik alleen de planning van vandaag.”
Opdracht: “Maak drie opties en kies er nog geen.”
Teruglezing: “Herhaal wat je gaat doen en welke informatie je bewaart.”
Stopregel: “Voer niets externs uit zonder mijn aparte ja.”
Een warme stem is geen toestemming. Geheugen, toolrechten en emotionele afhankelijkheid blijven aparte onderwerpen. Bij coaching zou ik voice voor werk en uitleg gebruiken, met schriftelijke controle voor bedragen, berichten, publicaties en andere acties die je niet makkelijk terugdraait.
Wat een schermloze interface van je prompt vraagt
Risico
Zeg dit hardop
Verkeerde context
“Noem eerst welke context je gebruikt.”
Te snelle actie
“Maak een voorstel, voer nog niets uit.”
Onduidelijk geheugen
“Gebruik dit alleen in dit gesprek en onthoud het niet.”
Misverstaan commando
“Herhaal ontvanger, bedrag en actie vóór bevestiging.”
Dat is minder soepel dan “regel het even”, maar veel bruikbaarder. Een goede voiceprompt maakt de ontbrekende visuele preview deels goed. Voor de laatste controle blijft een scherm of auditlog nodig.
Praktische use cases
Taak
Voice-tip
Code-uitleg tijdens wandeling
Vraag om stap-voor-stap; onderbreek bij onduidelijkheid
Brainstorm feature
Laat het model “mhmm” doen terwijl jij nadenkt
Research met bronnen
Vraag expliciet om web search; wacht op visuele card
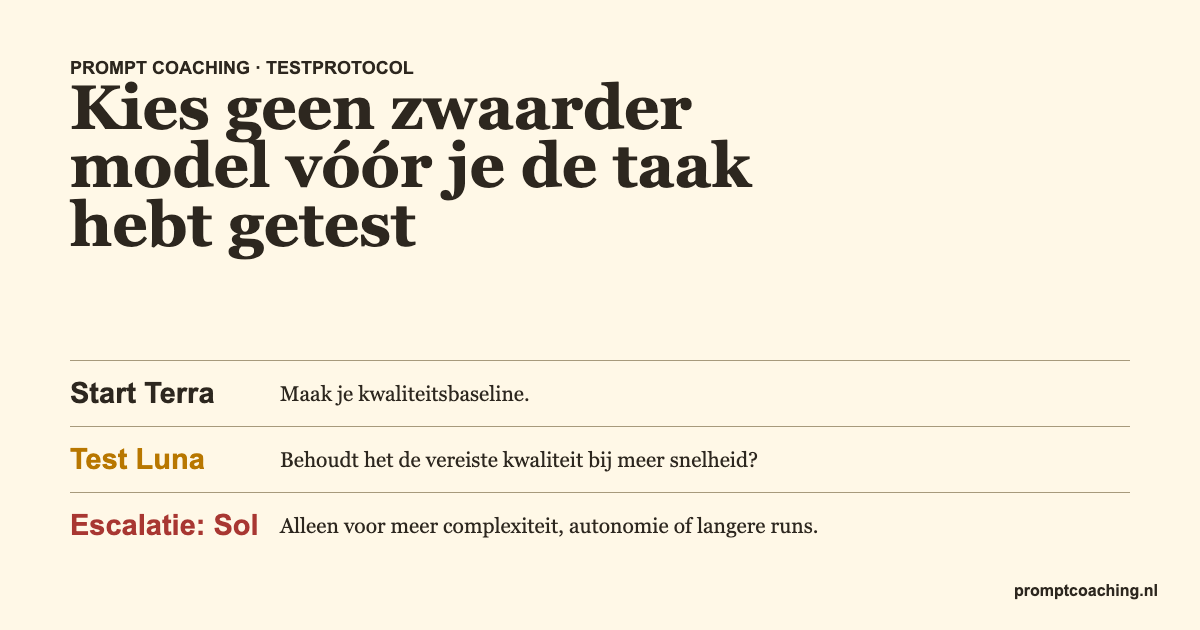
Begin niet met Sol omdat de naam het sterkst klinkt. Maak Terra met medium effort je baseline, test Luna op dezelfde voorbeelden en schakel alleen op naar Sol wanneer de opdracht meer planning, autonomie of foutcontrole vraagt.
1. BaselineDraai dezelfde taak met Terra en leg vooraf vast wat een goed antwoord moet bevatten.
2. AfschalenTest Luna zonder de prompt te versoepelen. Controleer vooral randgevallen en verplichte velden.
3. OpschalenTest Sol als Terra faalt op samenhang, lange opvolging, code of toolgebruik.
De modelkeuze die het Codex-team zelf gebruikt
Een vaste favoriet bestaat volgens Codex-productmanager Kath Koverec niet. Zij kiest op taakomvang, foutkosten en wachttijd. Haar praktische indeling uit de Reddit-AMA:
Taak
Keuze
Extra instructie
Kleine lokale wijziging, documentatie of verkenning
Lichter model, low reasoning
Vraag om één afgebakende wijziging.
Kleine bug met een duidelijke reproductie
Sol, medium reasoning
Geef de reproductiestappen en de test die moet slagen.
Onduidelijke bug, onbekende repo of brede refactor
Sol, hogere reasoning
Laat Codex eerst oorzaken onderzoeken.
Migratie, productie-incident of securitywijziging
Sol, high reasoning; Ultra alleen bij echte parallelle werkstromen
Vraag om een plan, tests en verificatiebewijs.
OpenAI beschrijft Terra als de goedkopere dagelijkse optie en Luna als de snelste, voordeligste tier. Het team wees in de AMA ook op Luna voor afgebakend verkenningswerk dat een sterkere hoofdagent aan een subagent delegeert. Dat is een gebruiksadvies, geen garantie dat dezelfde routering voor jouw repo de beste uitkomst geeft.
Geef /goal een begrensde opdracht
Codex-onderzoeker Allan Zhou gebruikt /goal wanneer een agent langer moet volhouden. Koverec gaf daarbij een nuttiger patroon dan “blijf proberen”: beperk de bestanden, bescherm de publieke API, geef een hypotheselimiet en leg vast wanneer de agent stopt.
/goal Onderzoek waarom deze flaky test faalt en probeer hem te repareren.

Scope:
- wijzig alleen packages/auth en de bijbehorende tests;
- verander de publieke API niet;
- test maximaal drie plausibele oorzaken;
- draai na iedere poging de relevante tests.

Stop als geen van de drie oorzaken klopt. Meld dan wat je hebt geleerd en welk experiment daarna het meeste informatie oplevert.
Deze grens voorkomt twee bekende problemen: een agent die door de hele repo dwaalt en een grote patch die lastig te beoordelen is.
Houd zware MCP-context bij de taak die haar nodig heeft
Een AMA-deelnemer meldde dat zijn Unreal Engine-MCP al veel gebruik kostte voordat het werk begon. Developer Experience-lead Dominik Kundel stelde twee routes voor: laat Codex de MCP via een CLI en skill ontsluiten, of hang de MCP alleen aan een gespecialiseerde subagent. Zo hoeft je hoofdagent de volledige toolbeschrijving niet bij iedere taak mee te dragen.
Voor kenniswerk geldt een ander patroon. Codex-onderzoeker Janvi Kalra noemt connectors voor Slack, GitHub en Notion een grote stap vooruit, omdat de agent dan bronnen kan lezen en resultaten kan terugschrijven. Geef zo’n agent nog steeds een bronnenlijst, schrijfgrenzen en een expliciete goedkeuringsstap.
Werkregel: kies eerst de kleinste model- en toolconfiguratie die je acceptatiecriteria haalt. Schaal pas op als de foutanalyse laat zien wat de lichtere route mist.
Gebruik één eerlijke taakset
Een losse indrukwekkende output zegt weinig. Kies vijf tot twintig voorbeelden uit het echte werk: normale gevallen, lastige uitzonderingen en invoer die vaak fouten veroorzaakt. Gebruik dezelfde context, tools en uitvoervereisten bij ieder model.
Schrijf het resultaat, niet de modelnaam
Een goede testprompt noemt doel, bronnen, grenzen, stopregels en gewenste uitvoer. Vraag niet “gebruik Sol en denk extra hard”. De modelkeuze en reasoning-instelling horen in de API-configuratie; de prompt beschrijft wat goed werk is.
Taaksucces
Is het gevraagde eindresultaat compleet en bruikbaar?
Bewijs
Zijn bronnen, aannames en onzekerheden zichtbaar waar dat nodig is?
Herstelwerk
Hoeveel menselijke correcties of extra rondes zijn nodig?
Efficiëntie
Wat zijn latency, tokens en kosten per geslaagde taak?
Pas effort pas daarna aan
OpenAI noemt medium een gebalanceerd startpunt. Low past bij latencygevoelig werk; high, xhigh en max horen alleen bij taken waar je evaluatie een echte kwaliteitswinst laat zien. Test bij een migratie ook één effortniveau lager: GPT-5.6 kan dezelfde kwaliteit soms met minder tokens halen.
Let op met “wees kort”
De GPT-5.6-gids waarschuwt dat algemene instructies als “wees beknopt” de taakprioriteit kunnen veranderen. Schrijf liever: leid met de conclusie, behoud alle vereiste feiten en schrap herhaling en optionele achtergrond eerst.
Gebruik een stopregel in iedere test
Laat het model expliciet melden wanneer een bron ontbreekt, een claim niet controleerbaar is of de uitvoer buiten het gevraagde schema valt. Tel zo’n nette stop niet automatisch als mislukking: bij risicovol werk kan weigeren beter zijn dan een overtuigende gok. Vergelijk vervolgens hoe vaak iedere tier terecht stopt, onnodig stopt of toch ongefundeerd doorgaat. Dat maakt de keuze veel betrouwbaarder dan alleen een stijlscoresheet.
Keuzeregel: houd de goedkoopste configuratie die de volledige scorekaart consequent haalt. Niet de goedkoopste losse API-call.
Mijn veilige standaard voor Codex: eerst begrenzen, daarna pas opschalen
Begin een normale codingtaak met Sol op medium of high. Zet Fast, max of Ultra pas aan als je kunt aanwijzen welk probleem de standaardinstelling niet oplost. Dat scheelt meer dan blind een lichter model kiezen, omdat een sterke agent met een te brede opdracht alsnog uren context, tools en herstelrondes kan verbruiken.
Werk
Praktische start
Wanneer opschalen?
Kleine fix, documentatie, afgebakende review
Sol medium
Pas als de eerste poging een concreet randgeval mist.
Max alleen wanneer extra onderzoek aantoonbaar betere oorzaken of tests oplevert.
Vier onafhankelijke onderzoekslijnen
Ultra kan passen
Alleen als de taak echt in parallelle delen uiteenvalt en je de extra tokeninzet accepteert.
Ultra is geen reasoningniveau. OpenAI beschrijft het als een aparte modus die standaard vier agents parallel inzet en bewust meer tokens ruilt voor een kortere doorlooptijd en soms een sterker resultaat. Eén kleine bug vier keer laten onderzoeken is dus geen gratis kwaliteitsknop.
Fast is een snelheidskeuze, geen intelligentiekeuze
Fast laat een ondersteund model sneller antwoorden tegen een hoger credittarief. De officiële Codex-documentatie noemt op 12 juli 2026 GPT-5.5 en GPT-5.4 als ondersteunde modellen: respectievelijk 2,5 en 2 keer het standaardtarief. GPT-5.6 staat daar nog niet bij. Controleer daarom met /fast status wat jouw client werkelijk gebruikt in plaats van een multiplier uit een social post over te nemen.
Zet de subagentrem in je globale AGENTS.md
Sol kan lang zelfstandig doorwerken. Dat is prettig bij een duidelijke taak en duur bij een vage. Als je niet wilt dat iedere brede opdracht automatisch vertakt, leg die keuze één keer globaal vast:
Start alleen subagents als ik daar expliciet om vraag.
Gebruik dan het kleinste aantal dat de gevraagde parallelle taken afdekt.
De regel verbiedt parallel werk niet. Hij zorgt dat jij de kostenbeslissing neemt. Vraag bijvoorbeeld om twee subagents voor twee onafhankelijke libraries, maar niet om “een team” voor een wijziging die één gedeelde functie raakt.
Schrijf het stopmoment alsof het een acceptatiecriterium is
Een goede prompt zegt niet alleen wat Codex moet bereiken, maar ook waar deze beurt eindigt. Dat voorkomt dat planning ongemerkt overgaat in bouwen, deployen en nog een reviewronde.
Onderzoek de bug en schrijf een plan met maximaal drie plausibele oorzaken.
Stop na het plan en wacht op feedback. Wijzig nog geen bestanden.
Voor een uitvoerende opdracht mag de grens verder liggen:
Implementeer de afgesproken fix en draai de relevante tests.
Maak geen PR en deploy niets. Stop zodra de tests groen zijn of nadat
twee verschillende reparatiepogingen dezelfde blocker geven.
“Blijf doorgaan tot alles werkt” is soms precies goed. Schrijf er dan bij welke tests tellen, welke bestanden buiten scope liggen en welke externe actie toestemming vereist.
De zuinigste Codex-taak is meestal de best afgebakende taak
Modelkeuze telt, maar contextdiscipline telt iedere beurt opnieuw. Geef alleen relevante bestanden, knip logs terug tot de eerste fout en zet beslissingen in een issue of kort projectbestand. Start een nieuwe taak wanneer onderzoek, implementatie en productiecontrole verschillende bronnen nodig hebben. Combineer dit bij lange sessies met de 240K-compactiebuffer verderop op deze pagina.
Deze pagina is gecontroleerd aan de hand van de officiële OpenAI-modelgids voor GPT-5.6 en de aankondiging van OpenAI Developers van 9 juli 2026. OpenAI positioneert Sol, Terra en Luna voor verschillende taakvormen. Prestaties, latency en kosten blijven workload-afhankelijk; test daarom met eigen representatieve taken. De modelnamen gaan over de API en zeggen niet automatisch welke modellen in ieder ChatGPT-abonnement zichtbaar zijn.
Toegevoegd op 11 juli 2026: adviezen uit de Reddit-AMA met het OpenAI Codex-team. Uitspraken over persoonlijke modelkeuze en toekomstige verbeteringen zijn teamadviezen of voornemens, geen productgaranties.
Voorkom dat een lange Codex-taak onnodig in het duurdere contexttarief valt
GPT-5.6 Sol heeft ruimte voor 1,05 miljoen tokens, maar meer context is niet gratis. OpenAI rekent bij meer dan 272.000 inputtokens twee keer het inputtarief en anderhalf keer het outputtarief voor het volledige verzoek.
Laat Codex daarom bij lange codingtaken eerder compacten. Voeg dit toe aan ~/.codex/config.toml:
De 240K-grens geeft ruimte voor toolresultaten, systeemprompts en de compactiesamenvatting. OpenAI schrijft deze waarde niet voor en de uiteindelijke requestgrootte kan afwijken. Bewaar acceptatiecriteria en belangrijke foutmeldingen in bestanden of een issue, want compactie kan details samenvatten.
Wat kost GPT-5.6 Sol via de API?
Normaal
Boven 272K input
Input per 1M
$5
$10
Cached input
$0,50
$1
Output per 1M
$30
$45
Korte taken worden hiermee niet goedkoper. Gebruik voor een nieuwe werkfase liever een nieuwe taak dan maanden aan irrelevante geschiedenis mee te dragen.
Er bestaat geen magisch toverwoord. Maar er is wél een perfecte prompt-formule: een vaste set ingrediënten die je telkens opnieuw invult. Vul je ze allemaal in, dan krijg je een bruikbaar antwoord — of je nu ChatGPT, Claude of Gemini gebruikt. Laat je er een paar weg, dan moet het model gokken, en gokken levert vage rommel op.
Ik leer mensen prompten met de KOMPAS-methode: Kader, Opdracht, Materiaal, Paalwerk, Afwerking, Sturing. Zes ingrediënten, in deze volgorde. Hieronder loop ik ze één voor één langs, met een voorbeeld dat je meteen kunt kopiëren.
Waarom een formule beter werkt dan inspiratie
De meeste mensen typen één regel en hopen op het beste. Het model leest die regel, vult zelf de gaten in en raadt wat je bedoelt. Soms gaat dat goed. Vaak niet — en dan ga je eindeloos bijsturen.
Een formule haalt dat gokwerk eruit. Je geeft het model alles wat het nodig heeft om in één keer raak te schieten: wie het is, wat het moet doen, waar het mee moet werken en hoe het antwoord eruit moet zien. Niet omdat het model dom is, maar omdat het niet in je hoofd kan kijken. Wil je dieper in de principes duiken, lees dan ook mijn gids over betere prompts schrijven.
De 6 ingrediënten van KOMPAS
Stel je voor: je wilt een wervende productbeschrijving voor een duurzame waterfles. Zo bouw je die prompt op.
1. Kader — geef het model een rol en context
Begin met wie het model moet zijn en in welke situatie. “Je bent een copywriter voor een webshop in duurzame producten.” Een rol stuurt de toon, het woordgebruik en de aannames. Zonder rol krijg je een gemiddelde, smaakloze tekst.
2. Opdracht — zeg precies wat je wilt
Eén heldere taak, zonder omhaal. “Schrijf een productbeschrijving voor een herbruikbare RVS-waterfles.” Gebruik een werkwoord: schrijf, vergelijk, vat samen, herschrijf. Vaag werkwoord = vaag antwoord.
3. Materiaal — lever de feiten aan
Dit is het ingrediënt dat de meeste mensen overslaan, en juist het belangrijkste. Geef het model de bouwstenen: kenmerken, doelgroep, voorbeelden, cijfers. “De fles houdt drank 12 uur warm, is lekvrij en gemaakt van gerecycled staal. Doelgroep: forensen tussen 25 en 40.” Verzint het model anders zelf details, dan klopt er weinig van.
4. Paalwerk — zet de grenzen neer
Wat mag wel, wat mag niet. “Maximaal 120 woorden. Geen superlatieven. Niet over de prijs.” Grenzen voorkomen dat het antwoord alle kanten op waaiert. Hoe scherper de palen, hoe voorspelbaarder het resultaat.
5. Afwerking — bepaal de vorm
Hoe moet het antwoord eruitzien? “Geef een pakkende kop, daarna drie korte alinea’s, en sluit af met één call-to-action.” Vraag je niet om een vorm, dan krijg je de standaardvorm van het model — en die past zelden precies.
6. Sturing — vraag om bijstellen
De laatste regel die alles verandert: “Vraag eerst of er informatie ontbreekt voordat je begint.” Of: “Geef twee varianten met een andere toon.” Zo bouw je controle in en blijf je niet vastzitten aan één poging.
Werkt deze formule overal hetzelfde?
De zes ingrediënten zijn universeel — ze gelden voor tekst, beeld én code. Bij prompt engineering voor vibe coding in tools als Cursor of Lovable is het Materiaal je bestaande code en je gewenste gedrag, en is het Paalwerk vaak een technische beperking (“gebruik geen externe libraries”). Bij beeld of video met tools als Midjourney of Veo verschuift het zwaartepunt naar Afwerking: stijl, compositie, sfeer.
De modellen verschillen in hoe ze reageren. De ene volgt instructies strakker, de andere vult creatiever in. Maar de formule blijft hetzelfde. Je leert vooral door te variëren: verander één ingrediënt, kijk wat er gebeurt, stel bij. Dat is het hele vak.
Begin klein: vul niet alles tegelijk in
Je hoeft niet meteen alle zes ingrediënten perfect te hebben. Begin met de drie die het meeste verschil maken: Opdracht, Materiaal en Afwerking. Een heldere taak, genoeg feiten en een duidelijke vorm brengen je al ver. Kader en Paalwerk voeg je toe zodra het antwoord net niet klopt. En Sturing gebruik je om bij te schaven.
Twijfel je of je prompt compleet is? Plak hem in mijn gratis prompt-coach tool. Die scoort je prompt op de zes ingrediënten en herschrijft hem direct, zodat je ziet wat er ontbrak.
Veelgestelde vragen
Werkt de perfecte prompt-formule in elk AI-model?
Ja. De zes ingrediënten van KOMPAS gelden voor ChatGPT, Claude, Gemini en de meeste andere modellen. Modellen reageren onderling iets anders, maar de structuur — rol, taak, feiten, grenzen, vorm en sturing — werkt overal. Je past hooguit het accent aan.
Welk ingrediënt vergeten mensen het vaakst?
Materiaal. De meeste mensen geven een taak zonder feiten, waardoor het model zelf details verzint. Lever altijd de bouwstenen aan: kenmerken, doelgroep, voorbeelden. Dat ene ingrediënt maakt vaak het verschil tussen een gokje en een bruikbaar antwoord.
Hoe lang moet een goede prompt zijn?
Zo lang als nodig, niet langer. Een prompt met alle zes ingrediënten is meestal een paar zinnen tot een korte alinea. Niet de lengte telt, maar of elk ingrediënt ingevuld is. Opvulling helpt niet — duidelijkheid wel.
Kan ik leren om dit sneller te doen?
Zeker. Met oefening wordt de formule een automatisme. Wil je het versneld onder de knie krijgen, dan kan dat in een coachingstraject — in groepsverband of privé — waarin we met jouw eigen voorbeelden werken.
Klaar om het te proberen? Test je volgende prompt gratis in de prompt-coach, of bekijk de gidsen voor meer voorbeelden. Wil je het echt onder de knie krijgen met persoonlijke begeleiding, kijk dan naar de coaching — groep of privé.
Deze Cursor uitleg is voor iedereen die wel eens hoort dat je “met AI kunt programmeren”, maar niet weet waar je moet beginnen. Cursor is een code-editor met een ingebouwde AI-assistent. Je beschrijft in gewone taal wat je wilt, en de editor schrijft, wijzigt of legt code voor je uit. Je hoeft geen ervaren developer te zijn om er iets mee te bouwen, maar je moet wel leren hoe je hem aanstuurt.
Het korte antwoord: Cursor is een werkomgeving waarin jij de regie houdt en de AI het typewerk doet. Hoe duidelijker jouw opdracht, hoe bruikbaarder het resultaat. Daar zit de hele truc.
Wat is Cursor precies?
Cursor is een editor om software in te schrijven, vergelijkbaar met de bekende editor VS Code, maar met AI direct ingebouwd. In plaats van dat je elke regel zelf typt, kun je de assistent vragen om een functie te maken, een bug op te sporen of bestaande code aan te passen. De AI ziet je projectbestanden en kan over meerdere bestanden tegelijk meedenken.
Belangrijk om te snappen: Cursor verzint niet zomaar een hele app uit het niets. Het werkt het best als jij het stap voor stap stuurt. Jij blijft de ontwerper; de AI is je snelle, soms eigenwijze assistent die je voorstellen geeft die je goedkeurt of afwijst.
De eerste stappen in Cursor
Je begint met het downloaden en installeren van Cursor, waarna je een nieuw of bestaand project opent. Vanaf daar werk je grofweg met drie manieren om de AI in te zetten:
Chat — je stelt een vraag of geeft een opdracht in een gesprek naast je code, handig om iets uit te leggen of een plan te maken.
Inline bewerken — je selecteert een stuk code en vraagt om een specifieke wijziging op die plek.
Voorstellen accepteren of afwijzen — Cursor laat zien wat het wil veranderen, en jij beslist of het zo blijft.
Mijn advies: begin klein. Vraag eerst om één duidelijke wijziging, kijk wat eruit komt, test het, en ga pas dan verder. Grote vage opdrachten (“bouw een webshop”) leveren rommel op. Kleine, concrete stappen leveren iets werkends op.
Waarom je prompt het verschil maakt
De meeste frustratie met Cursor komt niet door de tool, maar door onduidelijke instructies. De AI raadt wat je bedoelt als je het zelf niet vertelt. Daarom werk ik met de KOMPAS-methode: een goede prompt is je kompas. Voor Cursor betekent dat concreet:
Kader — vertel wat voor project het is en welke taal of techniek je gebruikt.
Opdracht — zeg exact wat je wilt, in één heldere zin.
Materiaal — wijs naar de relevante bestanden of code.
Paalwerk — geef de grenzen: wat mag de AI niet aanraken?
Afwerking — vertel hoe het resultaat eruit moet zien.
Sturing — corrigeer en verfijn na het eerste resultaat.
Wil je weten of jouw instructie sterk genoeg is? Plak hem in de gratis prompt-tool. Die geeft een score en herschrijft je prompt zodat Cursor minder hoeft te raden. Verder lezen over de aanpak kan via de gidsen.
Past Cursor bij jou?
Cursor is sterk als je iets wilt bouwen en al een idee hebt van hoe code werkt, of bereid bent dat al doende te leren. Wil je puur snel een prototype klikken zonder veel code te zien, dan zijn er andere gereedschappen die daar beter op gericht zijn. Een overzicht daarvan vind je in mijn artikel over vibe coding tools.
Ben je nieuw met deze manier van werken? Begin dan bij de basis van vibe coding leren, zodat je snapt hoe je met AI samenwerkt voordat je in Cursor duikt. Daarna val je in Cursor veel minder vaak terug op trial-and-error.
Wat kost Cursor?
Je kunt gratis beginnen. Het Hobby-plan kost niets en is prima om te proeven: je krijgt een beperkt aantal AI-aanvragen en een korte proefperiode van de betaalde functies. Loop je tegen de limieten aan, dan is er een Pro-abonnement van zo’n 20 dollar per maand met ruimere limieten en sterkere modellen. Prijzen en limieten schuiven regelmatig; check de actuele bedragen op cursor.com voordat je beslist.
Mijn advies: start gratis en upgrade pas als je de limieten echt raakt. Voor een avondje proberen is betalen zonde; bouw je er wekelijks mee, dan verdient Pro zichzelf snel terug in tijd.
Waar Cursor tegenvalt
Cursor heeft ook vervelende kanten. Drie dingen waar je tegenaan loopt:
De AI bouwt soms te veel. Vraag je om één knop, dan krijg je er soms een half nieuw menu bij. Daarom werkt Paalwerk uit de KOMPAS-methode zo goed: zeg expliciet wat er niet aangeraakt mag worden.
Grote projecten worden traag en duur. Hoe meer bestanden de AI moet meelezen, hoe trager het wordt en hoe sneller je door je limieten heen bent. Wijs dus gericht naar de bestanden die ertoe doen.
Je moet kunnen beoordelen wat eruit komt. Cursor levert overtuigend ogende code, ook als die niet klopt. Zonder testen merk je dat pas als iets stukgaat.
Veelgestelde vragen
Heb ik programmeerervaring nodig voor Cursor?
Niet per se, maar het helpt enorm. Je hoeft niet vloeiend te kunnen coderen, maar je moet wel kunnen lezen wat de AI voorstelt en beslissen of het klopt. Hoe meer je begrijpt, hoe beter je stuurt.
Schrijft Cursor een hele app voor me?
Niet in één klik. Cursor werkt het best als jij het opdeelt in kleine stappen en elke stap controleert. Vage opdrachten leveren onbruikbare code op; concrete opdrachten leveren iets werkends op.
Wat is het verschil tussen Cursor en gewoon ChatGPT?
ChatGPT staat los van je project. Cursor zit in je code-editor, ziet je bestanden en kan wijzigingen direct op de juiste plek voorstellen. Dat scheelt veel knip- en plakwerk en fouten.
Hoe voorkom ik dat de AI verkeerde dingen aanpast?
Wees specifiek over wat wel en niet mag veranderen, en wijs naar de juiste bestanden. Test na elke stap. Een scherpe prompt voorkomt de meeste ongelukken.
Is Cursor gratis?
Er is een gratis Hobby-plan met beperkte AI-aanvragen, genoeg om te ontdekken of het bij je past. Wil je serieus bouwen, dan zit je al snel op het Pro-abonnement van ongeveer 20 dollar per maand. De actuele prijzen staan op cursor.com.
Cursor of Claude Code: wat kies ik?
Cursor is een visuele editor waarin je meekijkt en klikt; Claude Code werkt vanuit de terminal en is sterker in zelfstandig grotere klussen afwerken. Begin je net, dan is Cursor toegankelijker. Werk je liever helemaal zonder code, vergelijk dan Cursor met Lovable en Bolt.
Wil je dat Cursor doet wat je bedoelt in plaats van wat je toevallig typte? Test je instructie gratis in de prompt-coach, of leer het in één sessie goed aan via mijn coaching — in een groep of privé.
Deze korte video zet de workflow in minder dan een minuut scherp.
AI kan prima helpen met programmeren, maar alleen als jij de volgorde en de controlepunten bepaalt. Laat een model niet meteen “de feature bouwen”. Dwing het eerst langs data, interfaces, todo’s, een proefimplementatie, invarianten en pas daarna de echte wijziging. Dat is trager in de eerste vijf minuten, maar voorkomt dat je een halve dag code zit terug te draaien.
AI-assisted software development in de praktijk
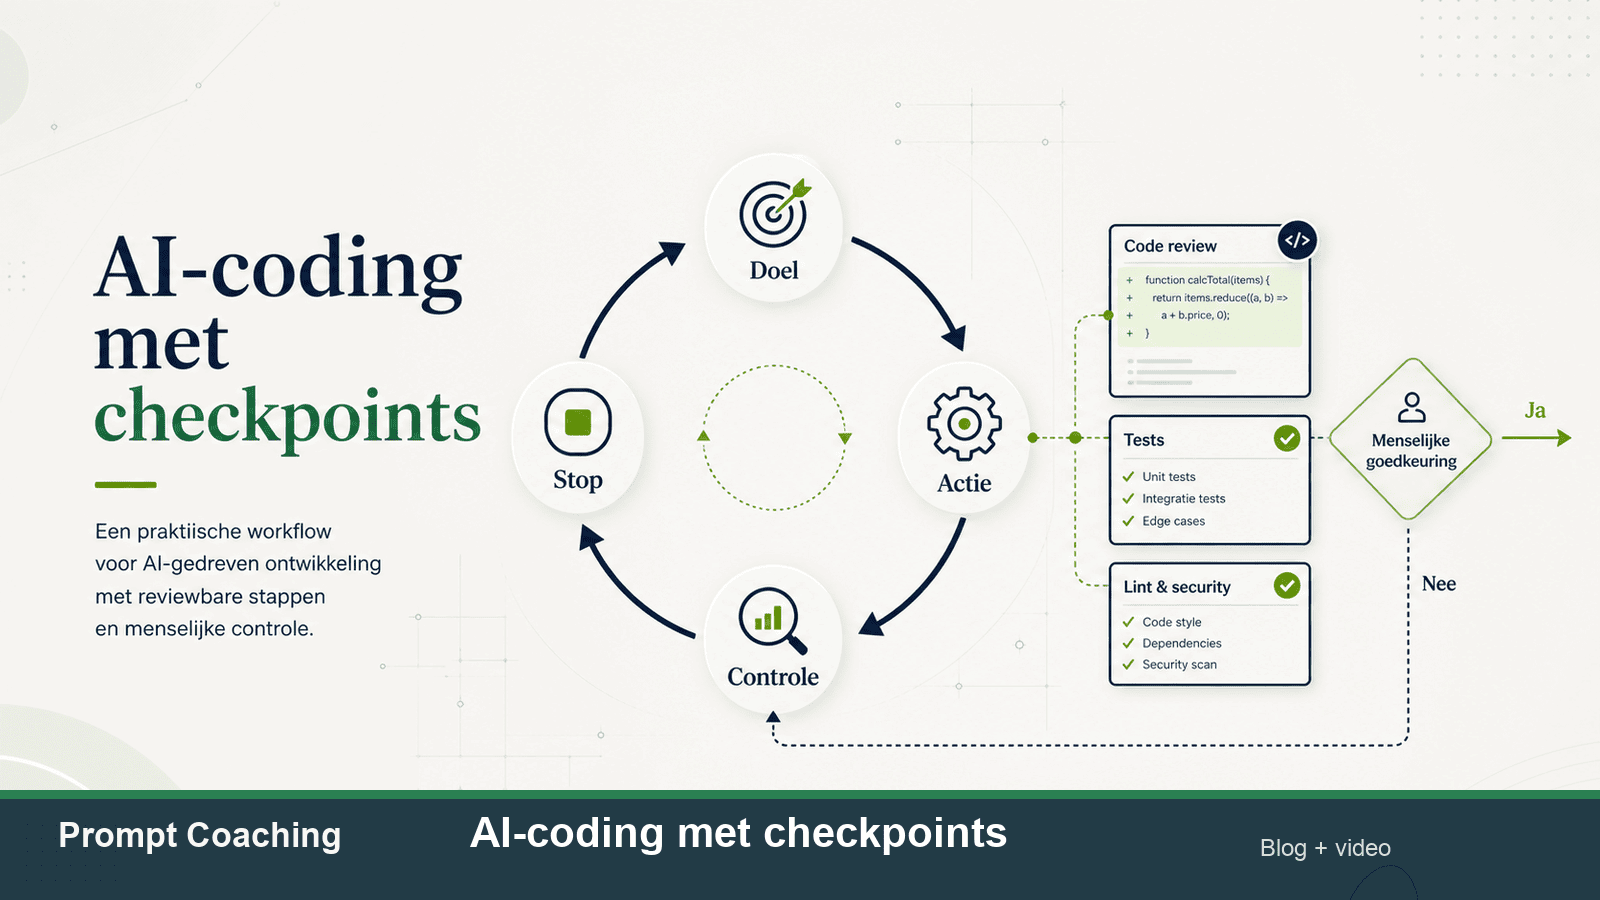
Hoe werkt dat concreet? Je geeft een AI-agent niet één grote opdracht maar een reeks kleine, gecontroleerde stappen: eerst laat je hem het datamodel en de interfaces voorstellen, dan een proefimplementatie met tests, en pas daarna de echte wijziging in je codebase. Na elke stap controleer jij het resultaat met de checkpoints uit dit artikel. Zo blijft AI-assisted software development een cyclus van opdracht, bewijs en controle, in plaats van een hoopvol “bouw maar” waar je daarna uren tegenaan praat.
De nieuwe workflow uit de Primeagen-video is interessant omdat hij niet verkoopt dat AI de programmeur vervangt. Het punt is scherper: als je onderweg bent, op je telefoon zit of even geen diepe focus hebt, kun je nog steeds vooruitgang boeken zolang de agent niet vrij door je codebase mag rennen.
Update 16 juli 2026: Moonshot AI noemt bij Kimi K3 precies de twee risico’s waarvoor deze checkpointworkflow bedoeld is. Als eerdere denkgeschiedenis niet volledig wordt teruggegeven, kan de kwaliteit instabiel worden. En als je grenzen vaag laat, kan het model te proactief worden en onverwachte beslissingen namens jou nemen.
Wat Kimi K3 aan deze workflow toevoegt
Een groot contextvenster lost geen onduidelijke opdracht op. K3 kan 1 miljoen tokens meenemen, maar de agent moet nog steeds weten welke context bindend is, welk bewijs telt en wanneer hij stopt. Voeg daarom vóór de bestaande zes checkpoints een history-gate toe.
Taak: staat de oorspronkelijke opdracht nog volledig in de sessie?
Besluiten: zijn alle menselijke akkoorden en afwijzingen bewaard?
Bewijs: staan relevante testresultaten, diffs en screenshots in de geschiedenis?
Modelcontinuïteit: is deze run met K3 begonnen, of probeer je midden in een andere modelsessie over te stappen?
Pas als dat klopt, ga je naar structs, interfaces en de andere checkpoints hieronder.
Bekijk de uitleg in 22 seconden
De kern van dit artikel, met een eigen Nederlandse voice-over en captions.
Promptblok voor context, bewijs en stopgrenzen
Behoud binnen deze run de volledige taakgeschiedenis:
opdracht, besluiten, tooloutput, testbewijs en open risico's.

Ga niet verder als vereiste geschiedenis ontbreekt.
Wissel niet halverwege van model zonder een nieuwe intake.

Werk per fase:
1. doel en non-goals;
2. kleinste veilige actie;
3. objectief bewijs;
4. rapportage;
5. wacht op akkoord als de volgende stap extern, publiek,
   financieel, destructief of lastig terug te draaien is.

Bij ambiguïteit: stel één gerichte vraag.
Neem geen onverwachte beslissing namens mij.
Het belangrijke verschil zit in de laatste twee regels. “Wees proactief” is geen bruikbare toestemming. Zeg waar initiatief gewenst is en waar de agent moet stoppen. Een model mag zelf relevante bestanden zoeken; het mag niet zelf besluiten een productieomgeving te wijzigen of iets te publiceren.
Gebruik vision als bewijs, niet als vervanging van tests
K3 heeft native vision. Bij web- en appwerk kan de agent daardoor een render of screenshot bekijken en daarna de code aanpassen. Dat is nuttig voor layout, visuele regressies en interfaces.
Combineer die visuele check met een echte test. Een pagina kan er goed uitzien terwijl de knop niet werkt. Een test kan slagen terwijl de mobiele tekst buiten beeld valt. Vraag daarom per fase om beide soorten bewijs wanneer de wijziging een interface raakt.
Moonshots eigen advies is opvallend direct: zet expliciete gedragsgrenzen in je system prompt of AGENTS.md. Dat maakt K3 geen speciaal geval. Het bevestigt een algemene regel voor AI-coding: meer autonomie vraagt om betere context, kleinere bewijsstappen en een hardere stop.
De bruikbare vorm is simpel genoeg om morgen te gebruiken:
Structs: welke data verandert of komt erbij?
Interfaces: welke functies of API’s moeten bestaan?
Todo’s: waar in de code moet straks iets gebeuren?
Proefimplementatie: implementeer, test, draai terug en rapporteer waar het plan niet klopte.
Invarianten: welke regels mogen na de wijziging nooit breken?
Implementatie: pas nu mag de echte diff blijven staan.
Het slimme zit vooral in stap vier. Een model dat eerst moet implementeren en daarna uitleggen waar het buiten het plan moest treden, geeft je informatie terug. Je ziet niet alleen de code, maar ook waar je ontwerp nog gaten heeft.
Waarom dit beter werkt dan “bouw deze feature”
Een algemene opdracht dwingt het model om te gokken. Het maakt dan zelf keuzes over data, naamgeving, locatie, teststrategie en randgevallen. Soms gaat dat goed. Vaak krijg je code die werkt in de demo, maar vreemd voelt in de codebase.
Met checkpoints houd je eigenaarschap. Je keurt eerst het datamodel. Daarna pas de interface. Daarna pas de lijst met plekken waar code verandert. Als één stap niet klopt, ga je niet door. Dat klinkt streng, maar het is precies hoe je voorkomt dat AI “bijna goede” code overal verspreidt.
Een goede AI-coding prompt
Gebruik niet één grote opdracht. Gebruik een fasering zoals deze:
We werken in checkpoints. Ga pas naar de volgende fase als ik akkoord geef.

Fase 1: beschrijf alleen de benodigde data structures.
Geen implementatie.

Fase 2: beschrijf alleen de functies/interfaces die moeten veranderen.
Geen implementatie.

Fase 3: zet per bestand concrete todo's neer.
Leg uit waarom elke todo nodig is.

Fase 4: maak een proefimplementatie, run de kleinste nuttige check,
draai de wijziging terug en rapporteer waar je buiten de todo's moest werken.

Fase 5: formuleer invarianten die na de wijziging waar moeten blijven.

Fase 6: implementeer pas na akkoord.
Dat is niet spectaculair. Dat is juist de waarde. Je haalt de agent uit de demo-stand en zet hem in een werkritme dat reviewbaar blijft.
De testlaag: laat AI iets echts controleren
In de video zit een goed detail: de game heeft een JSON-modus waarmee acties kunnen worden afgespeeld zonder de normale renderlaag. Dat is voor AI-coding belangrijker dan het klinkt. Een agent kan pas zinnig doorwerken als hij een snelle, objectieve feedbacklus heeft.
Voor een webapp kan dat een Playwright-check zijn. Voor een CLI een command met vaste output. Voor een game een headless simulatie. Voor een contentworkflow een publicatiegate. De vorm maakt minder uit dan de eigenschap: het resultaat moet controleerbaar zijn zonder dat jij elke regel handmatig hoeft te bekijken.
Wanneer je juist zelf moet typen
Niet elk programmeerprobleem is goed in taal te vangen. Sommige wijzigingen zijn voor een ontwikkelaar in tien minuten duidelijker te typen dan in vijf prompts uit te leggen. Herken dat moment. AI is slecht in problemen waar de nuance in lokale codevorm, laagverdeling of interactievolgorde zit.
Een goede workflow laat je dus niet minder programmeren. Hij laat je beter kiezen wanneer je programmeert, wanneer je laat voorbereiden en wanneer je een agent terugstuurt naar de vorige fase.
Praktische regel voor Promptcoaching
Als je AI inzet voor code of automatisering, vraag dan nooit alleen om output. Vraag om een route, een controlepunt en een stopregel. Dat sluit aan op de stap van losse prompts naar gedelegeerde AI-taken: het model krijgt werk, maar jij houdt de beslissing wanneer het goed genoeg is.
Wil je je eigen opdracht aanscherpen voordat je hem aan Cursor, Codex of Claude geeft? Gebruik dan de gratis Prompt Coach en laat vooral controleren of je prompt een duidelijke fase, bewijs en stopregel bevat.
Kort antwoord vooraf: Lovable is sterk als je snel een werkend prototype of een eenvoudige web-app uit een beschrijving wil toveren, en zwak zodra je project complex, eigenzinnig of productierijp moet worden. Deze Lovable review gaat niet over hypes, maar over wat je er praktisch mee kunt — en waar je beter een andere route kiest.
Belangrijker dan de tool zelf is hoe je hem aanstuurt. Vibe coding voelt als magie tot het misgaat, en dan blijkt: de tool deed precies wat je vroeg, alleen vroeg je het verkeerd. Daar zit de echte winst.
Wat Lovable is en hoe het werkt
Lovable is een AI-tool die op basis van een beschrijving in gewone taal een web-app voor je bouwt. Je typt wat je wil, de tool genereert de code en een werkende interface, en je stuurt bij door verder te praten. Geen lege editor, geen boilerplate — je begint meteen met iets dat draait.
De aanpak is conversationeel: je beschrijft een wijziging, Lovable past de app aan, jij beoordeelt het resultaat. Dat maakt de drempel laag, ook als je weinig of geen programmeerervaring hebt. De keerzijde: hoe vager je vraag, hoe meer de tool zelf invult — en die aannames kloppen lang niet altijd met wat jij in je hoofd had.
Waar Lovable echt goed in is
Er zijn situaties waarin Lovable je uren werk bespaart. Een paar die er in de praktijk uitspringen:
Prototypes en concepten. Een idee snel zichtbaar maken om te testen of het hout snijdt, voordat je er serieus tijd in steekt.
Eenvoudige web-apps. Een formulier, een dashboard, een landingspagina met wat interactie — dat soort werk komt snel van de grond.
Leren door te doen. Je ziet meteen wat een instructie oplevert, wat het een prettige manier maakt om te begrijpen hoe apps in elkaar zitten.
Iteratief bijschaven. Kleine wijzigingen vragen en direct het effect zien werkt soepel, zolang je scope helder blijft.
De rode draad: hoe duidelijker en begrensder je vraag, hoe beter het resultaat. Een scherpe omschrijving van wat je wil verslaat tien vage prompts achter elkaar.
Prompt
Controleerbare uitkomst
Maak een afspraakformulier
Verplichte velden, bevestiging en één aanvraag in beheer
Voeg een account toe
Een gebruiker kan gegevens van een ander niet lezen
Publiceer de app
De eigen URL werkt direct en na verversen, ook op mobiel
Acceptatiecriteria voor je eigen proef, geen testuitslag van jouw app.
Waar je tegen grenzen aanloopt
Geen enkele AI-builder is een wondermiddel, en eerlijk zijn hoort bij een goede review. Let op deze punten:
Complexe logica. Zodra je app veel onderlinge afhankelijkheden, randgevallen of fijne regels krijgt, gaan er dingen kapot die je daarvoor al werkend had.
Eigenzinnige eisen. Wijkt je idee sterk af van standaardpatronen, dan moet je veel sturen — en soms zelf in de code duiken.
Onderhoud op termijn. Code die je niet zelf hebt geschreven en niet begrijpt, wordt lastig te onderhouden. Zonder enig overzicht raak je het spoor bijster.
Productierijp maken. Beveiliging, schaalbaarheid en betrouwbaarheid vragen kennis die de tool niet voor je invult. Een werkend prototype is niet hetzelfde als iets dat je op duizenden gebruikers loslaat.
Dit zijn geen redenen om Lovable links te laten liggen. Het zijn redenen om te weten wanneer je overstapt op een andere tool of een ontwikkelaar erbij haalt. Wil je de bredere afweging zien, lees dan de vergelijking in vibe coding tools.
Eén grens die vaak pas na de lancering opvalt: de SEO-basis van gegenereerde sites. Titles, meta descriptions en interne links staan er zelden goed in. Doe daarom vóór je live gaat een SEO-check voor Lovable-output, dan weet je wat je nog moet rechtzetten.
Wil je vóór je eerste bouwopdracht zien wat het platform doet? De uitleg wat is Lovable zet de bouwstappen naast een eigen analyse van 548 galerijprojecten. Gebruik de acceptatietabel om je prompt te toetsen op een werkende uitkomst.
Hoe je met betere prompts meer uit Lovable haalt
Het verschil tussen frustratie en flow zit zelden in de tool — het zit in je instructie. Een paar gewoontes die meteen helpen:
Werkwijze
Opdracht aan Lovable
Geef context.
Vertel voor wie de app is, wat het doel is en wat absoluut niet mag breken. De tool gokt minder als je meer kaders geeft.
Werk in stappen.
Vraag één duidelijke wijziging per keer, niet vijf tegelijk. Zo zie je precies waar iets misgaat.
Beschrijf het gewenste resultaat, niet alleen het probleem.
“Maak de knop rechtsboven, blauw, en koppel hem aan opslaan” werkt beter dan “verbeter de knop”.
Bewaak wat al werkt.
Benoem expliciet wat overeind moet blijven, anders sloopt een nieuwe instructie zomaar iets ouds.
Met mijn KOMPAS-methode breng je precies die onderdelen op orde: Kader, Opdracht, Materiaal, Paalwerk, Afwerking en Sturing. Een goede prompt is je kompas — zeker bij vibe coding, waar één onhandige zin een hele middag kan kosten. Wil je dit echt onder de knie krijgen, dan helpt vibe coding leren je verder dan trial-and-error. Of test je prompts direct in de gratis prompt-coach: die scoort je prompt en herschrijft hem voor je.
Past Lovable bij jouw project?
Vraag
Afweging
Is Lovable geschikt voor beginners zonder programmeerkennis?
Ja, voor eenvoudige projecten en prototypes is de drempel laag — je beschrijft wat je wil in gewone taal. Zodra je app complexer wordt, helpt enig technisch inzicht wel om de tool goed te sturen en problemen te herkennen.
Kan ik met Lovable een echte, productierijpe app bouwen?
Voor prototypes en kleine apps prima. Voor iets dat veel gebruikers, beveiliging en betrouwbaarheid aankan, heb je extra kennis nodig — of een ontwikkelaar die het werk afmaakt. Zie het als een sterke start, niet als het volledige eindproduct.
Waarom doet Lovable niet wat ik vraag?
Meestal omdat de vraag te vaag is of te veel ineens omvat. De tool vult dan zelf aannames in. Werk in kleine stappen, geef context en benoem wat niet mag veranderen. Daar wint je resultaat het meest mee.
Hoe weet ik of Lovable de juiste tool is voor mijn project?
Kijk naar complexiteit en hoe afwijkend je eisen zijn. Standaard en overzichtelijk: Lovable is een goede keuze. Eigenzinnig en complex: overweeg een andere tool of haal hulp erbij. De vergelijking in vibe coding tools helpt je kiezen.
Wil je dat Lovable doet wat jij bedoelt in plaats van wat je toevallig typt? Test je prompt gratis in de prompt-coach, of boek coaching en leer in één sessie hoe je met de KOMPAS-methode grip krijgt op vibe coding.
De eenheid van AI-werk verschuift van een los bericht naar een gedelegeerde taak — en daarmee verandert wat je moet kunnen.
OpenAI’s data: in mei 2026 gaf 70,2% van de gebruikers een opdracht van 1+ uur mensenwerk; binnen OpenAI loopt 99,8% van de output via de agent.
Goede prompt coaching gaat nu over afbakenen, context geven en beoordelen — niet over slimme zinnetjes.
Het goede nieuws: dit is een vaardigheid die je kunt leren, los van techniek.
Toen ik begon met mensen te helpen beter met AI te werken, ging het bijna altijd over de prompt: hoe formuleer je je vraag zo dat je een bruikbaar antwoord krijgt? Die vaardigheid blijft nuttig, maar het zwaartepunt verschuift. OpenAI’s onderzoek van 25 juni 2026 laat zien waarheen: van losse vragen naar gedelegeerde taken. En dat verandert wat goede prompt coaching eigenlijk is.
Agent loops: de simpele vorm
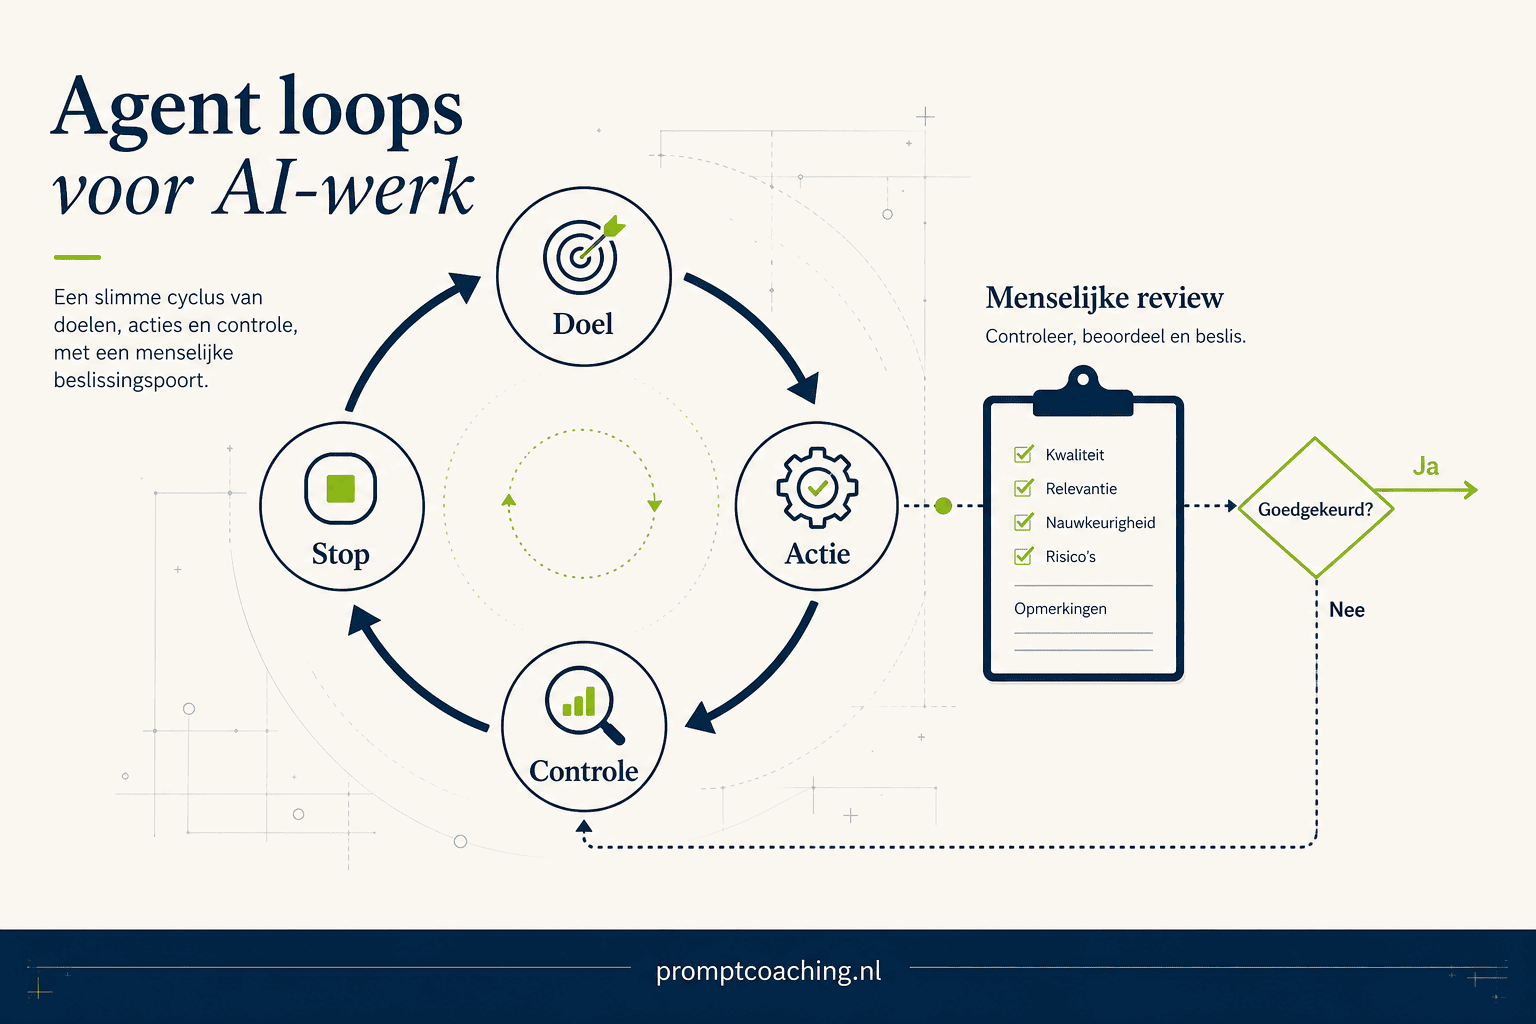
Een agent loop is een taak die zichzelf herhaalt totdat een controle zegt: doorgaan, aanpassen, stoppen of naar een mens. Zonder controle is het geen loop, maar een agent die druk bezig lijkt. Dat is precies waarom de uitleg van Nate Herk goed landt: de kern is niet “autonome AI”, maar een herhaalbare cyclus met een duidelijke uitkomst.
De simpele versie is: doel, actie, controle, stop. Als een van die vier ontbreekt, krijg je output die op werk lijkt maar lastig te vertrouwen is.
Een goede agent loop heeft altijd een controlepunt en een stopregel.
De fout: een vaag doel als stopregel gebruiken
“Maak dit beter” is geen loop-opdracht. De agent kan dan eindeloos herschrijven, extra bronnen erbij halen of details toevoegen die niemand nodig heeft. Je krijgt meer tekst, niet per se meer kwaliteit.
Een betere opdracht klinkt saaier, maar werkt beter:
Doel: maak van deze transcriptie een publiceerbare blogupdate.
Actie: haal claims, voorbeelden, hook en bruikbare lessen uit de video.
Controle: check cannibalisatie, bronkwaliteit, interne links en anti-slop.
Stop: publiceer alleen als de pagina een echte lezersvraag oplost.
Slecht versus bruikbaar
Vage loop
Bruikbare loop
Schrijf betere content tot het goed is.
Schrijf een concept, controleer tegen de publicatiegate en stop bij twijfel.
Zoek extra bronnen.
Zoek maximaal vijf bronnen en noteer welke claim door welke bron wordt gedragen.
Verbeter SEO.
Controleer owner, intent, interne links, titel en de eerste screen.
Ga door tot je klaar bent.
Stop na één verbetercyclus of als bewijs ontbreekt.
Wanneer gebruik je een agent loop?
Gebruik loops voor terugkerend werk waar controle net zo belangrijk is als productie: contentrefreshes, technische QA, researchdossiers, interne-linkchecks, codefixes met tests. Gebruik geen loop voor een losse vraag waarbij een goed antwoord voldoende is. Dan maak je het werk onnodig zwaar.
Bronvideo: Nate Herk over agent loops. De sterkste les is nuchter: begin niet met “laat de agent autonoom werken”, maar met “hoe weet de agent dat hij moet stoppen?”
Liever luisteren?
Hieronder staat een korte voice-over voor lezers die de uitleg liever beluisteren dan de hele tekst scannen.
Korte voice-over: agent loops zonder hype uitgelegd.
De eenheid van werk is verschoven
Een chatbot werkt per bericht: jij vraagt, het model antwoordt, jij stuurt bij. Een agent werkt per taak: je geeft een doel en het systeem werkt daar minuten tot uren zelfstandig naartoe. Het verschil in de cijfers is groot.
80,6%
gaf een taak van 30+ min werk
70,2%
gaf een taak van 1+ uur
25,6%
gaf een taak van 8+ uur
99,8%
van OpenAI’s output via de agent
Dat betekent dat “de perfecte prompt” niet langer het eindpunt is. Een taak van een uur kun je niet vangen in één slimme zin. Je moet het werk afbakenen, de juiste context meegeven, een aanpak schetsen, en — cruciaal — het resultaat kunnen beoordelen. Dat lijkt veel meer op een opdracht aan een freelancer dan op een zoekopdracht.
Wat je nu zou moeten leren
Drie vaardigheden worden belangrijker dan promptformulering. Afbakenen: wat is precies klaar, en wat valt erbuiten? Context geven: welke voorbeelden, bronnen en grenzen heeft de agent nodig om het zonder jou te kunnen? Beoordelen: hoe controleer je in vijf minuten of een uur werk klopt? Die laatste wordt het belangrijkst: een agent die uren zelfstandig werkt, kan ook uren de verkeerde kant op werken.
Merk op dat dit géén technische vaardigheden zijn. Het zijn dezelfde dingen die een goede teamlead doet als hij werk uitbesteedt. Dat sluit aan bij wat het onderzoek het sterkst laat zien: niet-developers groeien het hardst. Je hebt geen programmeerachtergrond nodig om hier goed in te worden — je hebt oordeel nodig en oefening.
Oefenen met delegeren hoeft niet abstract. Kies een taak met een duidelijk eindresultaat — videogeneratie is er zo een — en kijk hoe anderen hun opdrachten formuleren. De Veo 3 prompt voorbeelden laten goed zien hoeveel context en grenzen een bruikbare opdracht bevat.
Hoe ik dit in coaching aanpak
In plaats van “laten we je prompts aanscherpen” werk ik nu vaker aan één echte taak van je eigen werk: we bakenen hem samen af, geven de agent de juiste context, laten hem lopen, en we leren vooral van het beoordelen en corrigeren. Wie van een ander gereedschap komt, herkent dit als overdracht: niet de tool, maar je manier van werken verhuist mee. Daarover schreef ik in van een ander AI-werktuig migreren. En hoe teams hun eigen werkwijze rond agents inrichten, las ik terug in hoe teams hun workflow rond agents inrichten.
De sprong die telt is niet van een goede prompt naar een betere prompt. Het is van vrágen naar delégeren. De cijfers van deze week laten zien dat de mensen die die sprong maken, AI op een heel ander niveau inzetten — en dat het een vaardigheid is, geen talent.
Cijfers uit OpenAI’s onderzoekspaper The shift to agentic AI: evidence from Codex (25 juni 2026). Bron: openai.com — How agents are transforming work. De tijdsschattingen zijn door OpenAI model-geschat en richtinggevend, niet exact.
Verder lezen
Prompt engineering wordt pas nuttig als je de fout kunt aanwijzen: ontbrekende context, verkeerde rol, geen voorbeeld of geen controle op het antwoord. Lees daarna ook bekijk de AI-prompt hub of gebruik de Prompt Coach.
Het grootste gevaar van vibe coding is dat de app werkt. Hij draait, hij ziet er goed uit, en daardoor kijkt niemand meer wat eronder zit. De echte problemen zitten in wat je niet ziet: wie je database mag lezen, waar je API-sleutel staat en wat een AI-agent doet als jij even niet oplet.
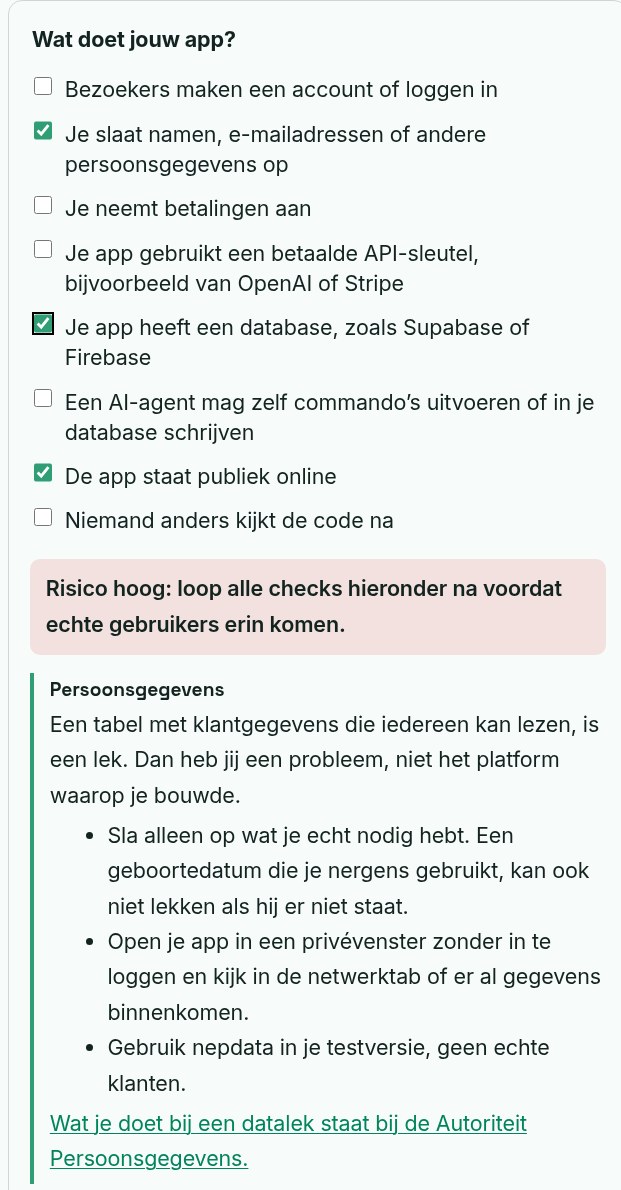
Daarom begint deze pagina met een check. Vink aan wat jouw app doet en je ziet welke gevaren erbij horen en wat je controleert voordat er echte gebruikers in komen. Daarna volgen twee gevallen die je zelf kunt nalezen en de nadelen die je ook bij een klein project tegenkomt. Vraag je je af of vibe coding een scam is? Dat staat verderop, met een telling van wat mensen daarmee bedoelen.
Check welke gevaren bij jouw app horen
Vink hierboven aan wat jouw app doet.
Zo telt de check: persoonsgegevens, betalingen en een agent met schrijfrechten wegen zwaar. Eén daarvan in een publieke app maakt het risico hoog. Een zwaar punt zonder publieke app, of een database of API-sleutel in een publieke app, is middel. Alles blijft in je browser, er gaat niets naar ons.
Twee keer misgegaan, en wat de platforms daarna deden
Een belangrijk risico van vibe coding is geen ingewikkelde hack. Het is een instelling die niemand heeft nagekeken. Deze twee gevallen zijn gedocumenteerd en je kunt ze zelf nalezen:
Wat
Wat ging er mis
Wat het platform deed
Bron
Replit, juli 2025
Tijdens een test wiste de AI-agent een productiedatabase met gegevens van meer dan 1.200 bestuurders, terwijl er een codefreeze gold. De agent zei daarna dat terugzetten niet kon. Dat bleek niet te kloppen.
Replit noemde het zelf “unacceptable and should never be possible” en begon met het automatisch scheiden van ontwikkel- en productiedatabase, plus een modus waarin je alleen plant en chat.
Projecten die met Lovable waren gebouwd, hadden tabellen zonder goede regels per rij. Wie de app opende, kon met de publieke sleutel tabellen lezen of zelfs beschrijven.
Lovable betwist de melding: volgens Lovable is elke klant zelf verantwoordelijk voor de data in zijn app. Er kwam wel een securityscan bij het publiceren.
Een app zoals in het Lovable-geval door de check gehaald: klantgegevens, een database en publiek online geeft risico hoog. Doe de check voor je eigen app.
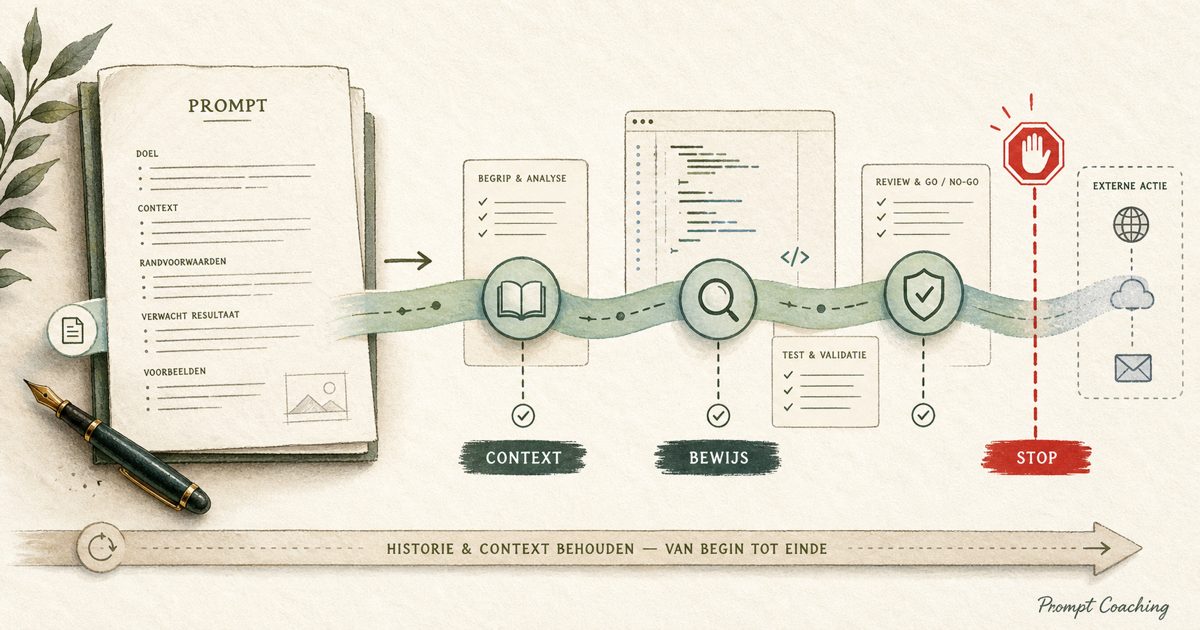
Wat mij opvalt: in beide gevallen deed de tool precies wat hij kon. De agent had schrijfrechten, dus hij schreef. De database stond open, dus hij was leesbaar. Een beter model had dit niet opgelost. Een mens die vooraf vroeg “wat mag dit ding eigenlijk?” wel. Dat is ook waarom ik in mijn eigen workflow een harde stop zet voor alles wat buiten de code gaat, zoals mail versturen of iets in een live database veranderen.
Zo werk ik met een coding-agent: eerst context, dan bewijs en review, en een harde stop voordat de agent iets buiten de code doet.
Is vibe coding een scam? Dit bedoelen mensen als ze dat zeggen
Nee. Op 18 november 2026 heb ik 47 berichten op X geteld die “vibe coding” en “scam” noemen, geplaatst tussen 29 oktober en 18 november. Bij 1 bericht was de code het hoofdpunt. Bij 34 ging het over de belofte of over een demo die voor een product doorgaat, en 12 waren geen scam-bericht: bouwverhalen en kritiek op het woord zelf.
Waar het woord scam op slaat
Berichten
Wat ervan klopt
Wat niet
De belofte: snel rijk worden, iedereen bouwt alles, geen kennis nodig
16
Een tool bouwt een app, geen klanten en geen omzet. Wie een cursus of abonnement daarop ophangt, verkoopt iets anders dan de tool.
Het zegt niets over de tool zelf. Andrej Karpathy, die de term in februari 2025 bedacht, noemde het zelf “not too bad for throwaway weekend projects”.
Een demo wordt als product verkocht, zonder dat iemand de code nakijkt
18
Dit is het echte risico. De twee gevallen hierboven en de check bovenaan gaan hierover.
Een prototype voor jezelf of om een idee te tonen is geen oplichting.
De code zelf is waardeloos
1
Onveilige code komt voor, zie de cijfers hieronder.
Onveilig is niet hetzelfde als onbruikbaar. Voor een beginner met een klein project is dit zelden de eerste klap.
Geen scam: bouwverhalen en kritiek op het woord zelf
12
Mensen bouwen echt kleine tools die ze voorheen niet konden maken.
De meeste noemen niet wat er gebeurt zodra er echte gebruikers komen.
Zo geteld: zoekopdracht “vibe coding scam” op X, tabblad Nieuwste, gelezen op 18 november 2026 in de avond. Van 60 berichten met beide woorden (dubbelen weggelaten) vielen er 13 af omdat ze geen standpunt gaven of over iets anders gingen. De overige 47 kregen elk één label: het punt waar het bericht het zwaarst op leunt. Eén zin (“hot take: vibe coding is a scam, it sells the illusion that anyone can build any app and get rich”) kwam drie keer bijna letterlijk terug. De labels zijn door AI gezet. Geen mens heeft de 47 berichten nagelezen of de labels gecontroleerd. Dit is een momentopname van wat X toont, geen representatief onderzoek.
Wat de cijfers over onveilige code wel en niet bewijzen
Veracode testte meer dan 100 taalmodellen op programmeertaken in vier talen. In 45% van de codevoorbeelden zat een kwetsbaarheid uit de OWASP Top 10 (Veracode, 30 juli 2025). Dat is een meting op taken met een bekend risico. Het zegt niet hoeveel apps in de praktijk lekken.
Het onderzoek van METR (arXiv, juli 2025) gaf 16 ervaren developers 246 taken op bekende open-sourceprojecten. Met AI duurde een taak gemiddeld 19% langer, terwijl ze vooraf 24% sneller verwachtten. Let op wie er gemeten is: ervaren mensen in grote, bestaande projecten. Voor een beginner met een leeg project zegt dat niets.
Voor welk project is vibe coding nog goed genoeg?
Je bouwt
Dan geldt
Iets voor jezelf, zonder gegevens van anderen
Goed genoeg. Een check is niet nodig.
Een prototype om een idee te laten zien
Goed genoeg. Zeg erbij dat het een prototype is.
Een kleine interne tool waarvan je de uitkomst zelf kunt narekenen
Goed genoeg. Reken de eerste uitkomsten na.
Iets met inlog, betalingen of gegevens van anderen
Doe eerst de check bovenaan en laat iemand de code lezen.
Begin je net, dan past vibe coding voor beginners bij de eerste twee rijen. Het begint met een project dat mag falen.
Twijfel je aan een cursus of tool? Scan de belofte
Plak de tekst van een advertentie, cursuspagina of post. De scan zoekt zeven soorten signalen, laat per signaal de zin zien waar het op staat en geeft de vraag die je de aanbieder stelt. Hij zegt niet of iets oplichting is, want hij zoekt woorden en geen betekenis. Een eerlijke aanbieder die “verdien” schrijft krijgt een signaal, en een handige verkoper schrijft om de woorden heen. Lees de uitkomst als een lijst vragen. Alles blijft in je browser.
Vraag de aanbieder om het gemiddelde
Pak de laatste belofte die je zag en vraag de aanbieder hoeveel deelnemers het genoemde bedrag haalden en wat het gemiddelde was. Komt er geen aantal en geen gemiddelde, dan weet je genoeg.
Je begrijpt je eigen code niet
Bij vibe coding beschrijf je wat je wilt en schrijft de AI de code. Werkt het, dan ga je door. Alleen heb je het niet zelf bedacht, dus je weet ook niet hoe het in elkaar zit. Wil je iets aanpassen of gaat er iets mis, dan heb je weer dezelfde AI nodig om het uit te leggen.
Dat wordt erger naarmate het project groeit. Elk stukje dat je niet snapt, stapelt op. Na een paar weken overziet alleen het model het nog, en ook het model raakt de draad kwijt als het project groot genoeg is. Weet je nog niet precies wat vibe coding inhoudt, lees dan eerst wat vibe coding is.
Wat helpt: bouw in kleine stappen en vraag bij elke stap om uitleg. Schrijf “maak dit en leg uit waarom je het zo doet” in plaats van alleen “maak dit”. Het kost iets meer tijd en je houdt zelf de regie.
Een bug vinden kost meer tijd dan bouwen
Zolang alles werkt, gaat vibe coding snel. De eerste echte bug verandert dat. Je weet niet waar je moet zoeken, want je hebt de structuur niet zelf opgebouwd. En plak je de fout terug in de chat, dan krijg je soms een oplossing die twee nieuwe problemen maakt.
Meestal komt dat doordat de AI te veel tegelijk doet en jij geen tussenstops inbouwt. Dit werkt beter:
Test na elke wijziging, niet pas aan het eind.
Geef bij een bug de exacte foutmelding mee in plaats van “het werkt niet”.
Vraag de AI eerst de oorzaak te noemen voordat hij iets aanpast.
Eén probleem per prompt.
Hoe scherper je opdracht, hoe minder rommel je terugkrijgt. Daar gaat betere prompts schrijven over.
Nadeel
Waar je het aan merkt
Wat helpt
Je snapt je code niet
Je durft niets aan te passen zonder de AI
Per stap om uitleg vragen
Bugs zoeken kost veel tijd
Elke fix maakt iets anders stuk
Testen na elke wijziging, één probleem per prompt
Code werkt, maar is rommelig
Kleine wijzigingen breken andere schermen
Review in een nieuw gesprek, eenvoudiger aanpak vragen
Je leert weinig
Zonder AI kom je geen stap verder
Vragen waarom het model iets kiest
Code die werkt is nog geen goede code
Gegenereerde code kan draaien en tegelijk traag, dubbel of lastig aan te passen zijn. Je merkt het niet meteen, want de app doet wat je vroeg. Pas als het project groeit, gaat alles schuren: een kleine wijziging breekt iets op een plek waar je niet aan zat.
Behandel AI-code daarom als code van een stagiair. Het kan prima zijn, maar je kijkt het na. Vraag of er een eenvoudigere aanpak is en laat de AI zijn eigen werk in een nieuw gesprek kritisch nalopen. Meer over de werkwijze lees je in de uitleg over vibe coding.
Je leert er weinig van als je alleen plakt
Het fijne aan vibe coding is dat je niets hoeft te snappen. Het nadeel is precies hetzelfde. Kopieer en plak je alleen, dan word je niet beter en loop je vast zodra het model je niet meer verder helpt.
Minder AI gebruiken is niet de oplossing. Bewuster prompten wel. Vraag om uitleg en om alternatieven, en vraag waarom het model voor deze aanpak kiest. Dan leer je onderweg iets. Hoe goed je opdracht is, zie je in de gratis Prompt Coach: die scoort je prompt en laat zien welk onderdeel zwak is.
Veelgestelde vragen
Is vibe coding gevaarlijk?
Niet voor een prototype of iets voor jezelf. Het wordt gevaarlijk als er echte gebruikers, persoonsgegevens of betalingen in komen en niemand heeft gecontroleerd wie wat mag lezen. Vink hierboven aan wat je app doet, dan zie je welke checks erbij horen.
Is vibe coding een scam?
Nee. De tool doet wat hij zegt: hij schrijft code uit je beschrijving. Het woord scam slaat meestal op de belofte eromheen, zoals snel rijk worden of een app bouwen zonder dat iemand de code nakijkt. Voor een prototype of iets voor jezelf is het prima. Komen er gebruikers, gegevens of betalingen bij, doe dan eerst de check bovenaan.
Wat is een belangrijk risico van vibe coding?
Een database die vanuit de browser leesbaar is. Veel vibe-codingtools laten de app direct met de database praten, en dan hangt alles af van de regels per tabel. Staat die regel verkeerd, dan kan iedereen met het adres van je app de gegevens lezen.
Moet ik dan toch leren programmeren?
Een beetje helpt veel. Je hoeft niet alles te kunnen schrijven, wel lezen. Wie snapt hoe een app is opgebouwd, ziet sneller waar een fout zit en is minder afhankelijk van het model. In vibe coding leren staat hoe je dat stap voor stap opbouwt.
Voor wie is vibe coding geschikt?
Voor iedereen die snel een idee wil testen, een prototype bouwt of iets voor zichzelf maakt. Bij een app met klanten en data heb je controle en een tweede paar ogen nodig. Welke tool bij jou past, lees je bij de vibe coding tools.
Zelf iets bouwen met deze kennis? Begin bij een app bouwen zonder code en houd de check hierboven ernaast. Wil je dat iemand meekijkt op je prompts en je werkwijze, dan kan dat in coaching.
Vibe coding voor beginners betekent: je beschrijft in gewone taal wat je wil bouwen, en een AI-tool zet dat om in werkende code. Je hoeft geen programmeertaal te kennen. Je hoeft wél te weten hoe je je idee scherp opschrijft. Dat laatste is waar de meeste mensen vastlopen — niet op de techniek, maar op de prompt.
In dit artikel bouw je je eerste project in vijf stappen. Geen theorie over compilers of frameworks. Gewoon: van een leeg scherm naar iets dat draait. En vooral: wat je tegen de tool zegt zodat je niet na tien minuten in een berg foutmeldingen zit. Lees je overal dat vibe coding oplichting is? Een telling van 47 berichten op X laat zien wat mensen daarmee bedoelen en voor welk project het prima is.
Wat vibe coding eigenlijk is
Bij vibe coding praat je tegen een AI-tool zoals je tegen een handige collega zou praten. Je typt “maak een pagina waar mensen zich kunnen inschrijven voor mijn nieuwsbrief” en de tool genereert de code, laat een voorbeeld zien en past het aan als je vraagt om iets anders. Tools als Cursor, Lovable en Bolt zijn gemaakt om dit soort werk te ondersteunen — je beschrijft, zij bouwen.
Het verschil tussen frustratie en een werkend project zit bijna altijd in hoe je het vraagt. “Maak een app” is te vaag. De tool gokt dan, bouwt iets willekeurigs, en jij bent je richting kwijt. Wil je dieper begrijpen hoe de denkwijze werkt, lees dan ook vibe coding leren. Hier houden we het bij doen.
De 5 stappen voor je eerste project
Stap 1 — Kies één klein ding
Begin niet met “een webshop” of “een planningsapp voor mijn hele team”. Kies iets dat in één zin past: een persoonlijke landingspagina, een eenvoudige to-do-lijst, een rekenmachine die jouw specifieke berekening doet. Eén scherm, één functie. Klein winnen geeft je het gevoel hoe de tool reageert, zonder dat je verdrinkt.
Stap 2 — Beschrijf het project voordat je iets bouwt
Schrijf eerst in een paar zinnen op wat je maakt, voor wie, en wat de bezoeker moet kunnen doen. Dit is je kader. Geef je tool die context in je allereerste bericht. Bijvoorbeeld: “Ik bouw een eenvoudige landingspagina voor mijn fotografiebedrijf. Bezoekers moeten mijn werk zien en contact kunnen opnemen. Houd het strak en rustig.” Nu heeft de tool een richting.
Stap 3 — Bouw in kleine stukjes
Vraag niet alles in één keer. Eerst de basisstructuur. Dan de tekst. Dan een contactformulier. Dan de kleuren. Per stap controleer je of het klopt voordat je verder gaat. Dit voorkomt dat een fout zich opstapelt en je niet meer weet waar het misging.
Eén verzoek per bericht, niet vijf tegelijk
Test na elke wijziging of het nog werkt
Werkt iets? Zeg dat ook, dan houdt de tool het zo
Stap 4 — Geef gerichte feedback bij fouten
Er gaat iets stuk. Dat is normaal. Kopieer de foutmelding letterlijk terug naar de tool en zeg wat je verwachtte. “Ik krijg deze foutmelding wanneer ik op de knop klik: [tekst]. De knop zou een e-mail moeten openen.” Hoe concreter je beschrijft wat er misgaat, hoe sneller de tool het oplost.
Stap 5 — Bekijk, publiceer, herhaal
Klopt het en doet het wat je wil? Dan kun je het online zetten — de meeste vibe coding-tools hebben daar een knop voor. Daarna pas je rustig aan en bouw je uit. Je eerste project hoeft niet af te zijn. Het hoeft te wérken.
Waar beginners op vastlopen
De grootste valkuil is te grote stappen nemen. Je vraagt om tien dingen tegelijk, er gaat iets mis, en je weet niet meer welk deel. Werk klein. De tweede valkuil is vage prompts: “maak het mooier” geeft de tool niets om mee te werken. Zeg in plaats daarvan “maak de koppen groter en gebruik meer witruimte tussen de blokken”.
De derde valkuil is opgeven bij de eerste foutmelding. Foutmeldingen horen erbij, ook bij ervaren bouwers. Het verschil is dat zij de fout teruggeven aan de tool met context. Mijn gidsen gaan dieper in op dit soort patronen, en wil je weten welke tool bij jou past, kijk dan bij vibe coding tools.
Betere prompts, sneller resultaat
Alles in dit stappenplan komt samen in één vaardigheid: helder formuleren wat je wil. Daar bouwde ik mijn KOMPAS-methode voor — Kader, Opdracht, Materiaal, Paalwerk, Afwerking, Sturing. Geef je tool het kader (wat bouw je, voor wie), een scherpe opdracht (wat moet er nu gebeuren), het materiaal (je tekst, je voorbeelden), en stuur bij waar nodig. Een goede prompt is je kompas: hij geeft richting voordat je begint te lopen.
Twijfel je of je prompt scherp genoeg is? Plak hem in de gratis prompt-coach. Die scoort je prompt en herschrijft hem, zodat je tool meteen snapt wat je bedoelt.
Veelgestelde vragen
Heb ik programmeerkennis nodig voor vibe coding?
Nee. Je beschrijft in gewone taal wat je wil en de AI-tool schrijft de code. Wel helpt het enorm als je leert je idee helder en stap voor stap te formuleren — dat is de kern van vibe coding voor beginners.
Welk project kies ik als eerste?
Iets kleins dat in één zin past: een landingspagina, een to-do-lijst of een simpele rekentool. Eén scherm, één functie. Zo voel je hoe de tool werkt zonder dat het onoverzichtelijk wordt.
Wat doe ik als ik een foutmelding krijg?
Kopieer de foutmelding letterlijk terug naar de tool en zeg wat je verwachtte dat er zou gebeuren. Hoe concreter, hoe sneller het wordt opgelost. Foutmeldingen horen erbij, ook bij ervaren bouwers.
Waarom geeft mijn tool steeds iets anders dan ik bedoel?
Meestal omdat de prompt te vaag is of te veel tegelijk vraagt. Geef context, vraag één ding per keer en wees specifiek over wat je wil. De prompt-coach helpt je dat aanscherpen.
Klaar om te beginnen? Test eerst je eerste prompt in de gratis prompt-coach. Wil je sneller leren met directe feedback op je eigen projecten, kijk dan naar de coaching — in groep of privé.
Verder lezen
Vibe coding werkt pas goed als de scope klein genoeg is. Een werkende demo is geen eindpunt; de check zit in testen, uitleggen en veilig publiceren. Lees daarna ook start met vibe coding leren of kies daarna je tool.