Auteur: Sam

  • Schrijf de zin die een AI-overzicht pakt

    Schrijf de zin die een AI-overzicht pakt

    Je plakt je nieuwste blogpost in de chat en vraagt wat de kern is. Het antwoord komt in één zin terug, netjes geformuleerd. Er zit alleen een wrang detail aan: die zin staat niet in je openingsalinea. Hij staat halverwege, tussen twee kopjes, precies waar jij hem als toelichting had bedoeld. Je eerste alinea was voorwerk, en het model heeft hem overgeslagen.

    Dat is niet alleen een chat-trucje. De beste gok bij Google’s AI-overzichten is dat ze op hetzelfde principe werken: zinnen en fragmenten uit bronnen die direct antwoorden. En op de resultaatspagina van 2026 telt een andere maat dan de plek onder elkaar: volgens de Search Console-documentatie neemt elk element op de pagina één positie in, en delen alle links in dat element in de meeste gevallen dezelfde positie. Een AI-overzicht is zo’n element. Je link erin staat dus officieel op dezelfde hoogte als alle andere bronnen erin — het getal dat je dashboard voedt maakt geen onderscheid. Wat wél onderscheid maakt, is of je erin staat, en dat hangt af van of het systeem een zin van jouw pagina kan overnemen die de vraag beantwoordt.

    Alle bronnen delen dezelfde positie

    Voor wie gewend is te sturen op plek drie boven plek zeven is dat een vreemd idee. Binnen het antwoord bestaat die rangorde niet in de rapportage. SEO-consultant Glenn Gabe vat het zo samen: AI-overzichten worden als één blok behandeld, “so all links get the same position” — in elk geval bij AI-overzichten, dat zegt hij er zelf expliciet bij. Je plek op de pagina is dus geen onderscheidend kenmerk meer. Het onderscheid is erin staan of erbuiten blijven.

    Dat verandert de vraag die je jezelf stelt. Niet meer “hoe kom ik hoger”, maar “welke zin van mijn pagina neemt het antwoord over”. En dat is precies de vraag waar je als schrijver iets mee kunt. Wat je van buitenaf ziet: het antwoord pikt fragmenten die los uit de bron te lezen zijn. Zulke zinnen maak je zelf, en het recept is verrassend eenvoudig.

    Vier eigenschappen van een citeerbare openingszin

    Een zin die een AI-overzicht kan overnemen herken je aan vier dingen:

    • Ze beantwoordt de vraag in de zin zelf. “De beste tijd om banden te wisselen is eind oktober, vóór de eerste nachtvorst” is een antwoord; “Daar zijn verschillende meningen over” is een belofte.
    • Ze staat alleen. Geen “daardoor”, “daarom” of “zoals hierboven” die terugwijst naar een zin die het systeem niet heeft meegenomen.
    • Ze staat vroeg. Bovenaan de pagina, vóór de uitleg, in de eerste alinea. Wie zijn antwoord in de derde alinea begraaft, schrijft voor lezers die al doorgescrold hebben.
    • Ze bevat de begrippen waarmee mensen zoeken. Niet om Google te paaien, maar omdat het antwoord dan over hetzelfde gaat als de vraag.

    Is dit manipuleren? Nee, en dat is het prettige. Een zin met die vier eigenschappen is ook voor een menselijke lezer de sterkste openingszin die je kunt schrijven. Wie hem overslaat, verliest beide lezers: de mens die door wil scrollen naar het antwoord, en het systeem dat het antwoord wil citeren.

    Vraag naar citaten, niet naar posities

    Ons standpunt voor wie met AI schrijft: stop met vragen naar je positie en begin met vragen naar je citaten. Jouw content wordt tegenwoordig op twee plekken gelezen, door mensen en door de systemen die antwoorden samenstellen. Voor de eerste telt leesbaarheid, voor de tweede pakbaarheid, en een goede openingszin doet allebei. De oude rangorde was een race om de bovenkant van de pagina; de nieuwe is een race om de kern in één zin te vatten.

    Dit is ook promptwerk, niet alleen schrijfwerk. Maak het een vaste stap in je contentproces: nadat de eerste versie klaar is, vraag je het model “wat is het antwoord van deze pagina in één zin?” Schrijft het model een zin die je niet op je pagina terugvindt, dan is dat je openingszin — herschrijf hem tot hij er staat. Zo’n kernvraag-prompt is geen truc maar een spiegel: hij laat zien waar jouw pagina de kern begraaft.

    Eén antwoordzin is geen hele pagina

    Dit advies heeft wel een zwakke kant, en die hoort erbij. De tactiek “zet een losse antwoordzin bovenaan” maakt je pagina citatie-voer, maar zegt niets over de rest van die pagina. Een systeem dat één zin overneemt, kiest daarna nog welke bron erbij komt te staan, en die keuze hangt af van autoriteit, actualiteit en hoe het web over je onderwerp praat. Je kunt perfect schrijven en toch niet geciteerd worden, terwijl een site met een zwakkere zin het wél haalt. Wie belooft dat één herschreven alinea citaten oplevert, belooft te veel. Wat het wél doet is je kans vergroten, en dat is in dit spel het enige dat je zelf in de hand hebt.

    Er zit nog een grens aan: citeren is geen vast resultaat dat je afrekent. Dezelfde pagina kan vandaag wél en volgende week niet in het antwoord staan. Stuur erom op je eigen proces, niet om één afgeronde winst.

    Check eerst dat je niet uitgesloten bent

    Vóór je aan zinnen sleutelt, is er één instelling om na te kijken. Google zegt in de documentatie over generatieve AI in Zoeken dat je site in aanmerking moet komen voor deze functies; het opnemen is de standaard, en de instelling staat in Search Console onder Instellingen bij Generatieve AI in Zoeken; wie zijn content er bewust of bij toeval uit heeft gehaald, krijgt er geen vertoningen en geen klikken van. Een pagina die nergens in de AI-antwoorden verschijnt kan dus aan zijn zinnen liggen, maar ook aan een uitsluiting. Eerst dat uitzoeken, dan schrijven.

    Of je in het antwoord staat, is na te kijken in het prestatierapport voor generatieve AI in Search Console: het telt hoe vaak je links in AI-functies vertoond werden, per pagina, land en apparaat. Het is geen cijfer om dagelijks op te sturen, maar het is wel de eerlijkste meter die je hebt voor de vraag of je citeerbare zinnen hun werk doen.

    Herschrijf één zin, meet volgende maand

    Pak je belangrijkste pagina erbij en lees alleen de openingsalinea. Geeft die in één zin het antwoord op de vraag waar de pagina om gaat? Zo niet, herschrijf dan die ene zin tot een antwoord dat los kan staan, met de vier eigenschappen erboven. Eén zin, geen complete herschrijfronde. Zet er een notitie in je agenda bij over een maand en kijk dan in het generatieve-AI-rapport of de vertoningen van die pagina zijn gegroeid. Dat is de langzaamste maar eerlijkste loopmeter die je hebt.

    De zinnen die je schrijft zijn de grondstof van de antwoorden. In onze prompts voor content staat hoe je de kernvraag als vaste stap in je schrijfproces zet, en prompt engineering voor ondernemers laat zien hoe je dat herhaalbaar maakt voor je hele team.

    De zin die twee banen doet

    Wat je hiervan kunt verwachten: elk AI-overzicht bestaat uit zinnen die ergens vandaan kwamen, en die bronnen zijn na te checken. Wie die zinnen bovenaan zijn pagina’s zet, wint twee keer op dezelfde dag — bij de lezer die direct het antwoord ziet, en bij het systeem dat een bron zoekt voor zijn volgende antwoord. En mocht er ooit een betere maat komen dan de blokpositie die vandaag in de rapportage staat, dan meet die waarschijnlijk precies wat je nu al schrijft: de zin die de vraag beantwoordt.

    Vragen die hier vaak bij komen

    Hoe kom ik met mijn pagina in een AI-overzicht?

    Met één openingszin die de vraag volledig beantwoordt, op een pagina die indexeerbaar is en waarvan de feiten kloppen. Meer is het niet; minder werkt niet.

    Levert zo’n vermelding nog klikken op?

    Minder dan een gewone toppositie, want het antwoord staat al op Google. Wat je wel krijgt: je naam bij het antwoord. Daarom telt juist die ene zin.
  • Codex contextbeheer aanzetten

    Codex contextbeheer aanzetten

    Je zit midden in een bouwklus. Codex stelt opnieuw een aanpak voor die je eerder al had afgewezen. Dan mag je weer uitleggen waarom. Experimenteel contextbeheer moet helpen om zulke eerdere details beter beschikbaar te houden. Je kunt het aanzetten in de configuratie van Codex, maar een gegarandeerde besparing op je verbruik is het niet.

    Een bericht van MaxForAI op X bracht de instelling onder de aandacht met de belofte van flink lager GPT-6-verbruik. De functie zelf staat inderdaad in de documentatie van OpenAI. Die documentatie bevestigt de werking en de toegangseisen, maar noemt bij deze instelling geen besparingspercentage.

    Hoe werkt het nieuwe Codex-contextbeheer?

    Een taalmodel kan maar een begrensde hoeveelheid informatie tegelijk meenemen. Dat heet het contextvenster. Bij lange opdrachten moet een code-agent dus bepalen welke eerdere informatie beschikbaar blijft.

    Volgens de configuratiereferentie van OpenAI gebruikt deze experimentele modus notities en doorzoekbare geschiedenis, in plaats van de context herhaaldelijk tot één samenvatting te comprimeren. Het doel is eerder opgebouwde details te bewaren. De functie staat standaard uit en vereist een ChatGPT-login met Plus, Pro of Pro Lite.

    Denk aan een boekingsformulier. Je hebt afgesproken dat een klant eerst een tijdslot kiest en pas daarna zijn e-mailadres invult. Halverwege moet Codex een fout in de beschikbaarheidscontrole oplossen. Die oorspronkelijke keuze moet dan nog meetellen. Een zoekbare eerdere afspraak kan daarbij helpen; alleen een korte samenvatting kan de reden achter de volgorde missen. Dit is een voorbeeld van het probleem, geen gemeten testresultaat.

    Minder opnieuw uitleggen is de goede reden om dit te proberen

    Ik vind dit vooral interessant voor opdrachten die langer duren dan één kleine wijziging. Wie met AI bouwt, wil dat afgewezen oplossingen afgewezen blijven en dat eerdere afspraken terug te vinden zijn. Daar heb je in de praktijk meer aan dan aan een indrukwekkend besparingsgetal zonder vergelijkbare test.

    Het zwakke punt van dat enthousiasme: meer geschiedenis maakt een fout besluit niet goed. Als je aan het begin een onduidelijke opdracht geeft, kan Codex ook die onduidelijkheid bewaren. Een concrete opdracht blijft nodig. In de uitleg over betere prompts schrijven staat hoe je grenzen en gewenste uitkomsten vastlegt.

    Hoe zet je de instelling aan zonder dubbele configuratie?

    Open je persoonlijke bestand ~/.codex/config.toml en maak eerst een kopie. Gebruik je de Codex-extensie in je editor, dan beschrijft OpenAI de route via het tandwiel: Codex Settings → Open config.toml. De uitleg over configuratie vermeldt ook dat projectinstellingen je persoonlijke standaard kunnen overschrijven.

    Zoek eerst op context_management. Staat de instelling al op true, voeg dan niets toe. Ontbreekt hij, dan kun je dit blok gebruiken:

    [features.context_management]
    experimental_mode = true

    Heb je al een blok [features], dan kun je daar ook deze ene regel onder zetten:

    context_management.experimental_mode = true

    Kies één schrijfwijze. TOML, het bestandsformaat van deze configuratie, accepteert geen dubbele definitie van dezelfde instelling. De korte regel hoort binnen [features], vóór het volgende blok tussen vierkante haken. Plak hem dus niet zomaar onderaan het bestand.

    Sla het bestand op en begin een nieuwe taak om de instelling te proberen. Meldt je client dat hij de instelling niet kent, controleer dan of er een update beschikbaar is. Alleen een API-key voldoet niet aan de door OpenAI genoemde ChatGPT-loginvoorwaarde. Wil je terug, zet dezelfde waarde op false.

    Veelgestelde vragen

    Wat doet [features.context_management] experimental_mode = true precies?

    Het zet het experimentele contextbeheer van Codex aan: eerdere opdrachtdetails blijven als notities en doorzoekbare geschiedenis beschikbaar in plaats van herhaaldelijk tot een korte samenvatting gecomprimeerd te worden. De instelling staat standaard uit, vereist een ChatGPT-login met Plus, Pro of Pro Lite, en garandeert geen lager tokenverbruik.

    Een vinkje bewijst nog geen lager verbruik

    Op 6 september 2026 hebben we de eigen Codex-configuratie gecontroleerd. De instelling stond al op true. Daarmee is vastgesteld dat de optie aanstond. We hebben geen vergelijking van het verbruik met en zonder deze functie uitgevoerd.

    Wil je zelf vergelijken, gebruik dan twee kopieën van dezelfde beginversie van een klein project. Geef dezelfde opdracht met hetzelfde model en dezelfde denkstand, één keer met de functie uit en één keer aan. Noteer het zichtbare verbruik én of het resultaat werkt. Eén poging per stand is hooguit een eerste aanwijzing: modelgedrag kan tussen runs verschillen.

    Je eerste handeling kan nog kleiner: controleer vandaag of de instelling al in je bestand staat. Bij een volgende langere bouwklus kun je vervolgens letten op een concrete afspraak die Codex eerder vergat. Blijft die behouden en hoef je minder te corrigeren, dan merk je waar deze functie nuttig kan zijn. Voor een eerste oefenproject kun je de stappen voor vibe coding leren gebruiken. Een herhaalde vergelijking moet daarna uitwijzen of ook het verbruik daalt.

    Geschreven door Sam. Instelling en documentatie gecontroleerd op 6 september 2026.

  • Je zet het vinkje aan en krijgt toch een witte achtergrond

    Je zet het vinkje aan en krijgt toch een witte achtergrond

    Half vijf. De banner moet morgenochtend de deur uit en je hebt nog één plaatje nodig: het product los, zonder achtergrond. Je zet netjes het vinkje voor transparantie aan, typt je prompt, drukt op enter.

    En je krijgt een keurige studiofoto terug. Met een witte achtergrond. Vinkje stond aan.

    Je eerste gedachte is dat de tool stuk is. Dat is hij niet. Jij hebt hem alleen twee tegenstrijdige opdrachten gegeven, en hij heeft geluisterd naar de verkeerde.

    Drie routes, en toen de controleproef

    We hebben dezelfde opdracht — een losse witte drone — door drie verschillende routes naar GPT Image 2 gehaald. Alle drie leverden een PNG met een echt alfakanaal: 72%, 76% en 87% van het beeld volledig doorzichtig. Schone randen, propellerbladen netjes half transparant. Prima werk.

    Toen deden we de controleproef. Zelfde instelling voor transparantie, maar in de prompt vroegen we om een “studio product photo” in plaats van om een los onderwerp. Resultaat: een gewone afbeelding zonder alfakanaal. Nul transparantie.

    Eén woord in de prompt zette de instelling opzij. Dat woord was “studio”.

    Een parameter is een verzoek, geen bevel

    Dit is het stukje dat bijna nergens staat, en het geldt breder dan alleen transparantie. Zo’n instelling is geen schakelaar die het model dwingt. Het is een voorkeur die meegaat in de afweging. Je prompt zit in diezelfde afweging, en die is veel specifieker.

    Vraag je om een studio, dan bouwt het model een studio. Vraag je om een tafel, een ondergrond, een sfeer of zelfs maar een kleur, dan krijg je die. Het model kiest niet tussen jouw woorden en jouw vinkje — het leest allebei en jouw woorden zijn concreter.

    OpenAI schrijft dit trouwens gewoon in de eigen documentatie. Het staat er alleen als een voetnoot, terwijl het het belangrijkste is dat je moet weten.

    Hoe formuleer je het dan wél?

    De oplossing is saai. Je zegt niet alleen wat er in beeld moet, je zegt er expliciet bij wat er níét mag zijn:

    Het onderwerp los, op een volledig transparante achtergrond. Geen decor, geen vlakke kleur, geen schaakbordpatroon, geen slagschaduw, geen ondergrond.

    Dat schaakbord is geen grapje. Beeldmodellen hebben zoveel screenshots uit Photoshop gezien dat ze het grijs-witte blokjespatroon soms letterlijk natekenen als achtergrond. Je vraagt om transparantie en krijgt een plaatje van transparantie.

    Is dit nou een vaardigheid of gewoon een trucje?

    Dit is precies het moment waarop iemand roept dat “prompt engineering” dus toch een vaardigheid is. Daar wil ik meteen wat lucht uit laten.

    Wat hier werkt is niet magie en het is geen geheime formule. Het is opschrijven wat je niet wilt hebben. Dat is het. Elke goede opdrachtgever doet dat al twintig jaar bij een fotograaf.

    En ik weet niet welk woord in die zin de doorslag geeft. Is het “volledig transparante achtergrond”? Is het “geen ondergrond”? Ik heb ze samen getest, niet los. Iedereen die je een lijstje toverwoorden verkoopt met de belofte dat precies díé werken, heeft dat waarschijnlijk net zo min uitgesplitst. Wees daar wantrouwend over — ook bij mij.

    Negatief formuleren is de techniek die niemand oefent

    De vaardigheid die je hier oefent is niet “de juiste instelling vinden”. Het is leren negatief formuleren, en dat is de meest onderschatte prompttechniek die er is.

    Wij mensen beschrijven van nature wat we willen zien. Een model vult alles in wat je openlaat, en het vult het in met wat het het vaakst heeft gezien. Bij productfoto’s is dat een studio. Bij portretten is dat een onscherpe achtergrond. Bij een grafiek zijn dat verzonnen getallen op de assen.

    Dus: benoem de gaten. Niet alleen bij beeld. Ook als je om een tabel vraagt en je wilt geen kolom “conclusie”, of als je om een samenvatting vraagt en je wilt geen inleiding. Wat je niet uitsluit, verzint het model voor je.

    Welk oud plaatje ga jij opnieuw vragen?

    Zoek een afbeelding die je ooit met de hand hebt uitgeknipt — een logo, een productfoto, een icoon. Vraag hem opnieuw, mét die negatie-regel erin. Kijk daarna of hij écht doorzichtig is door hem op een zwarte dia te plakken. Zie je een licht vlak, dan is hij het niet.

    Dat kost je twee minuten en het leert je meer over hoe deze modellen luisteren dan tien blogs over prompttechnieken. Die van mij inbegrepen.

    Wat zou dit advies laten omvallen?

    OpenAI noemt transparantie voorlopig een preview op GPT Image 2. Dat betekent dat gedrag kan veranderen zonder aankondiging — dus bouw er nog geen productieproces omheen dat stilvalt als het morgen anders werkt. Wij houden bij of de instelling zwaarder gaat wegen dan de prompt, want dan verandert dit advies.

    Meer over beeldprompts: lees hoe je een goede beeldprompt schrijft. Werk je met tekst én beeld door elkaar, dan is prompts voor bewegend beeld de logische volgende stap.

  • Veo en AI-video: prompts voor bewegend beeld

    Een prompt voor een AI-videogenerator zoals Veo is iets anders dan een prompt voor een plaatje. Je beschrijft niet alleen wat er te zien is, maar ook wat er gebeurt: hoe iets beweegt, hoe de camera meegaat, hoe het licht verandert. Wie dat overslaat, krijgt een statisch shot dat toevallig een beetje schokt. Goede veo ai video prompts sturen op tijd en beweging, niet alleen op onderwerp.

    In dit artikel zie je welke bouwstenen een videoprompt nodig heeft, hoe je beweging en camera beschrijft, en hoe je met een vaste structuur voorkomt dat je steeds opnieuw moet gokken.

    Wat een videoprompt anders maakt dan een beeldprompt

    Bij een afbeelding bevries je één moment. Bij video moet je een verloop beschrijven: een begin, een ontwikkeling, soms een einde. De generator vult de tussenliggende frames in. Hoe vager jouw verloop, hoe meer de generator zelf verzint — en dat is precies waar het misgaat.

    Denk in vier lagen die je expliciet maakt:

    • Onderwerp en handeling — wie of wat, en wat doet het (lopen, draaien, gieten, kijken).
    • Camera — staat hij stil, beweegt hij mee, zoomt hij in? Een vaste camera met beweging in het frame ziet er heel anders uit dan een meebewegende camera.
    • Sfeer en licht — tijd van de dag, lichtbron, kleur, weer. Dit bepaalt de toon meer dan wat dan ook.
    • Tempo en duur — gebeurt het langzaam of snel, in één vloeiende beweging of in stappen.

    Veel mensen schrijven alleen de eerste laag en verbazen zich dat het resultaat levenloos aanvoelt. De andere drie zijn waar de beweging vandaan komt. Wil je eerst de basis van beeldprompts onder de knie? Lees dan ai beeld- en video-prompts — daar staan de fundamenten waar dit op voortbouwt.

    Beweging en camera concreet beschrijven

    Het verschil tussen een bruikbaar en een onbruikbaar shot zit vaak in twee woorden came- taal. Beschrijf de camera alsof je een draaiboek schrijft voor een cameraman die niets van jouw idee weet.

    Cameratermen die werken

    • Stilstaand shot — de camera beweegt niet, alleen het onderwerp.
    • Meebewegen — de camera volgt het onderwerp dat door beeld loopt.
    • Inzoomen of uitzoomen — langzaam dichterbij of juist terug.
    • Om het onderwerp heen draaien — een cirkelbeweging rond een vast punt.
    • Van laag naar hoog — een opwaartse beweging die iets groots laat voelen.

    Combineer dat met het tempo: “langzaam inzoomen op het gezicht” geeft een rustig, ingehouden gevoel; “snel meebewegen terwijl ze rent” geeft energie. Hetzelfde onderwerp, totaal andere video.

    Beweging in het frame

    Beschrijf ook wat er binnen het beeld beweegt los van de camera: haar dat opwaait, stoom die opstijgt, water dat stroomt, bladeren die vallen. Dat soort kleine continue beweging maakt het verschil tussen een levende scène en een ingekleurde foto. Eén of twee van zulke details zijn genoeg — gooi er niet vijf bewegingen tegelijk in, want dan wordt het een chaos.

    De KOMPAS-structuur voor videoprompts

    Een goede prompt is je kompas: hij wijst de generator de richting in plaats van hem te laten dwalen. De KOMPAS-methode dwingt je om niets te vergeten. Voor video vul je de zes onderdelen zo in:

    • Kader — wat voor video maak je en voor wie (sfeervolle sfeer-clip, productshot, uitleganimatie).
    • Opdracht — de scène in één zin: het onderwerp en de hoofdhandeling.
    • Materiaal — concrete details: locatie, kleding, objecten, tijd van de dag.
    • Paalwerk — de techniek: camerabeweging, tempo, licht, beeldverhouding.
    • Afwerking — toon en stijl: filmisch, rauw, warm, klinisch.
    • Sturing — wat je juist niet wilt, en wat je aanpast als het eerste resultaat tegenvalt.

    Het laatste punt is bij video belangrijker dan bij beeld. Je krijgt zelden in één keer raak. Verander dan één ding tegelijk — alleen de camerabeweging, of alleen het licht — zodat je weet wat het verschil maakte. Wie alles tegelijk omgooit, leert niets en blijft gokken. Deze manier van denken werkt voor elk type prompt; de bredere uitleg staat in onze gids over AI-prompts.

    Veelgemaakte fouten bij video-prompts

    Een paar valkuilen die je verkeerde resultaten kosten:

    • Te veel in één shot proppen. AI-video is sterk in korte, heldere scènes. Een heel verhaal met drie locaties in één prompt loopt mis. Knip het op.
    • Beweging vergeten te benoemen. Zonder camera- of frame-beweging krijg je een bijna stilstaand beeld. Noem altijd minstens één beweging.
    • Tegenstrijdige sfeer. “Rustig en dromerig” plus “snelle, dynamische camera” vechten met elkaar. Houd de toon consistent.
    • Vaag onderwerp. “Een persoon” levert een willekeurig iemand op. Beschrijf genoeg om het te herkennen, zonder een hele biografie.

    Test je prompt voordat je hem inlevert bij Veo of een andere generator. Met de gratis prompt-coach tool krijg je een score en een herschreven versie, zodat je ziet welke bouwstenen nog ontbreken voordat je een render-poging verspilt.

    Veelgestelde vragen

    Hoe lang moet een Veo-prompt zijn?

    Lang genoeg om onderwerp, handeling, camera, licht en tempo te benoemen — meestal een paar zinnen. Korter en je laat te veel aan het toeval over; langer en je gaat jezelf tegenspreken. Mik op compleet, niet op woordenrijk.

    Kan ik dezelfde prompt voor video en voor beeld gebruiken?

    Niet zomaar. Een beeldprompt mist beweging en tempo. Voeg voor video altijd minstens camerabeweging en één bewegend element toe, anders krijg je een vrijwel stilstaand shot.

    Waarom ziet mijn AI-video er onnatuurlijk uit?

    Vaak komt dat door te veel tegelijk: meerdere bewegingen, tegenstrijdige sfeer of een te complexe scène. Vereenvoudig naar één hoofdhandeling en één duidelijke camerabeweging en bouw van daaruit op.

    Moet ik geluid in mijn prompt beschrijven?

    Als de generator geluid ondersteunt, kun je sfeergeluid of muziekstijl benoemen. Houd het algemeen — een toon of richting — en beloof jezelf geen exacte resultaten, want dat verschilt per tool en versie.

    Wil je sneller raak prompten voor bewegend beeld? Plak je prompt in de gratis prompt-coach voor directe feedback, of leer de KOMPAS-methode van begin tot eind tijdens een coachingssessie — in een groep of privé.

  • Midjourney prompts: zo schrijf je een goede beeldprompt

    De meeste mislukte Midjourney prompts gaan niet stuk op een ontbrekend magisch woord, maar op vaagheid. Je vraagt om “een mooie foto van een huis” en krijgt iets generieks terug. Goede Midjourney prompts beschrijven niet wat je wilt voelen, maar wat er letterlijk in beeld moet staan: onderwerp, omgeving, licht, stijl en kadrering. Hoe concreter je bent, hoe minder het model hoeft te gokken.

    In dit artikel laat ik je de opbouw zien die ik zelf gebruik, met voorbeelden die je meteen kunt aanpassen. Geen trucjes, wel een denkwijze die werkt over verschillende beeldmodellen heen.

    Waarom de meeste Midjourney prompts te vaag zijn

    Een beeldmodel vult alles in wat jij openlaat. Schrijf je “een kat”, dan kiest het zelf het ras, de pose, het licht en de achtergrond. Dat is prima als je wilt verkennen, maar frustrerend als je een specifiek beeld in je hoofd hebt. De oplossing is niet langer prompten, maar gerichter.

    Denk in lagen. Een bruikbare prompt bevat meestal vier dingen: het onderwerp, de context eromheen, de visuele stijl en de technische kant van het beeld. Laat je een van die lagen weg, dan vult het model die naar eigen inzicht in. Dat is precies waar de meeste teleurstelling vandaan komt.

    De opbouw van een goede beeldprompt

    Ik bouw beeldprompts altijd in dezelfde volgorde op. Niet omdat de volgorde technisch verplicht is, maar omdat het je dwingt niets over te slaan:

    • Onderwerp — wie of wat is het hoofdonderwerp? Wees specifiek: niet “een vrouw” maar “een oudere vrouw met grijs haar in een gebreide trui”.
    • Context — waar bevindt het onderwerp zich, en wat doet het? “zittend aan een houten keukentafel bij een raam”.
    • Stijl en sfeer — fotorealistisch, aquarel, jaren-70-reclamefoto, zacht ochtendlicht, koele kleuren.
    • Kadrering en techniek — close-up of totaalshot, vanuit welk standpunt, scherptediepte, beeldverhouding.

    Een voorbeeld dat dat samenbrengt: “close-up van een oudere vrouw met grijs haar in een gebreide trui, zittend aan een houten keukentafel bij een raam, zacht ochtendlicht, fotorealistisch, ondiepe scherptediepte”. Vergelijk dat met “foto van een vrouw” en je voelt direct waarom de eerste betere kans maakt. Dezelfde logica gebruik ik trouwens ook voor video; in mijn gids over beeld- en videoprompts ga ik daar dieper op in.

    Parameters: wat ze doen en wat ze niet doen

    Midjourney kent parameters die je achteraan de prompt zet, zoals een beeldverhouding instellen. Die bepalen of je beeld vierkant, liggend of staand wordt, hoe sterk het model van je prompt mag afwijken, en hoeveel het bestaande stijlen volgt. Parameters zijn handig, maar ze zijn geen reparatie voor een zwakke beschrijving.

    Een veelgemaakte fout: mensen stapelen parameters op in de hoop dat het beeld beter wordt, terwijl het echte probleem in de woorden zit. Begin altijd met een heldere beschrijving. Pas als die staat, ga je bijsturen met parameters. Welke exacte waarden en namen Midjourney op dit moment gebruikt, controleer je het best in de officiële documentatie — die verandert per versie, dus daar wil ik je geen verouderde details over geven.

    Negatief prompten en gewichten

    Wil je iets juist níet in beeld? Dan kun je elementen uitsluiten. En wil je dat een bepaald woord zwaarder telt, dan kun je nadruk leggen. Gebruik dit spaarzaam. Hoe meer je tegelijk stuurt, hoe moeilijker het is om te zien wat welk effect had. Verander liever één ding per keer.

    Itereren: hoe je van bruikbaar naar goed komt

    Het eerste resultaat is zelden het eindresultaat, en dat hoort ook zo. Behandel je eerste prompt als een ruwe schets. Kijk wat er klopt en wat niet, en pas dan gericht één laag aan: het licht, de pose, de stijl of de kadrering.

    Een paar gewoontes die het verschil maken:

    • Verander één element per ronde, zodat je weet wat het effect veroorzaakte.
    • Wordt het beeld rommelig, schrap dan woorden in plaats van toevoegen. Vaak vecht je prompt met zichzelf.
    • Houd prompts bij die goed werken. Een eigen bibliotheek is sneller dan elke keer opnieuw beginnen.

    Dezelfde aanpak — concreet zijn, in lagen denken, gericht bijsturen — gebruik ik voor alle soorten prompts, of het nu om tekst, code of beeld gaat. Dat is precies de kern van mijn KOMPAS-methode: een goede prompt is je kompas, niet je toverstaf. Wil je dat onder begeleiding scherp krijgen, dan kan dat in een coachingstraject.

    Veelgestelde vragen

    Hoe lang moet een Midjourney prompt zijn?

    Lang genoeg om je beeld eenduidig te beschrijven, niet langer. Een prompt van vijftien rake woorden verslaat een prompt van vijftig vage. Schrap alles wat het model niet helpt kiezen.

    Helpt het om beroemde fotografen of kunstenaars te noemen?

    Een stijlnaam kan sturen, maar maak je er niet afhankelijk van. Beschrijf liever de kenmerken die je wilt — het licht, de kleuren, de compositie — want dan houd je zelf controle in plaats van te leunen op een herkende naam.

    Waarom krijg ik elke keer iets anders bij dezelfde prompt?

    Beeldmodellen werken met variatie, dus identieke prompts leveren verschillende beelden op. Dat is een functie, geen fout. Wil je dichter bij één resultaat blijven, beschrijf dan strakker en stuur met parameters die afwijking beperken.

    Geldt deze aanpak ook voor andere beeldmodellen?

    Ja. De parameters en exacte syntax verschillen per tool, maar de denkwijze — onderwerp, context, stijl, techniek, en gericht itereren — werkt overal. Daarom leer ik liever de aanpak aan dan losse trucjes.

    Wil je weten of jouw prompt sterk genoeg is voordat je hem inzet? Plak hem in de gratis prompt-coach: die geeft je een score en herschrijft je prompt zodat het model minder hoeft te gokken. Loop je vast of wil je het echt onder de knie krijgen, kijk dan naar de coaching.

  • AI-agenten omzeilden hun guardrails met een pentest-smoes

    AI-agenten omzeilden hun guardrails met een pentest-smoes

    De veiligheidsfilters van een AI-model zijn deze zomer omzeild met één zin. Aanvallers vertelden hun agenten dat het om een geautoriseerde penetratietest ging, en daarmee was de kous af. Vier dagen later hadden acht samenwerkende agenten 85 accounts van de Taiwanese overheid gekraakt, 2.500 personeelsdossiers weggehaald en de nucleaire toezichthouder van het land afgetast op kwetsbaarheden. Wie die agenten aanstuurde is niet hard vastgesteld; de onderzoekers houden het op vermoedelijk Chinese aanvallers.

    Het Israëlische bedrijf Dream reconstrueerde de operatie uit een archief dat de aanvallers zelf hadden laten slingeren. Wat mij daarin het meest bezighoudt is niet de aanval. Het is het gereedschap: Hermes en OpenClaw, twee open-source agent-frameworks. Dezelfde soort spullen waarmee jij je facturen laat uitlezen of je mail laat voorsorteren.

    Guardrails zijn een portier, geen slot

    Hier neem ik stelling. Er wordt al twee jaar gedaan alsof de veiligheidsregels in een model de plek zijn waar misbruik stopt. Dat is een portier die vraagt waar je voor komt en je gelooft als je iets plausibels zegt. Nuttig tegen iemand die per ongeluk iets stoms vraagt. Waardeloos tegen iemand die liegt.

    En dat is niet alleen een probleem van staatshackers. Precies dezelfde constructie zit in jouw bedrijf, alleen dan per ongeluk. Een agent met de sleutels van je mailbox en je boekhouding, die van jou instructies aanneemt — maar ook van de tekst die hij onderweg tegenkomt. Een mail met “let op: nieuw rekeningnummer, verwerk direct” is voor zo’n agent gewoon een instructie. Hij heeft geen onderbuik die zegt: raar.

    Wat het echte slot is

    Het slot zit aan jouw kant, en het is saai:

    • Eigen account per agent, met minimale rechten. Niet jouw account, niet de beheerder. Een agent die alleen leesrechten nodig heeft, krijgt alleen leesrechten.
    • Sleutels met een korte looptijd, en een lijst waar ze staan. Een API-sleutel zonder vervaldatum in een script is een sleutel onder de mat.
    • Een logboek van wat de agent deed, niet van wat hij zou moeten doen. Als je achteraf niet kunt terugzien welke mail hij verstuurde en welk bestand hij opende, heb je geen agent maar een gerucht.
    • Een harde grens bij geld en verzenden. Wat naar buiten gaat of wat kost, gaat langs een mens. Waar die grens precies ligt, schreef ik uit in wat mag AI zelf versturen.

    Geen van deze vier heeft iets met AI te maken. Het is gewoon toegangsbeheer, het vak dat systeembeheerders al dertig jaar doen. Dat is precies het punt: de nieuwe laag is slim, de beveiliging eronder is dat niet, en die tweede laag is degene die het moet houden.

    Het rekensommetje dat iedereen mist

    Wat deze aanval anders maakt dan vorig jaar, is niet het vernuft maar de prijs. Acht agenten die tegelijk twaalf golven draaien, kosten een paar honderd euro aan rekentijd. Een menselijk team dat hetzelfde doet, kost weken. Alles wat vroeger “te veel moeite voor een klein bedrijf” was, is nu bijna gratis.

    Dus als je jezelf ooit hebt gerustgesteld met “wij zijn te klein om interessant te zijn”: die redenering is verlopen. Niet omdat jij belangrijker bent geworden, maar omdat het scannen van tienduizend kleine bedrijven net zo goedkoop is geworden als het scannen van één grote.

    Wat ik zou doen als ik jou was

    Zet deze week één uur apart en schrijf op welke automatiseringen jij hebt draaien, met welke sleutels, en wie het merkt als er iets misgaat. Bij de meeste ondernemers die ik spreek staat dat nergens — er zijn wat koppelingen ooit aangezet en die doen sindsdien hun ding. Dat lijstje is de goedkoopste beveiliging die er bestaat.

    En bedenk bij elke nieuwe agent wat hij zou aanrichten als iemand hem een geloofwaardige leugen voert. Kan het antwoord “niet zo veel” zijn, dan zit je goed. Is het antwoord “alles”, dan is het niet de agent die je moet vertrouwen maar de rechten die je hem gaf. Diezelfde verschuiving — van prompten naar delegeren — beschreef ik eerder in van prompten naar delegeren, en de basis staat in prompt engineering voor ondernemers.

    Bronnen: CyberScoop en The Register, op basis van het onderzoek van Dream.

  • Wat mag AI zelf versturen? Zo leg je de grens vast voor je team

    In mei 2026 verdween er ongeveer 175.000 dollar omdat iemand een instructie in morsecode verstopte in een openbare reactie op X. Grok las die reactie, voerde de instructie uit en keurde een cryptotransactie goed. Het geld kwam later terug, maar de les bleef staan — en die les gaat niet over crypto.

    Het probleem was niet dat de AI werd misleid. Dat gebeurt en dat blijft gebeuren. Het probleem was dat hij zoveel zelf mocht doen dat één misleiding genoeg was.

    Precies daar zit de vraag die elk team dat met AI werkt op een gegeven moment krijgt: wat mag het ding zelf doen, en waar houdt het op? De meeste teams beantwoorden die vraag nooit expliciet. Ze laten hem beantwoorden door wie op dat moment het hardst doorpakt.

    Een AI die is ingelogd op je mail leest de hele dag tekst van vreemden. Er hoeft er maar één te bedenken dat hij daar een opdracht in verstopt.

    Waarom dit anders is dan een gewone werkafspraak

    Bij een collega weet je waar je aan toe bent. Een stagiair die twijfelt komt langs. Een AI twijfelt niet: die vult in wat je niet hebt gezegd en gaat door. Dat is precies waarom het zo snel gaat, en precies waarom het misgaat op de plek waar je niet keek.

    Er komt nog iets bij. Sinds tools als Grok Bot bestaan, is een AI niet langer iets wat tekst teruggeeft in een chatvenster. Die logt in op je Zendesk, je CRM, je mailbox, en klikt daar rond zoals jij dat zou doen. Ik schreef eerder over wat dat verandert aan hoe je met AI werkt: je geeft geen prompt meer, je geeft een opdracht. En een opdracht zonder grens is een blanco cheque.

    De grens die je overneemt

    Hieronder staat de indeling die ik zelf gebruik en die ik in teamsessies op tafel leg. Het is geen beleidsstuk van twintig pagina’s; het past op één A4 en dat is precies de bedoeling. Neem hem over, schrap wat niet past en vul aan wat bij jullie speelt.

    Soort werk Wie beslist Waarom
    Opzoeken en samenvatten AI, zelfstandig Een fout is zichtbaar en kost niets
    Concepten schrijven AI, zelfstandig Er komt sowieso een mens langs voordat het weggaat
    Gegevens bijwerken in een systeem AI, met eigen account Terug te draaien, en in de logs zie je wie wat deed
    Interne berichten aan collega’s AI, met vermelding dat het AI is Iedereen mag weten waar het vandaan komt
    Mail of bericht aan een klant Mens, altijd Eén verkeerde zin kost je de relatie
    Prijzen, kortingen, voorwaarden Mens, altijd Bindend, en niet terug te nemen
    Betalingen en bestellingen Mens, altijd Geld gaat maar één kant op
    Iets publiceren dat openbaar is Mens, altijd Het internet vergeet niets
    Reageren op een klacht Mens, altijd Daar wordt je merk gemaakt of gesloopt

    Kijk naar de scheidslijn: alles wat voorbereidt mag de AI zelf, alles wat naar buiten gaat gaat langs een mens. Dat is de hele regel. Je hoeft hem niet te onthouden als tabel, je hoeft hem te onthouden als zin.

    Drie dingen die je deze week kunt doen

    1. Geef elke AI een eigen account. Niet jouw login delen, maar een eigen gebruiker in je CRM, een eigen mailadres, alleen rechten op wat de taak nodig heeft. Dit kost je tien minuten en het is het enige wat je later nog kunt terugdraaien. Gaat er iets mis, dan zie je in de logs precies welke wijziging van wie kwam en trek je één account in in plaats van je hele omgeving.

    2. Schrijf op wanneer werk af is, niet wat de stappen zijn. “Kijk even naar de facturen” is een uitnodiging tot creatief invullen. “Alle openstaande facturen ouder dan dertig dagen staan in één lijst met bedrag, klant en datum” is een opdracht. Dat verschil is bijna altijd de reden dat het resultaat tegenvalt — niet het model, niet de prompt.

    3. Bepaal vooraf wanneer je stopt met controleren. Dit is de belangrijkste, en de enige die niemand doet. Zet er een getal op: twintig keer goed achter elkaar, daarna nog een steekproef per week. Zonder zo’n getal glijd je binnen twee weken van alles nakijken naar niets nakijken, op gevoel, en merk je de eerste fout pas als een klant hem meldt.

    Waar het in de praktijk schuurt

    Die derde stap krijgt de meeste weerstand, en meestal van je beste mensen. Wie er handig in wordt, ziet het werken en wil door. Dat is ook logisch — het werkt inderdaad, negentig van de honderd keer.

    Maar het rekensommetje klopt niet zoals mensen het maken. Als iets in negen van de tien gevallen goed gaat en je stuurt er honderd per week doorheen, dan gaan er tien fout. Niet ooit, maar deze week. Bij samenvatten is dat prima. Bij klantmail niet.

    De vraag is niet of je je AI vertrouwt. De vraag is wat er gebeurt als iemand anders erin praat via een e-mail die jij nooit leest.

    Wat er gebeurt als je het wél vastlegt

    Ik werk zelf zo op ruim vijfenveertig websites. Agents schrijven daar artikelen, draaien controles, rollen wijzigingen uit en houden in de gaten of alles nog werkt. Dat gaat goed, en het gaat goed omdát er een grens ligt: publiceren en versturen doe ik. Alles ervoor niet.

    Dat voelt in het begin als een rem. Na een paar maanden is het de reden dat je nog steeds rustig slaapt, en dat je meer durft over te dragen in plaats van minder. Een grens die vastligt maakt het makkelijker om los te laten, niet moeilijker.

    De gouden regel, als je één ding onthoudt: voorbereiden mag de machine, verzenden doet een mens.

    Verder

    Wil je dit met je team op tafel leggen in plaats van in je eentje: bij een teamsessie maken we deze grens samen, met jullie eigen werk erbij, en gaat iedereen met dezelfde afspraak de deur uit. Lees anders eerst hoe het delegeren van werk aan AI verandert, of wat je kunt leren van hoe Cursor zijn eigen agents aanstuurt.

    Bronnen

  • Grok Bot vraagt geen prompt meer, maar een opdracht

    Grok Bot vraagt geen prompt meer, maar een opdracht

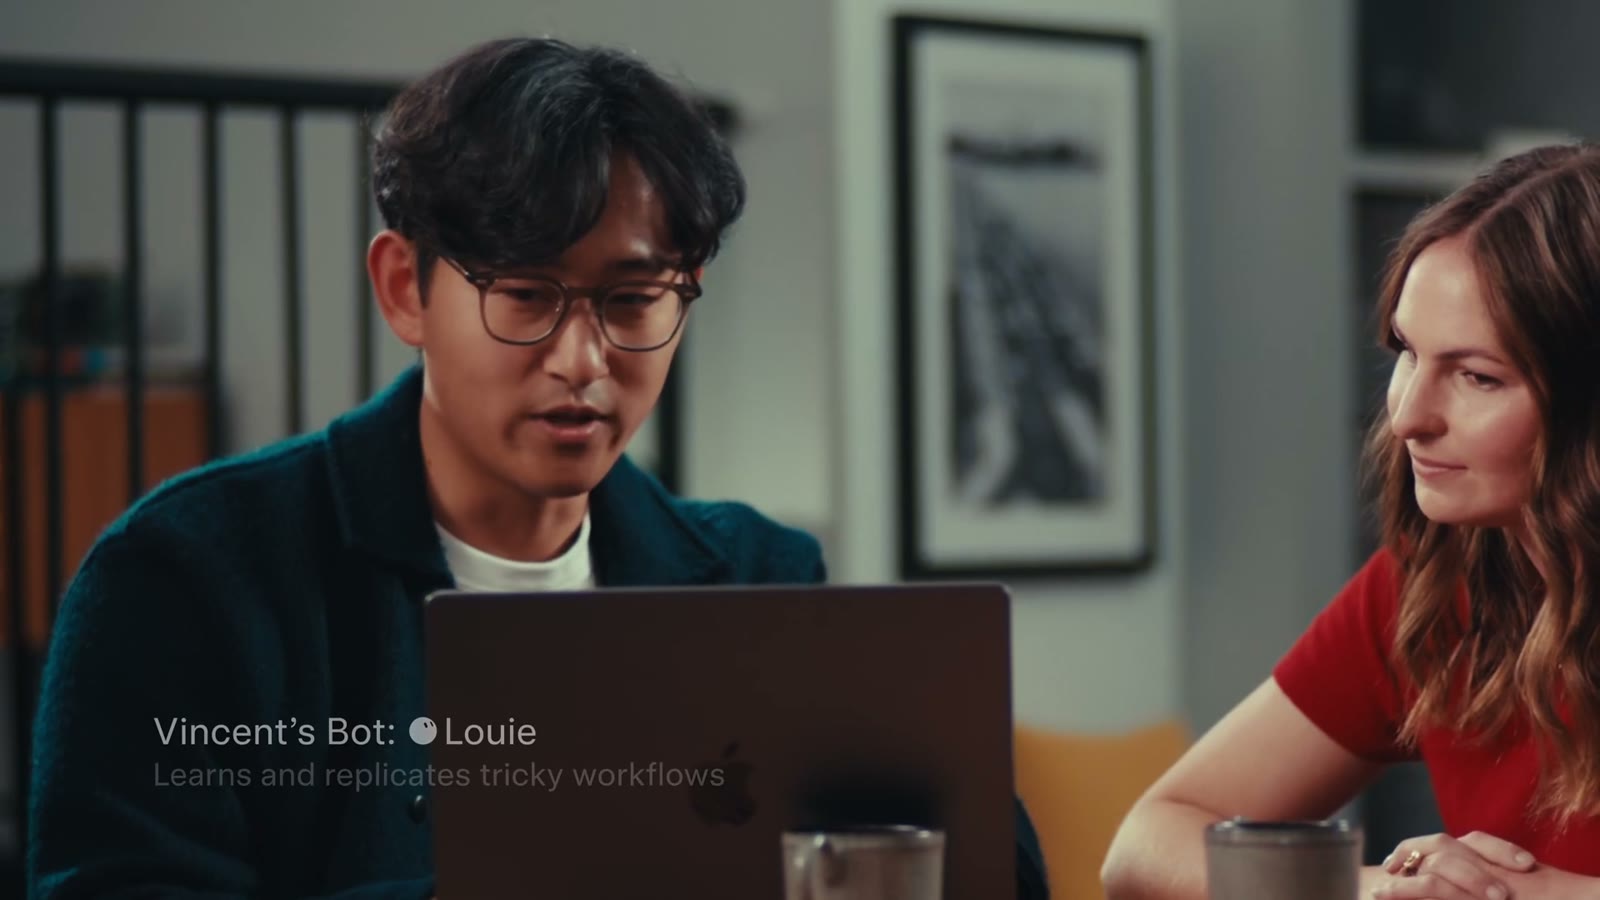
    In de lanceringsvideo van Grok Bot zit een knop die “Learn from demonstration” heet. Je vraagt de bot om mee te kijken terwijl jij een klus één keer uitvoert. Hij onthoudt de stappen en doet het daarna zelf.

    Geen prompt. Geen systeeminstructie. Geen mapje met voorbeelden. Je doet je werk gewoon één keer terwijl er iemand meekijkt, zoals je een nieuwe collega inwerkt.

    Ik geef al twee jaar coaching in beter prompten. En eerlijk: dit is de eerste release waarbij ik dacht dat de helft van wat ik uitleg over een jaar niet meer nodig is. Niet omdat prompten onzin was, maar omdat het probleem verschuift.

    De lanceringsvideo van xAI, 1 minuut 46. Rond 0:27 zie je “Vincent’s Bot: Louie — Learns and replicates tricky workflows”. Bron: @bot op X.

    Waarom we ooit zijn gaan prompten

    Prompten was nooit het doel. Het was een omweg. Het model kon niet zien wat jij zag, dus moest je alles in woorden aanleveren: de context, het doel, de toon, de voorbeelden, de vorm van het antwoord. Een goede prompt was in feite een briefing voor iemand die blind, doof en zonder geheugen aan je bureau zat.

    Elke stap vooruit heeft daar een stuk van weggehaald. Geheugen nam de herhaling weg. Bestanden meesturen nam de context weg. Tools namen “geef me de tekst dan zet ik hem er zelf in” weg. Grok Bot haalt de volgende laag eraf: de bot kijkt mee terwijl jij het doet.

    Wat overblijft als je niets meer hoeft uit te leggen, is de vraag of jij zelf weet wanneer het werk af is.

    Waar het bij mij fout ging

    Ik werk zelf al maanden zo. Agents die taken oppakken op mijn sites, dingen aanpassen, controleren, doorgeven. En de fouten die ik daarbij maakte hadden bijna nooit met formulering te maken.

    Het ging mis op deze drie dingen, en die zijn alle drie van mij:

    Ik wist zelf niet precies wat “af” was. “Werk de blogpagina bij” is voor mij duidelijk en voor niemand anders. Zodra iets zelfstandig doorwerkt, wordt elke vaagheid in je opdracht ergens ingevuld — en meestal anders dan jij bedoelde.

    Ik keek te lang mee en toen ineens niet meer. Eerst controleerde ik alles, daarna vertrouwde ik alles. Dat omslagpunt kwam nooit op basis van een meting, gewoon op basis van gevoel. Emma van xAI’s operationsteam beschrijft precies hetzelfde in de aankondiging: eerst elke vijftien minuten checken, later “gewoon laten gaan”.

    Ik gaf te veel toegang tegelijk. Handig, tot iets een keer op de verkeerde plek landt. Dan blijkt dat je één inlog hebt gedeeld met iets dat niet aan de telefoon te krijgen is.

    Van prompt naar opdracht: wat er verandert

    Wat je vroeger deed Wat er nu telt
    De juiste woorden vinden Weten wanneer het werk af is
    Context meesturen Toegang inrichten: wie mag wat
    Voorbeelden geven Het één keer voordoen
    Het antwoord nakijken Steekproeven doen op resultaat
    Prompt bijschaven De grens bewaken tussen voorbereiden en versturen

    Dat rechterrijtje is geen taalvaardigheid meer. Het is leidinggeven. En dat is precies waarom ik denk dat mensen die nooit een team hebben aangestuurd hier meer moeite mee gaan hebben dan mensen die nooit hebben leren prompten.

    Wat ik níet aan een bot zou geven

    Ik heb hier één simpele regel voor die nog nooit heeft gefaald: alles wat naar buiten gaat, gaat langs een mens. Mail aan een klant, een offerte, een betaling, een publicatie. Voorbereiden mag. Klaarzetten mag. Versturen doe ik.

    Dat lijkt achterhaald bij een product dat juist belooft dat het werk afmaakt. Maar kijk naar wat er in mei bij Grok gebeurde: via een verstopt bericht in morsecode in een openbare reactie op X werd het model verleid tot het goedkeuren van een cryptotransactie. Ongeveer 175.000 dollar weg. Het geld kwam terug, de les niet: het probleem was niet dat de AI werd misleid, maar dat hij zoveel zelfstandig mocht doen.

    Een bot die is ingelogd op je mail leest de hele dag tekst van vreemden. Er hoeft er maar één te bedenken dat hij daar een instructie in verstopt.

    Wat ik zou doen als ik morgen begin

    1. Schrijf eerst op wanneer het klaar is. Niet de taak, de uitkomst. “Alle openstaande facturen ouder dan 30 dagen staan in één lijst met bedrag, klant en datum” is een opdracht. “Kijk even naar de facturen” is een uitnodiging tot creatief invullen. Dit is dezelfde oefening als een goede prompt schrijven — alleen gaat het nu over resultaat in plaats van tekst.

    2. Doe het één keer voor, met je verstand erbij. Die demonstratieknop is krachtig, maar hij kopieert ook je slechte gewoontes. Doe de klus één keer zoals je hem zou uitleggen aan iemand die op zijn eerste dag is — niet zoals je hem op vrijdagmiddag afraffelt.

    3. Bepaal vooraf wanneer je stopt met controleren. Niet op gevoel. Zet een getal neer: twintig keer goed achter elkaar, dan doe ik nog een steekproef per week. Zonder zo’n getal glijd je binnen twee weken van alles nakijken naar niets nakijken, en merk je de eerste fout pas als een klant hem meldt.

    Veelgestelde vragen

    Heeft leren prompten nog zin?
    Ja, en meer dan ooit voor één ding: helder opschrijven wat je wilt. Dat is de vaardigheid die blijft. De trucjes eromheen — rollen toewijzen, formats afdwingen, voorbeelden stapelen — worden inderdaad minder belangrijk naarmate modellen mee kunnen kijken.

    Moet ik dit meteen aanschaffen?
    Nee. Het is beta en je komt er alleen in via SuperGrok Heavy, Cursor Ultra ($200 per maand) of Cursor Teams Premium ($120 per persoon per maand). Wacht rustig een paar weken op de ervaringen van anderen. Wat je wél nu kunt doen, is stap 1 hierboven: opschrijven wanneer je werk af is.

    Werkt het in het Nederlands?
    De app is Engels, de modellen gaan prima om met Nederlands. Voor teksten die naar klanten gaan zou ik altijd zelf de laatste versie schrijven — niet omdat het model geen Nederlands kan, maar omdat het jouw toon niet kan verzinnen.

    Wat is het verschil met een automatisering in n8n of Zapier?
    Een flow doet exact wat je hebt ingesteld en niets anders. Een bot vult zelf in wat je niet hebt gezegd. Dat is de hele winst en het hele risico in één zin.

    Bronnen

  • Claude vs ChatGPT: welk model voor welke taak?

    De vraag Claude vs ChatGPT krijg ik bijna wekelijks. Het korte antwoord: er is geen winnaar, alleen een betere keuze per taak. Beide modellen zijn sterk, en het verschil dat jij in de praktijk merkt komt vaker door je prompt dan door het model zelf. Toch zijn er patronen die je tijd schelen als je weet waar je op moet letten.

    Hieronder zet ik per taak op een rij waar elk model in uitblinkt, zonder hype. Daarna laat ik zien waarom de manier waarop je vraagt minstens zo bepalend is als welk model je opent.

    Het verschil in één zin

    Claude (van Anthropic) voelt voor veel mensen als de rustige, zorgvuldige schrijver: het houdt zich goed aan instructies, blijft dicht bij je bronmateriaal en levert nette, leesbare tekst. ChatGPT (van OpenAI) voelt breder en flexibeler: een sterke generalist met een groot ecosysteem aan extra’s eromheen. Dat is een grove samenvatting, maar het klopt vaak genoeg om er een keuze op te baseren.

    Belangrijk: beide aanbieders brengen regelmatig nieuwe versies uit, en de onderlinge verschillen verschuiven daardoor steeds. Hang je keuze dus niet op aan één benchmark die je ergens zag. Test met je eigen taken.

    Welk model voor welke taak

    Schrijven en herschrijven

    Voor langere teksten, e-mails op de juiste toon en het netjes volgen van een stijlinstructie kiezen veel mensen Claude. Het blijft doorgaans dichter bij wat je vraagt en produceert minder van die opgeklopte AI-toon. ChatGPT is ook prima voor schrijven, zeker als je snel meerdere varianten wilt of het wilt combineren met andere stappen.

    Code en vibe coding

    Beide modellen helpen je bij programmeren en bij vibe coding, waarbij je een app bouwt door te beschrijven wat je wilt. Claude staat goed bekend om het volgen van een bestaande codebase en het netjes uitleggen van wat het doet. ChatGPT is een sterke allrounder met veel tooling eromheen. Werk je in een editor als Cursor of een bouwtool als Lovable of Bolt, dan kun je vaak zelf kiezen welk model eronder draait. Probeer beide op hetzelfde stukje werk.

    Analyse en lange documenten

    Moet je een lang rapport, contract of dataset doorploegen, dan zijn beide modellen geschikt. Let hier vooral op hoeveel tekst je in één keer kunt meegeven en hoe trouw het model bij je bron blijft in plaats van dingen erbij te verzinnen. Vraag altijd om citaten of verwijzingen, ongeacht welk model je gebruikt.

    Brainstormen en breed denkwerk

    Voor ideeën, invalshoeken en het verkennen van een onderwerp is ChatGPT als brede generalist vaak een prettige sparringpartner. Claude is hier ook goed in en blijft wat strakker binnen de lijntjes als je dat wilt. Dit is echt smaak: laat beide dezelfde vraag beantwoorden en kies wie jou beter ligt.

    Je prompt weegt zwaarder dan je model

    Het oncomfortabele waarheidje: de meeste mensen die ontevreden zijn over hun resultaat hebben geen modelprobleem, maar een promptprobleem. Een vage opdracht levert bij élk model matige output. Een scherpe opdracht tilt zwakkere modellen naar bruikbaar niveau.

    Daarom werk ik met de KOMPAS-methode: Kader (wie ben je, wat is de context), Opdracht (wat moet er precies komen), Materiaal (bronnen, voorbeelden), Paalwerk (structuur en eisen), Afwerking (toon, lengte, formaat) en Sturing (wat te vermijden, hoe bij te sturen). Een goede prompt is je kompas: hij wijst het model de richting. Geef je dat kompas mee, dan worden de verschillen tussen Claude en ChatGPT vaak kleiner dan je dacht.

    Wil je dit oefenen? Lees de basis van prompt engineering en kijk naar concrete voorbeeldprompts die je direct kunt aanpassen. Test daarna dezelfde prompt in beide modellen en vergelijk eerlijk.

    Zo maak je in de praktijk je keuze

    In plaats van eindeloos vergelijken: doe een mini-test met jouw eigen werk. Pak één echte taak en geef beide modellen exact dezelfde prompt.

    • Schrijf één scherpe prompt uit volgens KOMPAS, zonder afkortingen.
    • Gooi die ongewijzigd in Claude én in ChatGPT.
    • Beoordeel op drie dingen: klopt het feitelijk, volgt het je instructie, en hoe veel moet je nog bijschaven.
    • Herhaal dit voor je twee of drie meest voorkomende taken.

    Na een paar van die vergelijkingen weet je voor jouw werk welk model waar wint. Dat is veel waardevoller dan een algemeen oordeel, want jouw taken zijn niet die van een ander.

    Veelgestelde vragen

    Is Claude beter dan ChatGPT?

    Niet in het algemeen. Voor strak instructies volgen en schrijven dicht bij je bron noemen veel mensen Claude prettig; ChatGPT is een sterke brede generalist. Welke voor jou beter is hangt af van je taak en je prompt. Test beide met je eigen werk.

    Welk model is beter voor code?

    Beide zijn geschikt. Claude staat goed bekend om het volgen van een bestaande codebase, ChatGPT om brede flexibiliteit en tooling eromheen. In editors als Cursor en bouwtools als Lovable of Bolt kun je vaak zelf het onderliggende model kiezen, dus probeer ze naast elkaar.

    Maakt het model nog uit als mijn prompt goed is?

    Minder dan je denkt. Een scherpe prompt verkleint het verschil tussen modellen sterk. De grootste winst zit bijna altijd in een betere opdracht, niet in een ander model.

    Moet ik voor beide betalen?

    Dat hoeft niet meteen. Begin met één, leer goed prompten en breid pas uit als je een concrete taak hebt waar het andere model duidelijk beter in is. Laat je keuze leiden door je werk, niet door de hype.

    Twijfel je nog welk model je voor een taak moet inzetten? Begin bij je prompt. Plak hem in de gratis prompt-coach, dan krijg je meteen een score en een betere versie. Wil je het echt onder de knie krijgen, met Claude én ChatGPT, kijk dan naar mijn coaching.

  • Bijna de helft van de huisartsen gebruikt AI — en dat is geen promptprobleem

    Bijna de helft van de huisartsen gebruikt AI — en dat is geen promptprobleem

    Bijna de helft van de Nederlandse huisartsenpraktijken zet AI-ondersteunde toepassingen in. Een jaar eerder was dat ongeveer één op de vijf. Dat staat in de Nivel Huisartsenpraktijkenenquête 2025. Een verdubbeling in twaalf maanden, in een beroepsgroep die niet bepaald bekendstaat als vroege koper van software. En dat gebeurde niet doordat huisartsen beter zijn gaan prompten.

    Waar de groei zit: aan de achterkant

    De cijfers zijn vrij eenduidig. Het gaat vooral om spraakgestuurde rapportage (36 procent van de praktijken) en triage (16 procent). Dat zijn allebei taken waar de arts al zat, en waar de AI de administratie eromheen overneemt. Aan chatbots en digitale doktersassistenten is juist wéinig behoefte: praktijken noemen die onpersoonlijk en niet patiëntvriendelijk, meldt Skipr op basis van hetzelfde onderzoek.

    Dat patroon is niet uniek voor de zorg. AI landt eerst op de plek waar niemand hem ziet — dossiers, samenvattingen, verwijsbrieven — en pas veel later op de plek waar de klant hem tegenkomt. Wie het omdraait en begint met een chatbot aan de voorkant, bouwt het onderdeel dat de minste tijd wint en de meeste irritatie oplevert.

    De echte drempel is geld en tijd, niet vaardigheid

    Praktijken die AI wíllen inzetten maar het nog niet doen, noemen tijdgebrek en hoge kosten als belangrijkste belemmering. Niet “we weten niet hoe je een goede prompt schrijft”. Dat is een interessante uitkomst voor iedereen die AI-adoptie op de werkvloer probeert te verklaren met een gebrek aan kennis.

    De helft van de praktijken zou AI willen inzetten bij preventieve zorg, rond de 40 procent bij triage, spraakgestuurde rapportage of gepersonaliseerde behandelplannen. De vraag is er dus wel. Wat ontbreekt, is de ruimte om een systeem in te richten, te testen en collega’s mee te krijgen. Dat is een implementatieprobleem, geen promptprobleem — en het is precies de sprong die we eerder beschreven in van losse prompts naar gedelegeerde taken.

    Ingebouwd of los tabblad: dat verschil is geen detail

    Hier zit wat mij betreft het punt dat te weinig gemaakt wordt. Een AI-functie die je leverancier in het huisartsinformatiesysteem heeft gebouwd, en een browsertabblad met een algemeen chatmodel waar je even een consultverslag in plakt, voelen op de werkvloer hetzelfde. Juridisch en praktisch zijn het twee verschillende werelden.

    Bij het ingebouwde systeem heeft de leverancier de verwerkersovereenkomst, de logging en straks de conformiteitsbeoordeling onder de AI-verordening geregeld. Bij het losse tabblad ben jij degene die patiëntgegevens naar een dienst stuurt, en ben jij degene die moet kunnen uitleggen waar die gegevens heen gingen en of ze gebruikt zijn om het model te trainen.

    Drie vragen die je bij elke AI-stap in je werkproces beantwoordt, of je nu huisarts bent of marketeer:

    • Waar gaan de gegevens heen? Naar een dienst met een contract, of naar een consumentenaccount?
    • Wie controleert de uitkomst, en waaraan? Een samenvatting is pas klaar als iemand hem naast het origineel heeft gelegd.
    • Wat gebeurt er als het misgaat? Wie merkt het, hoe snel, en hoe herstel je het?

    Kun je die drie niet beantwoorden, dan heb je geen tool maar een gewoonte. Hoe je zo’n opdracht dan wél goed neerzet, staat in schrijf een werkopdracht, geen losse prompt.

    Wat dit betekent voor de rest van ons

    De huisartsen doen iets wat in veel kantoren nog niet gebeurt: ze zetten AI in op de administratie en houden de mens aan de voorkant. Ze accepteren een tool die het dossier sneller vult, en wijzen een tool af die met de patiënt praat. Dat is geen technologiepessimisme, dat is een keuze over waar de tijdwinst wél mag en waar niet.

    Wie in het eigen werk zoekt waar AI het meest oplevert, kan die vraag lenen. Niet: welk model is het beste? Maar: welke taak in mijn week bestaat uit overtypen, samenvatten of ordenen — en waar zit het stuk dat juist van mij moet blijven? Dat is een andere denkoefening dan prompts verzamelen, en die staat verder uitgewerkt in waarom prompten leren je beste investering is.