Auteur: Sam

  • App bouwen zonder code met AI: zo begin je

    Een app bouwen zonder code met AI kan echt — je beschrijft in gewone taal wat je wilt, en een AI-tool zet dat om in een werkende applicatie. Geen jaren leren programmeren, geen dure ontwikkelaar. Maar er zit een addertje onder het gras: het resultaat is precies zo goed als jouw instructies. Wie vaag prompt, krijgt een wankel prototype. Wie scherp prompt, krijgt iets bruikbaars.

    In dit artikel lees je waar je begint, welke soort tools er zijn, en — het belangrijkste — hoe je ze aanstuurt zodat je niet na een uur vastloopt.

    Wat betekent “app bouwen zonder code” eigenlijk?

    Je typt wat je voor ogen hebt, de AI genereert de code, de interface en vaak ook de database eronder. Jij stuurt bij in gewone taal: “maak de knop groen”, “voeg een inlogscherm toe”, “die lijst moet alfabetisch”. Dit heet ook wel vibe coding: je bouwt op gevoel en richting, niet op syntax.

    Belangrijk om te weten: zonder code wil niet zeggen zonder denkwerk. Je hoeft geen programmeertaal te kennen, maar je moet wél helder krijgen wát je wilt, voor wie, en hoe het zich moet gedragen. Dat helder krijgen en goed overbrengen is een vaardigheid op zich. Wil je dieper begrijpen hoe dit werkt, lees dan eerst wat vibe coding is voordat je een tool opent.

    Welke soort tools zijn er?

    Grofweg twee smaken, en het verschil bepaalt waar je begint.

    AI-bouwers die voor je coderen

    Tools als Cursor, Lovable en Bolt nemen je beschrijving en bouwen er een echte applicatie van. Je praat in chat, zij produceren code en een live voorbeeld. Lovable en Bolt zijn gericht op snel een werkende web-app neerzetten in je browser. Cursor is een code-editor met AI ingebouwd: krachtiger en flexibeler, maar je ziet wel echte codebestanden — handig als je een stap verder wilt, even wennen als je dat liever niet ziet. Twijfel je tussen deze drie, lees dan de vergelijking van Cursor vs Lovable vs Bolt.

    Klassieke no-code platforms

    Daarnaast bestaan er visuele bouwers waar je blokken sleept in plaats van prompt. Die geven meer controle over de vormgeving, maar je bent gebonden aan wat het platform aanbiedt. De AI-bouwers zijn vrijer, omdat ze echte code genereren.

    Mijn advies om te starten: kies een AI-bouwer die in je browser draait, zodat je meteen een resultaat ziet zonder iets te installeren. Begin klein. Eén scherm, één functie. Pas uitbreiden als dat werkt.

    Zo begin je: vier stappen

    Niet meteen typen “bouw een app voor mij”. Doe dit:

    • Beschrijf het doel in één zin. Wat moet de gebruiker kunnen na het gebruik? Bijvoorbeeld: een gast kan zich aanmelden voor mijn workshop en krijgt een bevestiging.
    • Som de schermen op. Welke pagina’s of stappen zijn er? Aanmeldformulier, overzichtspagina, bedankscherm. Houd het minimaal.
    • Geef context mee. Voor wie is het, welke stijl, welke data wordt opgeslagen. Hoe meer de AI weet, hoe minder hij gokt.
    • Bouw in kleine rondes. Vraag één ding tegelijk. Test. Pas dan de volgende toevoeging. Een grote prompt vol eisen geeft een grote brij aan fouten.

    Loopt iets niet zoals bedoeld? Zeg precies wat je ziet én wat je verwacht: “de knop doet niets als ik klik — hij moet het formulier verzenden.” Vaag klagen helpt de AI niet; concreet beschrijven wel.

    De prompt is je kompas

    Hier valt of staat alles. Dezelfde tool geeft de één een nette app en de ander een chaos — het verschil zit in de prompts. Daarom werk ik met de KOMPAS-methode: een goede prompt is je kompas. Je geeft Kader (wat bouw je en voor wie), de Opdracht (wat moet de AI nu doen), Materiaal (voorbeelden, data, stijl), Paalwerk (de structuur en grenzen), Afwerking (toon en vorm) en Sturing (bijsturen op wat je terugkrijgt).

    Dat klinkt als veel, maar in de praktijk scheelt het je uren foutzoeken. Wil je zien hoe sterk je huidige prompts zijn? Plak ze in de gratis prompt-tool — die scoort je prompt en herschrijft hem direct. Een goed startpunt voordat je je app gaat bouwen.

    Waar het meestal misgaat

    De drie valkuilen die ik het vaakst zie bij beginners:

    • Te veel in één keer vragen. Tien eisen in één prompt levert tien half-werkende dingen op. Bouw in lagen.
    • Niet testen tussendoor. Als je pas na twintig wijzigingen kijkt, weet je niet meer wélke wijziging iets brak.
    • Aannemen dat de AI je gedachten leest. Hij weet niet dat je bedoelt “voor een Nederlandse bakkerij met online bestellen” als je alleen “een bestel-app” typt.

    Wie deze drie vermijdt, komt al een heel eind. Het echte leren zit in het oefenen met je eigen idee. Verder komen met de techniek zelf? Dan helpt het om vibe coding stap voor stap te leren, zodat je niet bij elke hobbel vastloopt.

    Wat kost een AI-app maken, en hoe lang duurt het?

    Over geld en tijd, want dat wil iedereen weten. De meeste AI-bouwers hebben een gratis instap om te oefenen; zodra je serieus bouwt (eigen domein, meer capaciteit, meer controle) betaal je een maandelijks abonnement, en de prijs verschilt flink per tool en per gebruik. Klassieke no-code platforms rekenen ook met abonnementen die meegroeien met je app. Publiceer je in de App Store of Google Play, dan komen daar een ontwikkelaarsaccount bij (jaarlijks bij Apple, eenmalig bij Google) en een review van je app.

    Tijd is eerlijker te schatten dan geld. Je eerste werkende prototype staat er met wat voorbereiding in een middag, omdat de vier stappen hierboven klein houden. Een app die je aan klanten geeft, met inlog, betaling en foutafhandeling, vraagt weken van bijschaven en testen. Dat is geen tegenvaller maar de normale verhouding: bouwen gaat snel, afronden kost de meeste tijd.

    Veelgestelde vragen

    Heb ik echt geen programmeerkennis nodig?

    Voor een eenvoudige app niet. Je beschrijft in gewone taal wat je wilt en de AI bouwt het. Wel helpt het enorm als je leert duidelijk en gestructureerd prompten — dat bepaalt de kwaliteit van het resultaat meer dan technische kennis.

    Welke tool kan ik het beste als beginner gebruiken?

    Begin met een AI-bouwer die in je browser draait, zodat je direct resultaat ziet zonder installatie. Lovable en Bolt zijn toegankelijk voor een snelle web-app; Cursor is krachtiger als je een stap verder wilt. Kies er één en blijf erbij tijdens je eerste project.

    Wordt mijn app meteen professioneel?

    Reken op een werkend prototype, geen kant-en-klaar eindproduct. Voor iets dat je echt aan klanten geeft, is bijschaven nodig: foutafhandeling, beveiliging, vormgeving. AI brengt je snel ver, maar de laatste tien procent vraagt aandacht.

    Kan ik ook een app voor iPhone of Android maken zonder code?

    Ja, met een kanttekening. AI-bouwers als Lovable en Bolt maken web-apps die in de browser werken en op mobiel goed meekomen. Voor een echte app in de App Store of Google Play gebruik je meestal een no-code platform met app-publicatie, of je zet je web-app om naar een app-wrapper. De stap naar de app store vraagt om een ontwikkelaarsaccount en een beoordelingsronde.

    Hoeveel kost een app bouwen zonder code?

    Voor een eerste prototype vaak niets, want de meeste tools hebben een gratis instap. Voor serieus gebruik betaal je een maandelijks abonnement aan je bouwtool, en app-store-publicatie brengt de ontwikkelaarsaccount-kosten mee. Hoeveel dat totaal is hangt af van je toolkeuze en gebruik; vergelijk de actuele prijzen op de site van de tool zelf.

    Hoe voorkom ik dat ik vastloop?

    Bouw in kleine stappen, test na elke wijziging, en beschrijf problemen concreet (“knop doet niets bij klik” in plaats van “het werkt niet”). En zorg dat je prompts scherp zijn — daar begint het.

    Klaar om te starten? Test eerst je prompt in de gratis prompt-coach en bouw daarna je eerste scherm. Wil je het sneller onder de knie krijgen, met iemand die meekijkt? Bekijk de coaching — in groep of privé leer je precies prompten zodat je app in één keer goed staat. Pak je het bouwen samen met je team op, kijk dan naar de AI-training voor teams.
    Verder lezen

    Vibe coding werkt pas goed als de scope klein genoeg is. Een werkende demo is geen eindpunt; de check zit in testen, uitleggen en veilig publiceren. Lees daarna ook start met vibe coding leren of kies daarna je tool.

  • Van betere prompts naar een écht AI-voordeel: de les van Satya Nadella voor serieuze AI-gebruikers

    Door de redactie · 14 juni 2026

    TL;DR In een lang bericht op X legde Microsoft-CEO Satya Nadella uit waarom de huidige AI-transitie fundamenteel anders is dan eerdere platformverschuivingen. Bedrijven (en professionals) moeten niet alleen menselijk kapitaal beheren, maar ook “token capital”: de AI-capaciteit die je zelf bouwt en bezit. Voor iedereen die prompts, agents en AI-tools professioneel gebruikt, betekent dit een verschuiving. Betere prompts en slimmere modelkeuzes zijn nuttig, maar op den duur onvoldoende. De echte voorsprong komt van het systematisch vastleggen van je eigen expertise, oordelen en resultaten in systemen die blijven verbeteren — een leerlus die alleen van jou is.

    De aanleiding

    Op 14 juni 2026 deelde Satya Nadella een uitgebreide reflectie op de toekomst van organisaties in een door AI gedreven economie. Het bericht is opvallend strategisch en waarschuwend van toon.

    Hij beschrijft dat eerdere digitale transities vooral gingen over het versterken van menselijk kapitaal met tools. Deze transitie creëert een directe “cognitive loop” tussen mensen en digitale systemen. Dat verandert hoe kennis wordt vastgelegd, hoe organisaties leren en hoe waarde wordt verdeeld.

    Het centrale nieuwe begrip: human capital (kennis, oordeel, relaties, patroonherkenning van mensen) én token capital (de AI-capaciteit die een organisatie of individu zelf bouwt en bezit). Mensen blijven de richting aangeven; zonder menselijke sturing draaien de systemen in het rond. Maar de organisaties die hun menselijke expertise omzetten in verbeterende AI-systemen, bouwen een compounding voordeel op.

    Het risico dat hij noemt is scherp: als alle waarde naar een klein aantal frontier-modellen vloeit terwijl de rest van de economie haar kennis laat commoditiseren, ontstaat een situatie zonder maatschappelijk draagvlak — vergelijkbaar met de uitholling die globalisering en outsourcing in sommige sectoren veroorzaakten.

    Het grotere verhaal: prompts zijn geen strategie

    Voor mensen die professioneel met AI werken — of dat nu als coach, consultant, power user, teamlead of ondernemer is — voelt dit als een bevestiging van iets wat al langer in de lucht hangt.

    De eerste golf van AI-adoptie ging over toegang en prompting. Iedereen leerde hoe je betere instructies geeft, chain-of-thought toepast, few-shot voorbeelden gebruikt, rollen definieert en modellen vergelijkt. Dat leverde echte productiviteitswinsten op.

    De tweede golf ging over agents en workflows: in plaats van een eenmalige vraag, bouw je multi-step systemen die tools aanroepen, context ophalen en acties uitvoeren.

    Wat Nadella nu benadrukt, is de derde laag: de leerlus eromheen. Niet alleen wat je een model vraagt, maar wat je terugkrijgt, hoe je dat beoordeelt, hoe je je eigen correcties en domeinspecifieke kennis vastlegt, en hoe je dat alles gebruikt om het systeem de volgende keer beter te maken — specifiek voor jouw werk, jouw klanten, jouw domein.

    Een betere prompt is een tactische verbetering. Een eigen leerlus is een strategisch asset.

    Je kunt een taak of zelfs een hele job “offloaden” naar AI, maar je kunt je leren nooit offloaden. Dat is de kernzin uit het bericht. Wie alleen consumeert wat generieke modellen produceren, bouwt geen eigen vermogen op. Wie zijn eigen oordelen, correcties, klantcontext en resultaten structureel terugvoert in zijn systemen, bouwt iets op dat compoundeert.

    Van losse prompts naar een “hill climbing machine” voor je eigen expertise

    Nadella noemt het beeld van een “hill climbing machine” die elke verbeterde workflow omzet in beter trainingssignaal, wat leidt tot snellere opbouw van unieke, taciete kennis.

    Voor professionals en coaches die met AI werken, ziet dat er in de praktijk ongeveer zo uit:

    • Je legt niet alleen de prompts vast, maar ook de context die je meegeeft (klantdata, eerdere beslissingen, domeinspecifieke regels, toonvoorkeuren).
    • Je definieert evaluatiecriteria die écht voor jouw werk tellen (niet alleen “is het grammaticaal correct en klinkt het aardig”, maar “past dit bij de specifieke situatie van deze klant en levert het het gewenste resultaat op?”).
    • Je registreert systematisch waar het model goed presteert en waar het faalt of hallucineert, en je gebruikt die informatie om instructies, retrieval of agent-logica aan te passen.
    • Je bouwt een groeiende, eigen kennisbank van “hoe wij dit doen” die je agenten en prompts steeds sterker maakt, onafhankelijk van welk onderliggend model je op dat moment gebruikt.

    Dit is precies de “company veteran” expertise die je niet wilt verliezen als je van model wisselt. Het is ook de reden waarom veel serieuze gebruikers al experimenteren met memory, vector stores, custom instructions die evolueren, en feedbackmechanismen in hun tools.

    De verschuiving is van “ik ben goed in prompts” naar “ik bouw en bezit een systeem dat mijn expertise elke week beter maakt en dat ik kan meenemen”.

    Wat we (nog) niet zeker weten

    • Hoe toegankelijk deze vorm van “private evals en feedbacklussen” wordt voor individuen en kleine teams versus grote organisaties met eigen engineering resources.
    • Welke tooling het snelst volwassen wordt voor niet-technische professionals (eenvoudige interfaces voor memory, eval en feedback versus full developer stacks).
    • Hoe sterk de grote providers hun enterprise-oplossingen (Copilot Studio, custom agents, etc.) positioneren als “jouw leerlus” terwijl ze toch grotendeels op hun infrastructuur en modellen draaien.
    • Wat de werkelijke kosten en baten zijn voor een solo-professional of klein team om dit serieus op te zetten versus blijven werken met de beste beschikbare consumententools.

    Wat dit voor jou betekent als je professioneel met AI werkt

    De meeste mensen die nu “promptcoaching” of geavanceerd AI-gebruik doen, helpen anderen om beter te worden in het stellen van vragen en het structureren van interacties. Dat blijft waardevol. Maar de volgende laag is minstens zo belangrijk: helpen (of zelf) de stap maken van losse, herhaalbare prompts naar een systeem dat je eigen expertise compoundeert.

    Praktische richtingen die passen bij hoe veel power users en coaches al werken:

    1. 1. Behandel je eigen prompts, correcties en klantcases als data. Bouw (of begin klein) een persoonlijke of team-kennisbank waarin je vastlegt wat werkte, wat niet werkte, welke context cruciaal was en welke uitzonderingen je tegenkwam.
    1. 2. Definieer private evaluatiecriteria. Maak een set van 10-30 concrete scenario’s uit je eigen praktijk met een duidelijke “goede” uitkomst volgens jouw standaarden. Gebruik die regelmatig om te testen of je prompts, agents of retrieval beter worden.
    1. 3. Sluit de feedbacklus expliciet. Wanneer je een output beoordeelt, corrigeert of aanpast, zorg dat die correctie ergens terechtkomt waar je systeem er de volgende keer iets aan heeft — in een memory-laag, een updated instruction set, een retrieval document of een trainingssignaal.
    1. 4. Test model-onafhankelijkheid. Kijk of je de kern van je werk (de context, de evaluatiecriteria, de feedback) kunt verplaatsen naar een ander model of een ander platform zonder dat je alles opnieuw moet opbouwen. Dat is een sterke test voor of je écht token capital aan het opbouwen bent.

    Werk je eerst aan betere modelinstructies, begin dan met Claude prompting best practices of de promptgidsen per model. Gebruik die gidsen als opstap, niet als eindpunt.

    Mijn oordeel

    De boodschap van Nadella is ongemakkelijk maar gezond. De meeste waarde in de AI-economie zal niet zitten in wie op dit moment de beste prompts schrijft of het populairste model gebruikt. Die voorsprong is tijdelijk en makkelijk in te halen.

    De blijvende waarde zit bij wie erin slaagt zijn eigen expertise, oordelen en resultaten om te zetten in systemen die blijven leren en die alleen hij of zij echt bezit. Dat geldt voor grote bedrijven, maar net zo goed voor professionals, coaches, consultants en kleine teams.

    Prompt engineering was de eerste, noodzakelijke vaardigheid. Het opbouwen en onderhouden van een eigen leerlus is de volgende. Wie daar nu serieus mee begint — hoe klein ook — legt de basis voor een voordeel dat compoundeert in plaats van elke paar maanden opnieuw te moeten bevechten.

    Dat is wat Nadella bedoelt met human capital en token capital die elkaar versterken. En dat is de reden waarom “gewoon beter prompten” op den duur niet genoeg is.

    Bron: dit artikel is geschreven naar aanleiding van het bericht van Satya Nadella op X van 14 juni 2026. De duiding en praktische vertaling zijn eigen redactionele analyse.

    Verder lezen

    Prompt engineering wordt pas nuttig als je de fout kunt aanwijzen: ontbrekende context, verkeerde rol, geen voorbeeld of geen controle op het antwoord. Lees daarna ook bekijk de AI-prompt hub of gebruik de Prompt Coach.

  • AI-site controleren voor publicatie: 12 checks tegen frontend slop

    Een AI-site is niet klaar omdat de knop werkt. Hij is klaar als een bezoeker op mobiel begrijpt wat hij moet doen, foutmeldingen niet vreemd voelen, lange Nederlandse tekst past en de pagina nog steeds vertrouwen wekt zonder demo-content.

    Gebruik deze checklist voordat je een site uit Cursor, Lovable, Bolt, Claude Code of Codex live zet. Niet als designexamen, maar als publicatiegate: wat moet je zelf gezien hebben voordat Google en echte bezoekers de pagina zien?

    De snelle diagnose: werkt het scherm alleen in de demo?

    AI-gebouwde interfaces falen zelden op één grote fout. Het zit vaker in kleine signalen: een modal die net te hard inspringt, een button met twee regels tekst, een mobile breakpoint waar de hero over de CTA valt, of een formulier dat technisch submit maar geen geruststelling geeft.

    Dat is precies waarom “maak het mooier” geen goede prompt is. Een model vult smaakwoorden met gemiddelde patronen: veel cards, paarse glows, te ronde knoppen, vage hero-copy en componenten die afzonderlijk best oké lijken. Je moet de output niet mooier vragen. Je moet hem langs concrete constraints leggen.

    12 checks voordat je publiceert

    1. Eerste scherm: staat binnen vijf seconden duidelijk wat de bezoeker hier kan doen?
    2. Mobiel: test minimaal 390px breed. Geen overlappende hero, menu, CTA of formulierlabels.
    3. Lange Nederlandse tekst: vervang demo-copy door echte zinnen. Vooral buttons, tabs en cards breken dan snel.
    4. Contrast: check tekst op beeld, disabled buttons, badges en lichte grijze bodytekst.
    5. Formulieren: test leeg, fout ingevuld, geldig ingevuld en na submit. Een formulier zonder goede foutstaat is niet klaar.
    6. Loading states: laat niet alleen een spinner zien. Zeg wat er gebeurt en voorkom dubbele submits.
    7. Error states: schrijf menselijke foutmeldingen. Geen technische stack of lege rode box.
    8. Empty states: een leeg dashboard, lege lijst of geen resultaten-pagina moet nog steeds een volgende stap geven.
    9. Modals en drawers: test openen, sluiten, Escape, scrollen en focus. Janky motion voelt goedkoop.
    10. Consistente spacing: gebruik een vaste spacing- en radius-schaal. AI maakt anders elk blok lokaal “mooi”.
    11. Beeldtaal: geen plastic AI-stock, vage glow-achtergronden of nep-screenshots als de gebruiker iets moet beoordelen.
    12. SEO-copy: haal intro’s weg die alleen het onderwerp aankondigen. De pagina moet direct helpen.

    Wat je beter prompt dan “maak dit professioneel”

    Geef de agent regels die je kunt controleren. Bijvoorbeeld:

    Gebruik een rustige redactionele layout.
    Geen cards tenzij items echt naast elkaar vergeleken worden.
    Geen gradient-orbs of paarse glow-achtergronden.
    Buttontekst mag op mobiel niet afbreken.
    Maak states voor loading, empty, error en success.
    Test lange Nederlandse labels en 390px mobile viewport.
    Leg na afloop uit welke visuele risico's nog handmatig gecontroleerd moeten worden.

    Dit soort instructies werkt beter omdat je niet om smaak vraagt, maar om gedrag. De agent kan nog steeds fouten maken, maar jij hebt daarna een checklist om tegen te verifiëren.

    Wanneer je niet verder moet prompten

    Stop met prompten als de pagina bij elke verbetering elders uit elkaar valt. Dat is meestal geen “nog één prompt”-probleem, maar een systeemprobleem: geen vaste typografie, geen componentregels, geen ontwerpbeslissing over dichtheid, geen mobiele hiërarchie.

    Dan is de snelste route vaak handmatig: eerst één scherm goed maken, daaruit componentregels halen, daarna pas de agent verder laten bouwen. Anders train je jezelf om AI-output te poetsen in plaats van een interface te ontwerpen.

    Publicatiegate voor AI-sites

    Publiceer pas als je deze vier dingen kunt laten zien:

    • desktop- en mobiele screenshots van de belangrijkste flow;
    • minimaal één echte foutstaat en één lege staat;
    • een korte lijst met handmatige correcties die je na AI-output hebt gedaan;
    • een duidelijke canonical: welke pagina ownet deze taak, en welke pagina’s linken ernaartoe?

    De beste AI-site voelt niet alsof de agent zijn best heeft gedaan. Hij voelt alsof iemand met smaak en context de laatste beslissing heeft genomen.

    Bronnen en verdere context

    Wil je eerst beter leren prompten voordat je een AI-site laat bouwen? Begin dan met vibe coding, vergelijk Cursor, Lovable en Bolt, en test je output daarna met de checklist hierboven.

    Verder lezen

    Werk per use-case. Een beeldprompt, tekstprompt en codeprompt vragen elk om andere controlepunten; bundel ze niet in één generieke opdracht. Lees daarna ook bekijk de AI-prompt hub of gebruik de Prompt Coach.

  • Cursor vs Lovable vs Bolt: welke vibe coding tool past bij jou?

    De korte versie: Cursor vs Lovable vs Bolt is geen wedstrijd om de “beste” tool, maar een keuze die afhangt van wat je bouwt en hoeveel je zelf wilt sturen. Wil je code schrijven met AI naast je? Dan kom je bij Cursor uit. Wil je vanaf een prompt een werkende app in de browser zien verschijnen, zonder editor? Dan zitten Lovable en Bolt dichter bij wat je zoekt.

    In dit artikel zet ik de drie naast elkaar op de punten die er echt toe doen voor vibe coding: hoeveel controle je hebt, hoe steil de leercurve is, en voor wie elke tool logisch is. Geen feature-lijstjes die volgende maand verouderd zijn — wel een kader om zelf te kiezen.

    Wat is vibe coding eigenlijk?

    Vibe coding betekent dat je beschrijft wat je wilt, en de AI bouwt het. Je stuurt op gevoel, intentie en resultaat in plaats van regel voor regel code te tikken. Dat klinkt magisch, maar het valt of staat met hoe goed je je wens kunt formuleren. Een vage prompt levert een vage app op. Een scherpe prompt levert iets bruikbaars.

    Daarom is de tool maar de helft van het verhaal. De andere helft ben jij: hoe duidelijk je kunt zeggen wat je wilt, en hoe je bijstuurt als het resultaat afwijkt. Wil je daar beter in worden, lees dan eerst hoe je vibe coding leert — dat scheelt je veel frustratie ongeacht welke tool je kiest.

    Cursor: voor wie de code wil zien

    Cursor is een code-editor met AI ingebouwd. Je werkt in een echte ontwikkelomgeving, met bestanden, een terminal en versiebeheer, maar de AI helpt je schrijven, aanpassen en debuggen. Je kunt hele functies laten genereren of gericht een stuk code laten herschrijven.

    Cursor past bij je als:

    • je al wat programmeert of dat wilt leren, en de code niet als zwarte doos wilt behandelen
    • je een bestaand project hebt waar je in wilt blijven werken
    • je volledige controle wilt over de structuur en niet vastzit aan één manier van bouwen

    De keerzijde: je moet je iets meer thuis voelen in een editor. Voor iemand die nog nooit een regel code heeft gezien, is de drempel hoger dan bij een browser-tool. Maar precies omdat je de code ziet, leer je sneller begrijpen wat er gebeurt.

    Lovable en Bolt: van prompt naar werkende app

    Lovable en Bolt zitten in dezelfde hoek: je typt wat je wilt bouwen, en je krijgt een werkende app of website terug die je meteen in de browser ziet draaien. Je hoeft geen ontwikkelomgeving op te zetten en geen code te begrijpen om te starten. Je beschrijft, je kijkt, je stuurt bij met een volgende prompt.

    Dat maakt ze geschikt voor:

    • een idee snel uittesten of een prototype laten zien
    • een landingspagina of simpele app bouwen zonder developer in te huren
    • leren door te doen, zonder eerst een editor onder de knie te krijgen

    Het verschil tussen de twee zit vooral in nuance en werkstijl, en dat verschuift met elke update — dus laat je niet gek maken door losse feature-vergelijkingen. Probeer ze allebei kort met hetzelfde idee en kijk welke jou prettiger laat sturen. De ene voelt voor de een logischer dan voor de ander.

    De gemene deler: hoe meer je app groeit, hoe meer je tegen de grenzen aanloopt. Voor kleine, scherp afgebakende dingen zijn ze snel en fijn. Voor iets groots en complex wil je vaak alsnog ergens code kunnen aanraken — en dan kom je weer in de buurt van een tool als Cursor.

    Zo kies je: drie vragen

    Vergeet de hype en stel jezelf deze drie vragen:

    • Wil je de code zien of niet? Ja: Cursor. Nee, ik wil het resultaat: Lovable of Bolt.
    • Bouw je iets nieuws of werk je in iets bestaands? Nieuw prototype: een browser-tool is sneller. Bestaand project: Cursor.
    • Hoeveel wil je leren onderweg? Wil je echt begrijpen hoe het werkt, dan helpt code zien. Wil je vooral snel iets werkends, dan niet.

    En het belangrijkste: welke tool je ook pakt, je resultaat hangt af van je prompt. Dezelfde opdracht levert in alle drie iets totaal anders op afhankelijk van hoe scherp je het vraagt. Daar is mijn KOMPAS-aanpak voor — Kader, Opdracht, Materiaal, Paalwerk, Afwerking, Sturing — zodat je een vibe coding tool precies de goede kant op stuurt in plaats van te hopen dat het klopt. Een overzicht van meer opties vind je in mijn gids met vibe coding tools.

    Veelgestelde vragen

    Welke is het makkelijkst om mee te beginnen?

    Voor iemand zonder programmeerervaring zijn Lovable en Bolt het laagdrempeligst: je typt een prompt en ziet meteen een werkende app, zonder editor of installatie. Cursor vraagt iets meer technische gewenning, maar leert je wel sneller begrijpen wat er onder de motorkap gebeurt.

    Kan ik met deze tools een echt product bouwen, of alleen prototypes?

    Prototypes en kleine apps gaan prima. Hoe complexer en groter je project, hoe meer je tegen grenzen aanloopt en hoe handiger het is om ergens zelf de code te kunnen aanpassen. Veel mensen starten in een browser-tool en stappen later over naar Cursor zodra het serieus wordt.

    Moet ik kunnen programmeren om vibe coding te doen?

    Nee, om te starten niet. Maar je hebt wél de vaardigheid nodig om duidelijk te beschrijven wat je wilt en bij te sturen als het afwijkt. Dat is een aparte skill — en eerlijk gezegd belangrijker dan de tool zelf.

    Welke moet ik nou kiezen?

    Wil je de code zien en in bestaande projecten werken: Cursor. Wil je snel van idee naar werkende app zonder editor: Lovable of Bolt, en probeer ze allebei kort uit. Twijfel je nog, dan helpt een sessie waarin we het samen op jouw project toepassen.

    Wil je weten of jouw prompt scherp genoeg is voor welke tool dan ook? Plak hem in de gratis prompt-coach tool — die scoort en herschrijft hem voor je. Wil je liever samen aan de slag met vibe coding op jouw eigen project, kijk dan naar de coaching.

    Verder lezen

    De beste tool hangt minder af van hype en meer van controle: kun je wijzigingen terugvinden, testen en herstellen als de AI te enthousiast bouwt? Lees daarna ook vergelijk Cursor, Lovable en Bolt of check je AI-code voor publicatie.

  • Claude Code naar Codex migreren: wat neem je echt mee?

    Claude Code naar Codex migreren: wat neem je echt mee?

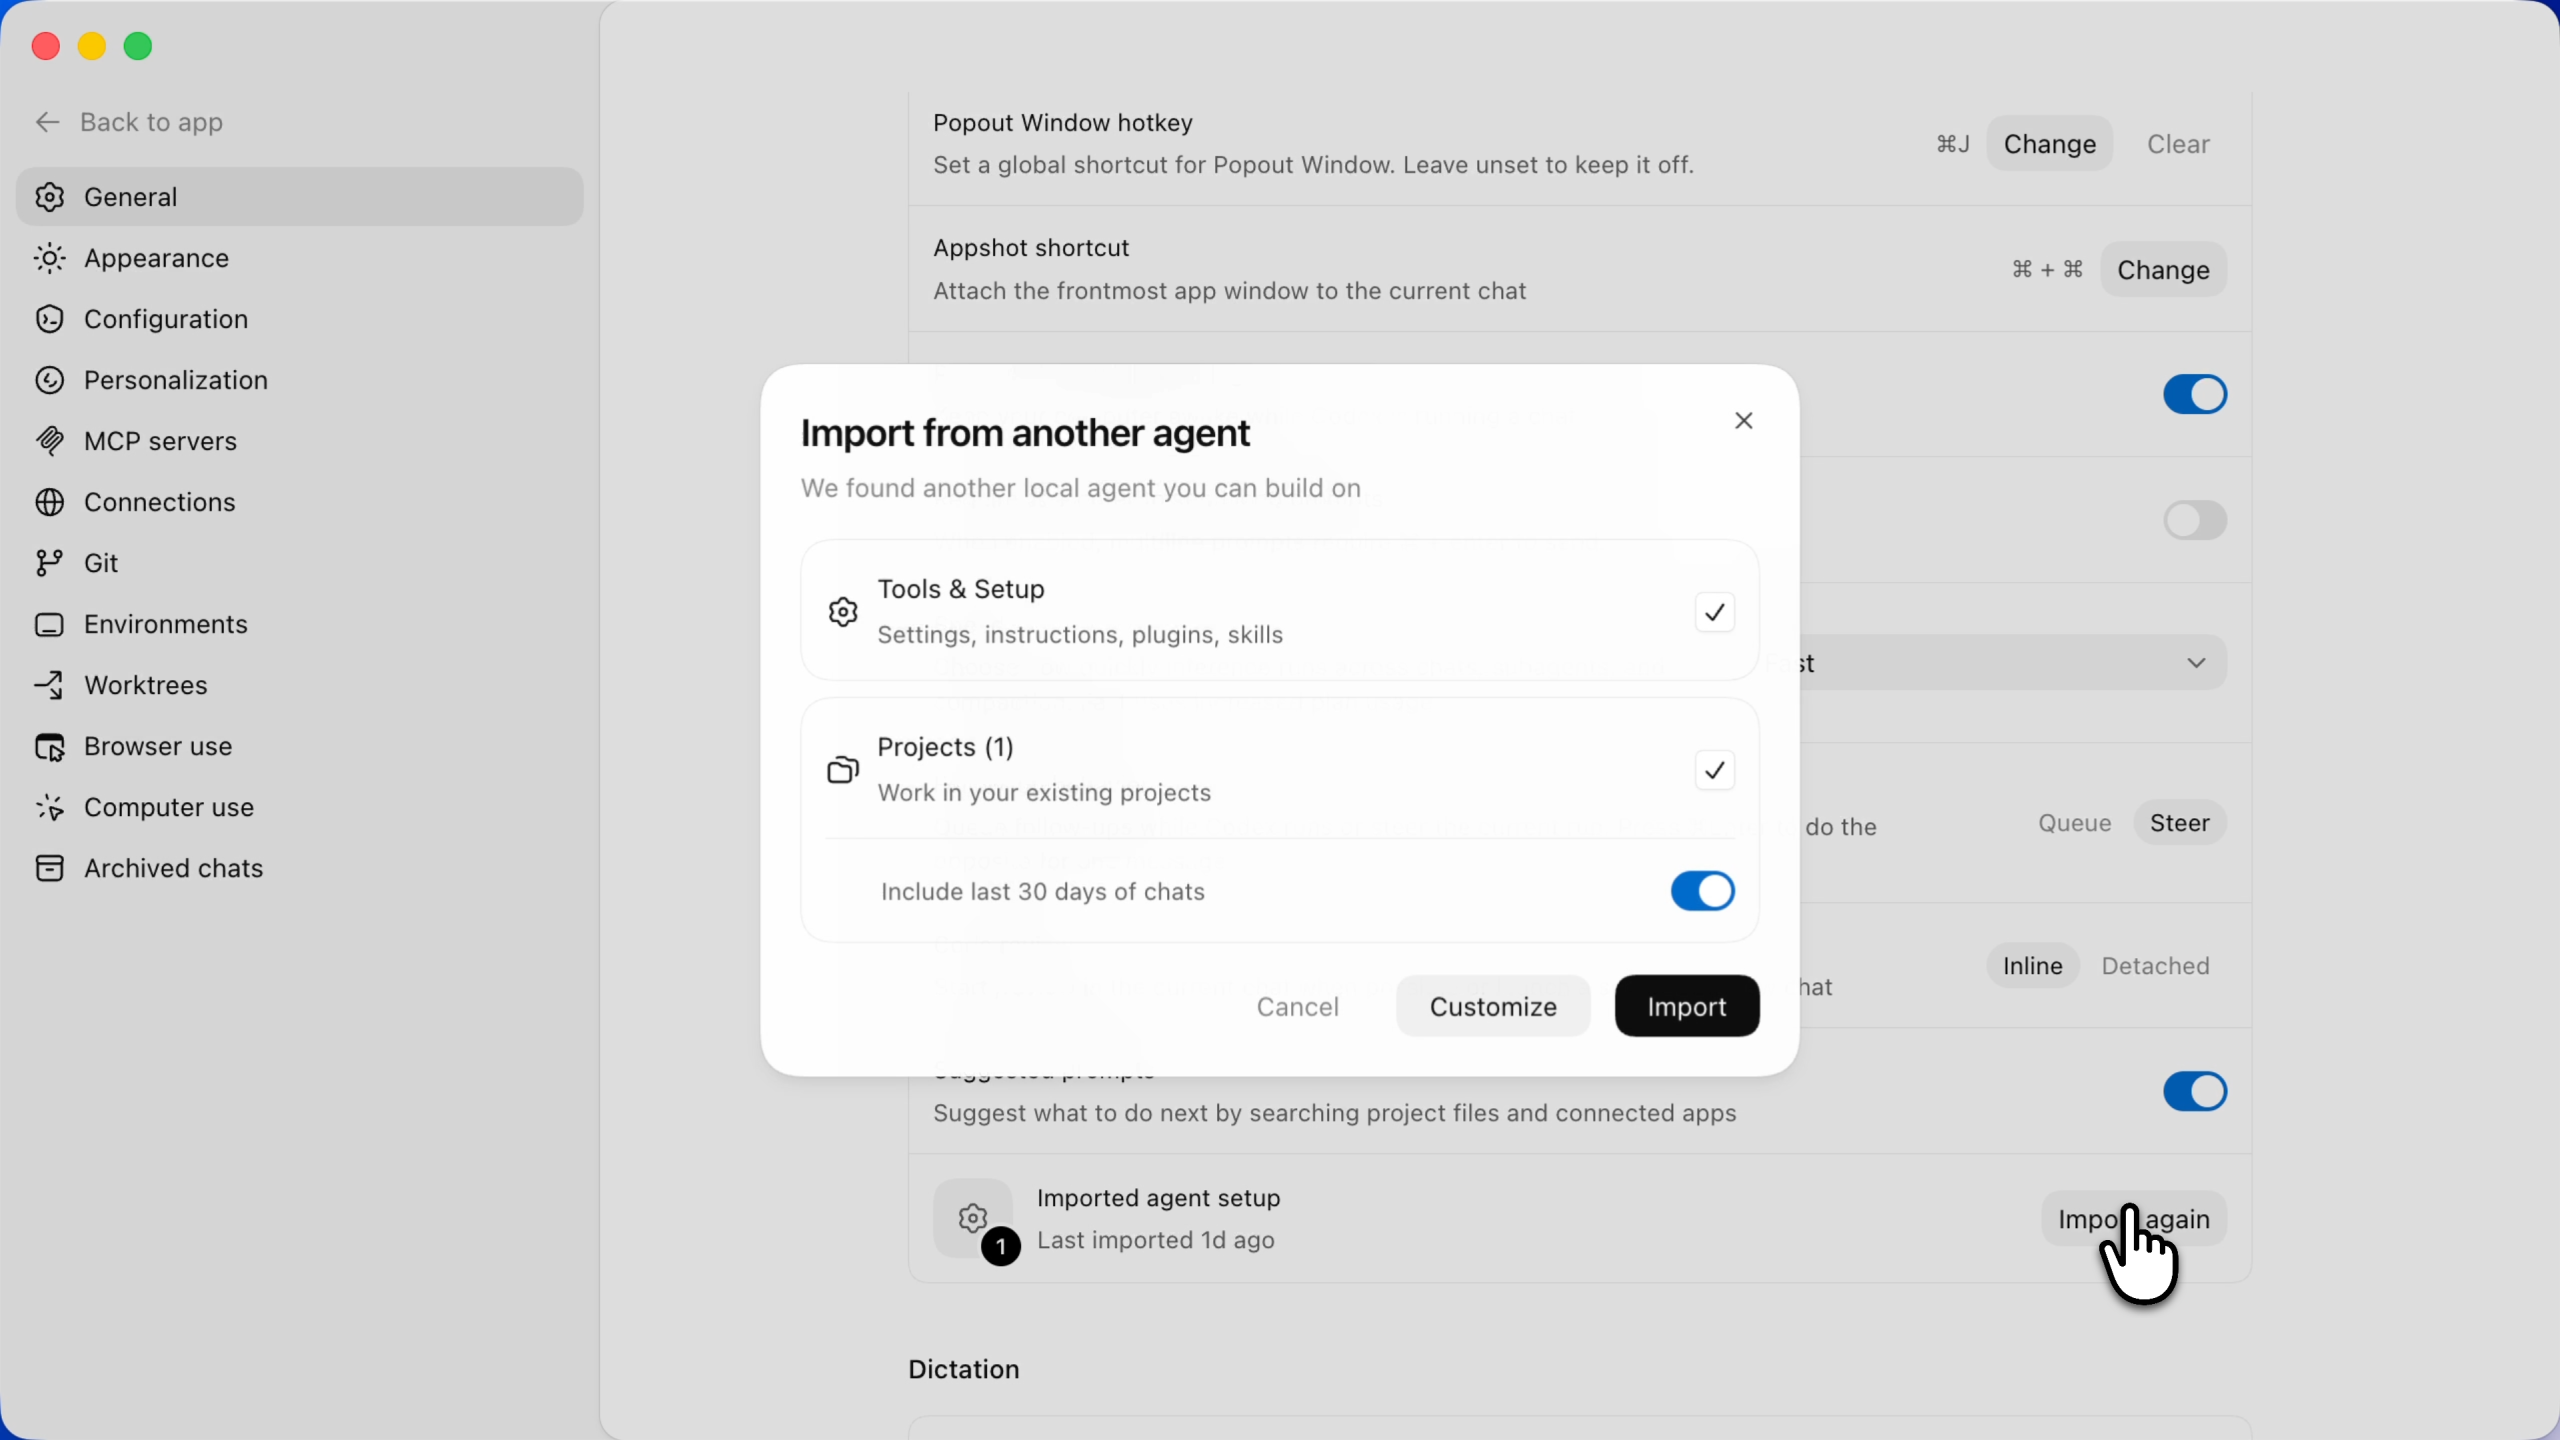
    Als je van Claude Code naar Codex overstapt, migreer je vooral je werkwijze. Niet alleen je prompt. Neem je instructiebestanden, skills, MCP servers, hooks, subagents en recente sessies mee. Controleer daarna per project of de agent nog dezelfde regels volgt, dezelfde tools mag gebruiken en dezelfde stopregels respecteert.

    De grootste fout is denken dat een importknop je teamgeheugen begrijpt. OpenAI’s Codex-migratieflow helpt met het overzetten van veel agent-context, maar jij moet beoordelen welke afspraken nog kloppen. Een oude Claude-regel kan in Codex te breed zijn. Een hook die in je vorige setup nuttig was, kan in een andere agent te veel rechten krijgen. En een sessie uit vorige week is handig als geheugensteun, maar geen bewijs dat de nieuwe agent je codebase kent.

    Wat OpenAI’s migratieflow doet

    OpenAI presenteert de migratiepagina als een manier om “from another coding agent” naar Codex te bewegen. De flow draait om drie stappen:

    1. Importeren van bestaande agent-context.
    2. Aanvullende setup nalopen.
    3. Verder werken in Codex met de meegenomen context.

    De screenshots op de OpenAI-pagina laten precies zien waar dit interessant wordt: Codex kijkt niet alleen naar losse prompts, maar naar de werkafspraken om je project heen. Denk aan instructies, configuratie, skills, MCP servers, hooks, subagents en recente sessies.

    Dat is goed nieuws voor mensen die al serieus met Claude Code werkten. Je hoeft niet vanaf nul te beginnen. Maar importeren is geen kwaliteitscontrole. Zie het als een verhuisdoos: alles zit erin, ook de dingen die je beter niet opnieuw in je werkkamer zet.

    Er staat ook een officiele OpenAI-skill rond migrate-to-codex in de OpenAI skills-repository. Die skill richt zich op ondersteunde instructiebestanden, skills, agents en MCP-configuratie. Dat bevestigt het belangrijkste punt: migreren gaat niet over een losse prompt, maar over de operationele laag om je agent heen.

    Wat je wel en niet blind moet meenemen

    Onderdeel Meenemen? Controle
    AGENTS.md, CLAUDE.md of projectinstructies Ja Haal tool-specifieke commands eruit of maak ze expliciet per agent.
    Skills en workflows Ja, maar selectief Check triggers. Een te brede skill activeert op de verkeerde taak.
    MCP servers Ja, met rechtencheck Controleer toegang tot Gmail, GitHub, database, browser, filesystem en secrets.
    Hooks Alleen als je ze begrijpt Een hook die automatisch test of formatteert is prima. Een hook die live deployt vraagt om harde stopregels.
    Subagents Selectief Zet alleen subagents over die een duidelijke taak, input en output hebben.
    Recente sessies Als referentie Gebruik ze niet als bron van waarheid voor requirements.
    Oude modelvoorkeuren Nee, opnieuw kiezen Modellen veranderen te snel. Kies opnieuw per taaktype.

    Mijn advies: importeer breed, activeer smal. Laat Codex eerst lezen, samenvatten en een migratieplan maken. Geef pas daarna toestemming voor edits, hooks of tools met schrijf- of deployrechten.

    Codex of Claude Code: kies niet religieus

    Veel mensen maken hier een fanboy-vraag van. Dat helpt niet. De praktische vraag is: welke agent maakt in jouw project de minste dure fouten?

    Claude Code blijft sterk als je al een volwassen Claude-setup hebt met goede CLAUDE.md-regels, terminalgewoontes en bestaande reviewflows. Codex is logisch als je dieper in OpenAI tooling zit, veel met OpenAI API’s werkt of je agentwerk vanuit een OpenAI-omgeving wilt standaardiseren.

    Voor serieuze projecten zou ik ze naast elkaar testen:

    Taak Beste test
    Bugfix met bestaande tests Laat beide agents dezelfde failing test oplossen en vergelijk diff, testoutput en uitleg.
    Grote refactor Meet wie het kleinste werkende plan maakt en het minst ongevraagd verandert.
    Nieuwe feature Kijk wie betere vragen stelt over randgevallen, data en UX.
    Content of promptworkflow Check wie minder vulling schrijft en beter vasthoudt aan je tone-of-voice.
    Tooling en MCP Controleer wie rechten, secrets en rollback beter behandelt.

    De winnaar is niet de agent met de mooiste uitleg. De winnaar is de agent die na verificatie de schoonste wijziging achterlaat.

    Laatste modellen: let op de taak, niet alleen op de naam

    Peildatum: 10 juni 2026. OpenAI noemt in de officiele modeldocs gpt-5.5 als flagship voor complex reasoning en coding. Daarnaast staan gpt-5.4, gpt-5.4-mini en gpt-5.4-nano in de actuele modelkeuze voor lagere kosten of lagere latency. Anthropic noemt op dezelfde peildatum claude-fable-5 als meest capabele breed beschikbare model, claude-mythos-5 als limited availability via Project Glasswing, en daarnaast claude-opus-4-8, claude-sonnet-4-6 en claude-haiku-4-5.

    Die namen zijn nuttig, maar ze lossen je migratie niet op. De vraag is per taak welk risico je neemt.

    De vuistregel:

    • Gebruik gpt-5.5, claude-fable-5 of claude-opus-4-8 voor architectuur, complexe refactors, securitygevoelige keuzes en migratieplannen.
    • Gebruik gpt-5.4-mini, gpt-5.4-nano, claude-sonnet-4-6 of claude-haiku-4-5 voor samenvatten, kleine tekstedits, simpele testfixes en bulkcontrole.
    • Gebruik geen goedkoop model voor taken met live systemen, klantdata, betalingen of productiedeploys.
    • Laat een agent nooit modelkeuze gebruiken als excuus om geen bewijs te leveren.

    Een goede migratieprompt noemt daarom niet alleen “gebruik het beste model”, maar ook: wat mag de agent lezen, wat mag hij aanpassen, welke tests gelden als bewijs en waar moet hij stoppen.

    Een migratieprompt die wel werkt

    Gebruik deze prompt nadat je de Codex-import hebt gedaan:

    Lees eerst de geimporteerde agent-instructies, skills, MCP-configuratie, hooks en recente sessies.
    
    Maak daarna een migratierapport met:
    1. Welke instructies nog bruikbaar zijn in Codex.
    2. Welke instructies tool-specifiek zijn voor Claude Code, Cursor of een andere agent.
    3. Welke MCP servers schrijf- of secret-risico hebben.
    4. Welke hooks automatisch iets kunnen aanpassen, deployen, mailen, betalen of publiceren.
    5. Welke skills te breed triggeren.
    6. Welke drie projectregels je zou aanpassen voordat je code wijzigt.
    
    Voer nog geen edits uit. Geen hooks draaien. Geen externe tools gebruiken met schrijfrechten. Eindig met een korte safe-to-start checklist.

    Die prompt is saai op de goede manier. Je laat de agent eerst de verhuizing inspecteren voordat hij de gereedschapskist openklapt.

    De KOMPAS-check voor agentmigratie

    Op Promptcoaching gebruiken we KOMPAS voor prompts en workflows. Voor Codex/Claude-migratie ziet die check er zo uit:

    • Kader: om welk project, welke repo, welke omgeving en welke rechten gaat het?
    • Opdracht: moet de agent analyseren, migreren, testen, documenteren of echt code wijzigen?
    • Maat: wat is klein genoeg voor deze sessie?
    • Paalwerk: welke bestanden, URL’s, tests en bronnen zijn leidend?
    • Afwerking: welk bewijs moet de agent opleveren?
    • Stopregels: wanneer moet de agent stoppen en jou vragen?

    Wie deze zes punten overslaat, krijgt vaak een agent die druk lijkt maar weinig controleerbaar werkt.

    Mijn nuchtere advies

    Zet Codex en Claude Code niet tegenover elkaar alsof je maar een gereedschap mag houden. Maak je agent-setup portabel. Schrijf projectregels in gewone markdown. Bewaar workflows als bestanden. Gebruik MCP bewust. Laat hooks nooit zonder stopregels draaien. En meet agentkwaliteit aan bewijs: tests, screenshots, logs, diff en rollback.

    De migratie naar Codex is dan geen sprong in het diepe. Het is een goede aanleiding om je AI-werkwijze op te ruimen.

    Update 12 juni 2026: wat OpenAI/Ona verandert aan Codex-werk

    OpenAI kondigde op 11 juni 2026 aan dat het Ona wil overnemen. De overname is nog niet definitief afgerond; OpenAI schrijft zelf dat de deal nog afhankelijk is van closing conditions en benodigde goedkeuringen.

    De relevante les voor deze migratiepagina is niet de overname zelf. Het gaat om de richting: Codex moet langer lopende taken kunnen doen in veilige, persistente werkomgevingen. Dat maakt een migratie van Claude Code naar Codex minder een promptverhuizing en meer een operationele keuze.

    Als een agent straks uren of dagen doorwerkt, moet je vóór de taak scherper zijn:

    • Scope: wat mag de agent aanpassen, en wat niet?
    • Context: welke bestanden, issues, rapporten en eerdere beslissingen zijn bron van waarheid?
    • Credentials: welke systemen mag de agent lezen, schrijven of juist niet aanraken?
    • Checkpoints: wanneer moet de agent stoppen voor review?
    • Rollback: hoe draai je een verkeerde wijziging terug zonder ander werk te raken?

    Mijn praktische regel blijft: importeer breed, activeer smal. Laat Codex eerst lezen, samenvatten en een plan maken. Geef pas daarna toestemming voor edits, hooks of tools met schrijf- en deployrechten.

    Bron: OpenAI – OpenAI to acquire Ona.

    Verder lezen

    Claude reageert sterk op duidelijke rol, context en beoordelingscriteria. Geef dus niet alleen de taak, maar ook hoe het antwoord beoordeeld wordt. De instellingen die per model verschillen — en die je bij zo’n overstap opnieuw moet afwegen — staan in de promptgidsen per model.

  • AI verandert werk — waarom prompten leren je beste investering is

    AI verandert werk — waarom prompten leren je beste investering is

    Bijna elke week krijg ik dezelfde vraag van iemand die ik coach: “Sam, gaat AI mijn werk overnemen?” Mijn eerlijke antwoord was lang: niemand weet het precies. Maar onlangs verscheen er een document dat me hielp die vraag scherper te beantwoorden — en het kwam uit onverwachte hoek. Anthropic, de maker van Claude, publiceerde geen nieuwe tool, maar een plan over werk en inkomen. Ik las het, en het bevestigde precies waarom ik doe wat ik doe.

    Wat Anthropic zegt

    Het plan heet het Economic Policy Framework. De kern: AI gaat zo snel dat beleid achterloopt. Die snelheid kan veel welvaart brengen, maar ook de vraag naar menselijk werk verlagen. Anthropic schetst drie scenario’s — van een milde schok tot grote werkloosheid — met per geval maatregelen, en legt er $350 miljoen bij voor onderzoek en beurzen. Eerlijk blijven: een AI-bedrijf dat om beleid vraagt heeft daar ook belang bij. Lees het als serieus voorstel, niet als orakel.

    De rode draad: wie met AI kan werken, staat sterker

    Wat me opviel, is wat in bijna élk scenario terugkomt. Anthropic raadt overheden aan om mensen te helpen omscholen, en raadt bedrijven aan om hun mensen om te scholen en te herplaatsen in plaats van in te krimpen. De onderliggende gedachte: niet de technologie bepaalt of jij relevant blijft, maar of je leert ermee te werken.

    Dat is precies de boodschap die ik in elke coaching herhaal. Het is niet “AI versus jij”. Het is “jij met AI versus iemand zonder”. En dat verschil is leerbaar.

    Waarom prompten meer is dan een trucje

    Veel mensen denken bij prompten aan handige zinnetjes die je ergens kopieert. Zo zie ik het niet. Goed prompten is leren denken samen met een model: helder krijgen wat je wilt, het in stukken knippen, bijsturen op het antwoord. Het is het verschil tussen AI die jóu gebruikt — vage vraag, vaag antwoord — en jij die AI gebruikt.

    Die vaardigheid verdwijnt niet als de modellen beter worden. Sterker: hoe krachtiger AI wordt, hoe waardevoller het is om er goed mee te kunnen sturen. Daarom werk ik met de KOMPAS-methode — een vast houvast om elke prompt beter te maken, ongeacht welk model je gebruikt.

    Wat ik mensen aanraad

    Wacht niet op zekerheid die er toch niet komt. Begin klein en concreet. Pak één taak uit je echte werk waar AI je tijd bespaart, en doe die deze week mét AI. Bouw van daaruit verder. Wil je gestructureerd oefenen? Test je eigen prompts gratis met mijn Prompt Coach, of plan een sessie via coaching als je sneller stappen wilt zetten met begeleiding.

    Eerlijk over de onzekerheid

    Ik ga je niets wijsmaken: niemand weet hoe snel of hoe hard dit gaat. Het plan van Anthropic is bewust voorbereidend, geen voorspelling, en zeker geen loopbaangarantie. Maar van alle reacties die ik zie, is afwachten de enige die gegarandeerd niet werkt. Leren werken met AI is iets wat je vandaag al in eigen hand hebt.

    Veelgestelde vragen

    Maakt AI mijn baan overbodig?

    Dat hangt minder af van de technologie dan van wat je ermee doet. AI neemt vooral routinetaken over, terwijl het waardevoller wordt om er goed mee te kunnen sturen. Wie leert werken met AI, vergroot juist zijn waarde.

    Is leren prompten dan de oplossing?

    Geen wondermiddel, wel een concrete stap die je nu zelf kunt zetten. Goed prompten is leren denken met een model — een vaardigheid die niet verdwijnt naarmate AI beter wordt, maar belangrijker.

    Eerlijk gezegd: dit is een voorstel van één bedrijf, gericht op de Amerikaanse situatie, en geen financieel of loopbaanadvies. Ik deel het omdat het scherp laat zien hoe de makers van AI zelf naar de toekomst van werk kijken — en omdat het bevestigt wat ik dagelijks zie: de mensen die leren werken met AI, staan het sterkst. Bron: Anthropic — Economic Policy Framework.

    Verder lezen

    Prompt engineering wordt pas nuttig als je de fout kunt aanwijzen: ontbrekende context, verkeerde rol, geen voorbeeld of geen controle op het antwoord. Lees daarna ook bekijk de AI-prompt hub of gebruik de Prompt Coach.

  • Van goed prompten naar automatiseren: zo bouw je AI-workflows

    Een goede prompt is geen eindpunt, maar een bouwsteen. Wie scherp en gestructureerd leert prompten, heeft de helft van het werk voor een automatisering al gedaan. Van je schrijfproces tot terugkerende klusjes: de stap van losse prompts naar een herhaalbare AI-workflow is kleiner dan je denkt.

    Waarom een scherpe prompt de basis is van elke automatisering

    Als je een AI-model elke keer iets anders vraagt, krijg je elke keer iets anders terug. Dat is prima om te brainstormen, maar funest zodra je een taak honderd keer wilt herhalen. Automatiseren betekent dat je een proces zo betrouwbaar maakt dat het zonder jou draait, en dat lukt alleen als je input voorspelbaar is.

    Daarom begint automatiseren bij prompt-discipline. Een prompt die expliciet de rol, het doel, het gewenste formaat en de randvoorwaarden benoemt, levert consistente output. Diezelfde discipline die je leert om beter te schrijven met een AI-assistent, vertaalt zich direct naar machineleesbare, herhaalbare instructies.

    Je schrijfproces automatiseren: zo pak je het aan

    Notitieboek met handgetekend stroomschema naast een laptop met tekstdocument

    De meeste mensen willen niet “iets met AI”, maar gewoon sneller door hun schrijfwerk: blogs, nieuwsbrieven, productteksten, rapportages. Precies dat werk is de beste kandidaat om te automatiseren, omdat het elke keer dezelfde stappen volgt.

    Een schrijfproces bestaat bijna altijd uit dezelfde vijf stappen: onderwerp kiezen, research doen, opzet maken, schrijven, redigeren. Je hoeft ze niet alle vijf tegelijk te automatiseren. Begin bij de stap die jou het meeste tijd kost:

    • Research: een vaste prompt die bronnen samenvat in een vast format — kernpunten, cijfers en citaten met bron.
    • Opzet: een prompt die van elk onderwerp dezelfde soort outline maakt, met koppen en per kop één kernvraag.
    • Redigeren: een prompt met jouw eigen stijlregels die elke tekst langsloopt: te lange zinnen, jargon, clichés eruit.

    Elke stap apart is een gewone prompt die je vandaag al kunt maken. De automatisering ontstaat zodra je ze aan elkaar knoopt: de outline uit stap twee gaat automatisch je schrijfprompt in, en dat resultaat gaat automatisch door je redactieprompt. Twijfel je of je prompts scherp genoeg zijn voor zo’n keten? Haal ze eerst door de Prompt Coach.

    Het verschil tussen prompten en workflow-bouwen

    In 2026 is een duidelijke verschuiving zichtbaar: van losse prompt engineering naar workflow engineering. De winst zit niet langer in dat ene perfecte antwoord, maar in het aan elkaar koppelen van stappen tot een proces dat zichzelf herhaalt. Bedrijven die handmatig werk vervangen door geautomatiseerde workflows verkorten hun productietijd aanzienlijk.

    Losse prompt

    Je typt een vraag, leest het antwoord, kopieert het en plakt het ergens anders. Werkt prima eenmalig, maar schaalt niet.

    Workflow

    De output van de ene stap voedt automatisch de volgende. Geen kopieer-en-plak, geen handmatige tussenstappen, wel een resultaat dat reproduceerbaar is.

    Van prompt naar proces in vier stappen

    Het mooie is dat je geen developer hoeft te zijn om de denkstap te maken. De KOMPAS-aanpak die je leert om helder te formuleren, is precies wat je nodig hebt om een proces uit te tekenen voordat je het automatiseert.

    1. Beschrijf de taak als een herhaalbaar recept. Welke input gaat erin, welke stappen volgen, welk resultaat komt eruit? Schrijf het uit alsof je het aan een collega uitlegt.
    2. Maak elke stap een aparte, scherpe prompt. In plaats van een mega-prompt die alles tegelijk doet, knip je het op. Elke stap heeft een duidelijke taak en een vast outputformaat.
    3. Koppel de stappen aan elkaar. Dit heet prompt chaining: de uitkomst van stap een wordt de input van stap twee. Een tool of API zet de stappen op een rij zonder dat jij ertussen hoeft te zitten.
    4. Test, meet en verfijn. Draai de workflow een paar keer met echte data en kijk waar het misgaat. Bijna altijd ligt het aan een vage prompt, niet aan het model.

    Een concreet voorbeeld: video automatiseren

    Stel dat je elke week tien korte video’s wilt maken, telkens met dezelfde opbouw maar andere tekst en beelden. Handmatig in een video-editor wordt dat snel sloom. Met heldere prompts kun je elke stap aansturen: een prompt schrijft het script, een prompt kiest de scènes, een prompt bepaalt de ondertiteling. Vervolgens laat je een API het echte montagewerk doen.

    Hier komt SamAutomation in beeld. SamAutomation is een Nederlands initiatief rond AI-automatisering dat praktische workflows uitlegt en onderzoekt hoe je tools aan elkaar koppelt. Een goed voorbeeld is het stuk over workflows automatiseren met de CapCut API: het legt eerlijk uit dat CapCut zelf geen kant-en-klare publieke render-API biedt, en bespreekt welke open-source projecten en alternatieven dat gat opvullen om video’s programmatisch in elkaar te zetten.

    Belangrijk: de officiële mogelijkheden van zo’n platform veranderen regelmatig. Controleer altijd de actuele documentatie voordat je een workflow in productie neemt.

    De vaardigheden die meeschalen

    Wat dit voorbeeld laat zien, is dat de echte vaardigheid niet de tool is, maar het denken. Wie leert om een doel op te knippen in heldere stappen en elke stap precies te formuleren, kan dat patroon toepassen op tekst, beeld, video, e-mail of data-analyse. De tool wisselt, de aanpak blijft.

    • Formuleer doelen meetbaar, zodat je achteraf kunt zien of het werkte.
    • Houd output strak gestructureerd, want een machine leest geen losse zinnen maar vaste velden.
    • Bouw klein en breid pas uit als de basis betrouwbaar draait.

    Veelgestelde vragen

    Moet ik kunnen programmeren om AI-workflows te bouwen?

    Voor de denkstap niet. Het opknippen van een taak in heldere prompts kun je volledig in gewone taal doen. Voor de koppeling tussen stappen helpt een no-code automatiseringstool of een API, en daar is steeds minder technische kennis voor nodig.

    Wat is prompt chaining precies?

    Bij prompt chaining gebruik je de uitkomst van de ene prompt automatisch als invoer voor de volgende. Zo bouw je een keten van kleine, betrouwbare stappen in plaats van een grote, onvoorspelbare prompt.

    Waar begin ik het beste?

    Kies een taak die je vaak en op dezelfde manier doet. Schrijf het proces eerst uit, maak van elke stap een aparte prompt en test handmatig. Pas als dat werkt, automatiseer je de koppeling.

    Conclusie

    Goed leren prompten is niet alleen handig om betere antwoorden te krijgen, het is de directe opstap naar automatiseren. Zodra je gewend bent om doelen scherp te formuleren en in stappen te denken, verandert elke herhaalde taak in een kandidaat voor een workflow. Begin klein, blijf je prompts aanscherpen, en je merkt dat de stap van prompten naar automatiseren kleiner is dan hij lijkt.

    Verder lezen

    Prompt engineering wordt pas nuttig als je de fout kunt aanwijzen: ontbrekende context, verkeerde rol, geen voorbeeld of geen controle op het antwoord. Lees daarna ook bekijk de AI-prompt hub of gebruik de Prompt Coach.

  • Fable 5 verandert hoe je prompt: van instrueren naar delegeren

    Fable 5 verandert hoe je prompt: van instrueren naar delegeren

    Met Fable 5 verschuift prompten van stap-voor-stap instrueren naar een hele taak delegeren. Het nieuwe model doet langere, ingewikkelde klussen zelfstandig, met minder tussentijdse controle. Dat vraagt een andere prompt: minder micromanagen, meer heldere doelen, context en succescriteria. De klassieke promptprincipes blijven gewoon gelden — je past ze alleen toe op een groter niveau.

    De grootste fout die je nu kunt maken, is een capabeler model behandelen als het oude. Wie Fable 5 elke stap blijft voorkauwen, verspilt precies datgene waar het goed in is: zelfstandig doorwerken aan een doel. De vaardigheid die telt, verschuift van “een vraag goed formuleren” naar “een taak goed inkaderen”.

    De aanleiding: een “derde tijdperk”

    Bij de lancering schreef Felix Rieseberg — die bij Anthropic aan Claude Cowork werkt — in een bericht op X dat hij het bewust niet over de benchmarks wilde hebben. Volgens hem begint met Fable 5 een “derde tijdperk” van werken met AI. De rode draad: we gaan van chatten en bijsturen naar het uit handen geven van complete taken. Dat klinkt abstract, maar het verandert heel concreet hoe je een goede prompt opbouwt.

    Wat er verandert aan je prompt

    Eerdere modellen werkten het best als je ze in kleine stappen aanstuurde: doe dit, en dan dit, en controleer even. Fable 5 is gemaakt om langer zelfstandig door te werken — in Anthropics eigen woorden met “minder check-ins”. Dus in plaats van een reeks losse opdrachten geef je het één heldere opdracht met alles wat het nodig heeft om hem af te maken.

    Denk aan het verschil tussen een stagiair aansturen en een ervaren collega een klus geven. Bij de eerste dicteer je elke stap. Bij de tweede zeg je wat het eindresultaat moet zijn, geef je de context en de kaders, en laat je het werk aan hem over. Fable 5 verdient die tweede aanpak.

    De principes die gewoon blijven gelden

    Belangrijk: dit is geen breuk met alles wat je weet. De vaste promptprincipes uit Anthropics eigen prompting-richtlijnen werken juist beter naarmate een model capabeler wordt. De belangrijkste:

    • Wees expliciet en direct. Zeg precies wat je wilt, inclusief het waarom — een model dat de bedoeling snapt, kiest betere oplossingen.
    • Geef een rol. “Je bent een ervaren redacteur die…” stuurt de toon en het oordeel.
    • Laat voorbeelden zien. Eén goed voorbeeld van het gewenste resultaat stuurt strakker dan drie alinea’s uitleg.
    • Structureer met labels. Scheid je opdracht van het bronmateriaal, bijvoorbeeld met XML-achtige tags, zodat het model niet door elkaar haalt wat het moet doen en waarmee.
    • Laat het nadenken bij ingewikkelde taken — vraag het eerst te redeneren voordat het een conclusie geeft.

    Je gooit deze technieken dus niet weg. Je past ze toe op een grotere brok werk.

    Een goede delegeer-prompt in de praktijk

    Een bruikbaar skelet voor een taak die je uit handen geeft:

    • Rol: wie moet het model zijn? (“Je bent een onderzoeksredacteur.”)
    • Doel: wat is het eindresultaat? (“Lever een artikel van 800 woorden over X.”)
    • Context en materiaal: alles wat het nodig heeft — bronnen, achtergrond, voorbeelden.
    • Randvoorwaarden: wat mag wel en niet, lengte, toon, verboden aannames.
    • Klaar-criterium: wanneer is het goed? (“Elke claim onderbouwd, geen jargon, met een conclusie.”)

    Geef je dat in één keer mee, dan kan Fable 5 het grootste deel zelfstandig afmaken — en hoef jij alleen het resultaat te beoordelen in plaats van elke tussenstap.

    De valkuilen

    Drie dingen gaan het vaakst mis. Te weinig context: laat je gaten, dan vult het model die met aannames. Geen klaar-criterium: dan stopt het te vroeg of doet het juist te veel. En micromanagen: blijf je elke stap dicteren, dan verlaag je een sterk model tot het niveau van je instructies. Houd er ook rekening mee dat Fable 5 bij gevoelige onderwerpen (zoals beveiliging) kan terugschakelen of weigeren — dat is een ingebouwde rem, geen prompt-fout.

    Voorbeeld: micromanagen versus delegeren

    Het verschil zie je het best naast elkaar. Stel, je wilt een samenvatting van drie klantgesprekken.

    Micromanagen (de oude reflex): “Lees gesprek 1. Vat het samen in drie punten. Wacht. Nu gesprek 2. Vat samen. Nu gesprek 3…” Je stuurt elke stap, en het model kan niet vooruitdenken.

    Delegeren (de Fable 5-manier): “Je bent mijn klantonderzoeker. Hieronder staan drie klantgesprekken. Lever één overzicht met de gedeelde pijnpunten, de opvallende verschillen, en drie concrete verbeterpunten voor ons product. Onderbouw elk punt met een citaat uit de gesprekken. Klaar is: niets verzonnen, alleen wat er echt staat.”

    De tweede prompt is langer, maar je schrijft hem één keer en krijgt in één beurt een bruikbaar resultaat — in plaats van tien keer bijsturen. Dat is de hele winst: je investeert vooraf in een heldere opdracht en wint achteraf tijd op de uitvoering. Hoe capabeler het model, hoe meer die investering oplevert.

    Wat dit voor jou betekent

    Fable 5 is tot 22 juni gratis te proberen op de betaalde abonnementen. Gebruik die weken om een paar delegeer-prompts te bouwen voor je echte werk en draai ze naast je oude aanpak — je voelt meteen waar het verschil zit. In onze promptgidsen staat hoe je zulke prompts opbouwt, en bij de use-cases zie je hoe delegeren er in de praktijk uitziet. Wil je sparren over jouw specifieke taken, dan kan dat via de prompt-coach of dieper in een coachingstraject.

    Mijn oordeel

    De kern van goed prompten verschuift met Fable 5 van formuleren naar inkaderen. Niet de mooiste zin wint, maar de helderste opdracht: een rol, een doel, de juiste context en een duidelijk klaar-criterium. Wie dat onder de knie heeft, geeft straks hele taken uit handen waar hij vroeger een uur zat te chatten. De principes zijn niet nieuw — je gebruikt ze alleen op een hoger niveau, en dat is precies waar de winst zit.

    Update 13 juni 2026: Fable 5 en Mythos 5 zijn tijdelijk offline gehaald

    Anthropic heeft Fable 5 en Mythos 5 uitgeschakeld voor klanten nadat het bedrijf naar eigen zeggen een Amerikaanse export-control directive kreeg. Volgens Anthropic richtte die opdracht zich op toegang door foreign nationals, ook als die persoon in de Verenigde Staten zit. Omdat dat in de praktijk moeilijk zuiver te handhaven is, heeft Anthropic de modellen voor iedereen dichtgezet. Andere Claude-modellen zouden volgens Anthropic niet geraakt zijn.

    Dat verandert het advies in dit artikel. Fable 5 was interessant omdat het lange, rommelige taken beter kon dragen dan eerdere Claude-modellen. Maar een promptstrategie die alleen werkt met één tijdelijk beschikbaar frontiermodel is te kwetsbaar. Voor serieus werk moet je prompt dus niet alleen slim zijn, maar ook overdraagbaar.

    Wat je nu praktisch doet

    • Bewaar je taakdefinitie los van het model. Zet doel, context, grenzen en acceptatiecriteria in je prompt, niet in vage verwijzingen naar “doe dit zoals Fable”.
    • Maak een fallback-versie. Test dezelfde taak in Claude Opus, ChatGPT of Codex en noteer wat je moet aanscherpen als het model minder autonoom is.
    • Splits lange opdrachten in checkpoints. Als een model wisselt, wil je niet opnieuw beginnen. Laat het werk opleveren in tussenstappen die je kunt overnemen.
    • Controleer claims over jailbreaks voorzichtig. Anthropic spreekt over een smalle, niet-universele mogelijke bypass. Dat is iets anders dan “Fable is gekraakt”.
    • Maak je workflow model-onafhankelijk. Een goede prompt is een werkinstructie die ook bruikbaar blijft als de beste modelnaam morgen verandert.

    Mijn oordeel: dit is geen reden om Fable 5 af te schrijven. Het is wel een harde herinnering dat AI-werk niet mag hangen aan één modelknop. Wie prompts schrijft voor echte processen, schrijft ze alsof het model vervangen kan worden.

    Bronnen: Anthropic statement over Fable/Mythos access en de oorspronkelijke Fable 5 / Mythos 5 launchpost.

    Verder lezen

    Claude reageert sterk op duidelijke rol, context en beoordelingscriteria. Geef dus niet alleen de taak, maar ook hoe het antwoord beoordeeld wordt. Wat Fable 5 anders doet dan de rest staat naast de andere modellen in de promptgidsen per model — inclusief waarom je die modellen door een aparte verifier laat nakijken.

  • Nieuw AI-model gezien? Herschrijf je prompts nog niet

    Nieuw AI-model gezien? Herschrijf je prompts nog niet

    Er gaat een screenshot rond van “Kindle”, een naamloos model in Design Arena, met het gerucht dat het OpenAI’s onaangekondigde GPT-5.6 is. Bevestigd is niets. En toch is de reflex bij veel promptgebruikers meteen dezelfde: alles omgooien voor het nieuwe model. Doe dat niet. Een nieuw model is je prompts pas waard als het écht bestaat én je het op je eigen testset hebt gemeten.

    Ik snap de kriebel. Je hebt je prompts maandenlang bijgeschaafd, en dan zou er een beter model zijn waarop alles anders werkt. Maar prompts achter elke modelnaam aanjagen is geen vooruitgang — het is onrust. De rust zit in een vaste manier van testen. Die bouw je één keer, en daarna maakt geen enkel gerucht je meer nerveus.

    Wat er rondgaat

    De aanleiding is één post op X: een schermafbeelding waarop “Kindle” als anoniem model in Design Arena verschijnt, gekoppeld aan een beweerde GPT-5.6 met de codenaam kindle-alpha. Dat er een naam in de arena staat, is aannemelijk. Dat het OpenAI’s volgende model is, is een aanname.

    Design Arena laat modellen blind tegen elkaar stemmen op designopdrachten. Anonieme modellen horen daar gewoon bij. Het is dus geen lek, maar het normale ritme van het platform — en geen reden om aan je werkende prompts te zitten.

    Waarom een nieuw model je prompts niet automatisch beter maakt

    Hier zit de denkfout. Een prompt is geen universele sleutel; hij is afgesteld op het model waarvoor je hem schreef. Een instructie die jouw huidige model precies de juiste kant op duwt, kan op een ander model net anders vallen — soms beter, soms slechter. Een nieuw model betekent dus niet “mijn prompts zijn nu verouderd”. Het betekent: ik weet nog niet hoe mijn prompts zich hier gedragen. Dat is een vraag, geen alarm.

    Toen gpt2-chatbot in 2024 anoniem opdook, herschreven mensen meteen hun workflows voor een model dat niemand officieel kon gebruiken. Veel van dat werk was voor niets, want de aannames klopten half. Wie rustig bleef en wachtte tot er iets te testen viel, verloor niets en won tijd.

    En let op de cijfers waarop je je baseert. Onderzoekers van onder meer Cohere, Stanford en MIT lieten in “The Leaderboard Illusion” zien dat labs meerdere modelversies anoniem testen en alleen hun beste laten staan. Een model dat bovenaan een arena prijkt, is daarom niet automatisch beter voor jouw soort werk — of dat nu teksten, code of analyses zijn.

    Bouw een testset van tien prompts

    De oplossing is geen scepsis, maar een klein, herbruikbaar testbankje. Tien prompts die jouw echte werk dekken, met voor jezelf een idee van hoe een goed antwoord eruitziet. Denk aan een mix als deze:

    • Je twee of drie meestgebruikte werkprompts, precies zoals ze nu draaien.
    • Een prompt die structuur eist — een vaste opmaak, een tabel, geldige JSON.
    • Een lastige instructie met meerdere stappen, waar modellen vaak afhaken.
    • Een randgeval waarvan je weet dat je huidige model er soms de mist in gaat.
    • Een taak waarbij toon en stijl tellen, niet alleen het goede antwoord.

    Draai die set straks tegen het nieuwe model én je huidige, naast elkaar. Nu zie je in een half uur wat een ranglijst je nooit vertelt: word jouw werk er beter van, blijft het gelijk, of moet je bijsturen? Houd de set bovendien vast. Bij elke volgende release pak je hetzelfde bankje erbij en vergelijk je appels met appels.

    Schrijf prompts die een modelwissel overleven

    De beste verzekering tegen modelnieuws is een prompt die niet leunt op de eigenaardigheden van één model. Hoe explicieter je bent, hoe minder een nieuw model je kan verrassen. Een paar principes die over modellen heen standhouden:

    • Wees expliciet over het formaat. Vraag letterlijk om de structuur die je wilt — een tabel, een lijst, geldige JSON — in plaats van te hopen dat het model je bedoeling raadt.
    • Geef een voorbeeld. Één goed voorbeeld van de gewenste uitvoer stuurt elk model strakker dan drie alinea’s uitleg.
    • Scheid instructie van data. Zet je opdracht en de tekst waarop hij werkt duidelijk uit elkaar, zodat het model niet in de war raakt over wat het moet doen.
    • Stuur op gedrag, niet op het model. Beschrijf wat een goed antwoord kenmerkt — kort, onderbouwd, met bronnen — zodat de prompt werkt ongeacht wie hem uitvoert.
    • Leun niet op trucjes. Prompts die alleen werken door een vreemde formulering of een toevallige reactie van je huidige model, breken als eerste bij een wissel.

    Een prompt die zo is opgebouwd, draait op het ene model net zo goed als op het andere. Komt er straks echt een sterker model, dan hoef je niets te herschrijven — je controleert alleen of het nóg beter werkt. Dat is het verschil tussen een promptbibliotheek die je elke release opnieuw moet repareren en een die gewoon meegroeit. Precies die robuuste opbouw werken we stap voor stap uit in onze gidsen.

    Wat we (nog) niet zeker weten

    • Of “Kindle” van OpenAI is — niet bevestigd.
    • Of het hetzelfde is als kindle-alpha — aanname.
    • Of er een publiek geteste GPT-5.6 bestaat — geen documentatie, geen API, geen prijs.
    • Of jouw prompts er beter of slechter op draaien — dat weet je pas na je eigen test.

    Wat dit voor jou betekent

    Laat je werkende prompts met rust. Verander niets op basis van dit screenshot — je wint er niets mee en je verliest je houvast. Gebruik de tijd liever om je testset van tien prompts klaar te zetten, als die er nog niet is. Dat is de investering die zich bij elke nieuwe modelrelease terugbetaalt.

    Wil je dat gestructureerd aanpakken? In onze promptgidsen staat hoe je prompts opbouwt die niet bij de eerste de beste modelwissel omvallen, en bij de Codex use-cases zie je hoe zo’n testaanpak er in de praktijk uitziet. Snel willen sparren over jouw specifieke prompts kan via de prompt-coach, en wie er dieper in wil duiken, kijkt bij coaching.

    Mijn oordeel

    Goed prompten gaat niet over altijd op het nieuwste model zitten. Het gaat over een rustige, herhaalbare manier om te toetsen of iets je werk echt verbetert. “Kindle” is nu een naam op een screenshot — en zelfs als het GPT-5.6 blijkt, verandert dat de volgorde niet: eerst meten, dan pas je prompts aanpassen. Wie zijn testset op orde heeft, hoeft nooit meer in paniek iets om te gooien. Dat is het verschil tussen achter modellen aanrennen en ermee werken.

    Verder lezen

    Prompt engineering wordt pas nuttig als je de fout kunt aanwijzen: ontbrekende context, verkeerde rol, geen voorbeeld of geen controle op het antwoord. Lees daarna ook bekijk de AI-prompt hub of gebruik de Prompt Coach.

  • Vibe coding testen: kijk verder dan de eerste werkende output

    Vibe coding testen begint niet bij de vraag of de app start. Dat is de ondergrens. De betere vraag is: kan iemand deze AI-code reviewen, aanpassen en veilig mergen zonder de hele boel opnieuw te moeten bouwen?

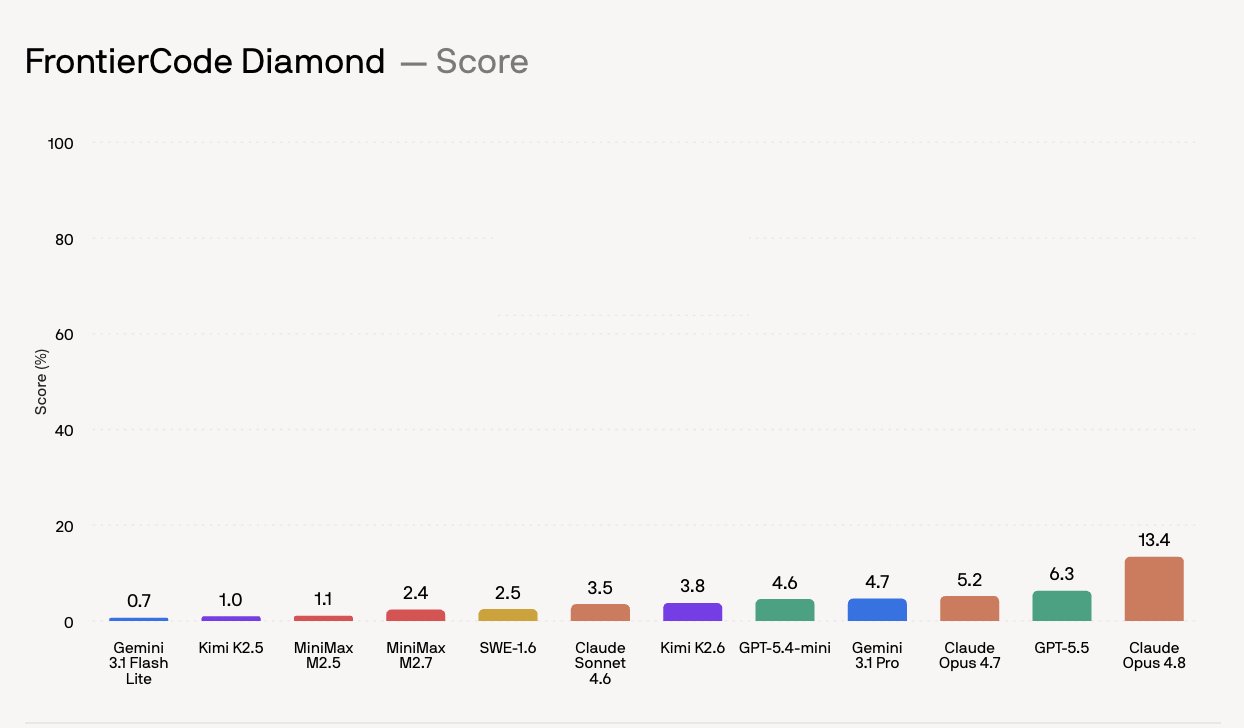
    Cognition raakt met FrontierCode precies dit punt. De benchmark meet volgens Cognition niet alleen of code werkt, maar of een maintainer de pull request zou accepteren. Voor iedereen die met Cursor, Codex, Claude Code, Lovable of Bolt bouwt, is dat een nuttiger criterium dan “de demo doet het”.

    FrontierCode Diamond scoregrafiek van Cognition
    Bronfiguur van Cognition op X. Lokale bronplaceholder: reports/cognition-frontiercode-article-2026-06-09/assets/cognition-frontiercode-tweet-01.jpg. Originele post: Cognition op X.

    Bronnen en leeswijzer

    De aanleiding

    Cognition introduceerde FrontierCode als nieuwe coding eval voor moeilijkheid en kwaliteit. De taken zijn volgens Cognition gebouwd met open-source maintainers en kostten meer dan 40 uur werk per taak. De benchmark vraagt niet alleen of een oplossing de tests haalt. Hij vraagt of de code mergewaardig is.

    Dat woord is belangrijk voor vibe coding. Veel beginners gebruiken AI alsof de eerste werkende output het eindpunt is. Ze beschrijven een app, de tool bouwt iets, de preview opent en de conclusie is: het werkt. Maar “werkt in preview” betekent weinig. De echte problemen komen later: state die niet klopt, auth die lekt, routes die niet indexeerbaar zijn, componenten die niet te onderhouden zijn, tests die ontbreken, of code die een volgende prompt niet meer stabiel kan aanpassen.

    Promptcoaching.nl is gebouwd rond prompting, vibe coding en de Prompt Coach. De keyword-map zet `vibe coding` als centrale hub neer, met tools, leren, voorbeelden en promptkwaliteit als subclusters. Dit artikel hoort daarom niet als algemeen AI-nieuws, maar als praktische beoordelingsgids: hoe test je AI-code voordat je ermee verder bouwt?

    Waarom “maak dit werkend” een matige prompt is

    Een AI-tool optimaliseert vaak op het criterium dat jij zichtbaar maakt. Vraag je om een werkende knop, dan krijg je een werkende knop. Vraag je om een route die getest, toegankelijk, onderhoudbaar en rollbackbaar is, dan krijgt het model een andere opdracht.

    De meeste vibe coding fouten beginnen niet bij het model. Ze beginnen bij een te vage succesdefinitie. “Maak een dashboard” is geen reviewbare opdracht. “Maak een dashboard met drie states, expliciete loading/error states, geen mockdata in productie, herbruikbare componenten en tests voor filters” is een betere opdracht. Nog beter: “wijzig alleen deze componenten, leg aannames vast, voeg testcases toe en geef een diff-samenvatting.”

    FrontierCode maakt die tweede manier van denken zichtbaar. Cognition zegt dat de benchmark criteria gebruikt voor correctness, test quality, scope discipline, style en adherence to codebase standards. Dat zijn precies de criteria die je in een goede prompt moet zetten als je met AI code laat schrijven.

    Wat de FrontierCode scores zeggen over vibe coding

    De hardste FrontierCode-subset heet Diamond. Daar scoort Claude Opus 4.8 via Claude Code volgens de Cognition-data 13,4%. GPT-5.5 via Codex haalt 6,3%. Claude Opus 4.7 via Claude Code haalt 5,2%. Zelfs de beste systemen zitten dus laag wanneer de vraag verschuift van “maak iets werkends” naar “maak iets dat een maintainer zou mergen”.

    Je moet die cijfers niet lezen als reden om AI-code te negeren. Lees ze als reden om je proces serieuzer te maken. AI kan enorm versnellen. Maar de versnelling heeft alleen waarde als je reviewlaag meegroeiet. Anders ruil je bouwtijd in voor onderhoudsschuld.

    OpenAI liet bij SWE-bench Verified al zien hoe lastig benchmarkkwaliteit is. Bij het maken van SWE-bench Verified werd 68,3% van de beoordeelde samples weggefilterd omdat issuebeschrijvingen, tests of andere criteria problematisch waren. METR liet later zien dat test-passing SWE-bench PR’s door maintainers veel minder vaak mergewaardig werden gevonden dan de automatische scores suggereren. FrontierCode is Cognition’s poging om die reviewrealiteit directer te meten.

    Een betere prompt voor AI-code

    Als je met vibe coding werkt, moet je prompt niet alleen de feature beschrijven. Je prompt moet de reviewcriteria beschrijven. Gebruik bijvoorbeeld dit patroon:

    Doel:
    Bouw [feature] voor [gebruikerstaak].
    
    Scope:
    Wijzig alleen [bestanden/componenten].
    Maak geen brede refactor.
    
    Kwaliteit:
    - Voeg loading, empty en error states toe.
    - Houd bestaande stijlen en componentpatronen aan.
    - Voeg tests toe voor [cases].
    - Leg aan het einde uit welke aannames je maakte.
    
    Acceptatie:
    De wijziging is pas klaar als de app buildt, tests slagen en de diff klein genoeg is om te reviewen.
    

    Dit is geen magische prompt. Het is een manier om de agent niet alleen te laten produceren, maar ook te laten werken binnen een reviewbaar contract. De Prompt Coach kan hierbij helpen omdat je prompts kunt beoordelen op rol, taak, context, constraints en outputformat. Voor code moet je daar acceptatiecriteria en testgedrag aan toevoegen.

    Maak je eigen mini-FrontierCode voor projecten

    Je hebt geen groot benchmarkteam nodig om beter te testen. Maak per project een kleine evalset met taken die jij echt belangrijk vindt. Voor een Lovable-app kunnen dat SEO-rendering, formulierfouten, mobile layout en routing zijn. Voor een interne tool kunnen dat permissies, export, filters en auditlogs zijn. Voor een WordPress plugin kunnen dat hooks, backwards compatibility en settings validation zijn.

    Laat de AI-tool dezelfde taak meerdere keren oplossen. Beoordeel niet alleen of de output werkt. Beoordeel:

    • Was de diff klein genoeg?
    • Bleef de agent binnen de afgesproken scope?
    • Zijn er tests of controlecases toegevoegd?
    • Is de code begrijpelijk voor iemand anders?
    • Kan de wijziging later veilig worden aangepast?

    Dit is precies waar veel vibe coding beginners te weinig aandacht aan geven. Ze vergelijken tools op snelheid en uiterlijk. De betere vergelijking gaat over herstelbaarheid. Welke tool maakt fouten die je kunt vinden? Welke tool houdt instructies vast? Welke tool raakt minder vaak bestanden aan die buiten scope liggen? Welke tool legt zijn aannames helder uit?

    Wat we nog niet zeker weten

    FrontierCode is niet volledig reproduceerbaar voor buitenstaanders, omdat Cognition de taken prive houdt om contaminatie te voorkomen. Dat is verdedigbaar, maar het betekent dat je de benchmark niet zelfstandig kunt narekenen. De ranking combineert ook model en agentharness. Claude Code, Codex en Gemini CLI zijn verschillende werkomgevingen. Een score zegt dus niet alleen iets over het model, maar ook over de tooling eromheen.

    Voor jou als vibe coder maakt dat weinig uit als je de benchmark gebruikt als denkkader. Gebruik de ranking niet als simpele toolkeuze. Gebruik de benchmarkvraag: zou ik deze wijziging mergen?

    Praktische implicaties voor PromptCoaching-lezers

    Als je begint met vibe coding, test dan niet op gevoel. Maak per project een korte acceptatielijst. Werk je met Cursor, Lovable of Bolt, laat de tool die lijst zichtbaar volgen. Gebruik bij Codex-achtige workflows de voorbeelden uit OpenAI Codex use cases, maar voeg altijd je eigen projectregels toe.

    Mijn oordeel: vibe coding wordt pas serieus wanneer je stopt met juichen bij de eerste preview. De eerste preview is een schets. De mergewaardige versie begint daarna. Wie dat verschil snapt, haalt veel meer uit AI-tools en bouwt minder wegwerpcode.

    De beste prompt vraagt dus niet: “maak dit werkend.” De beste prompt vraagt: “maak dit reviewbaar.”

    Verder lezen

    Vibe coding werkt pas goed als de scope klein genoeg is. Een werkende demo is geen eindpunt; de check zit in testen, uitleggen en veilig publiceren. Lees daarna ook start met vibe coding leren of kies daarna je tool.