TL;DR
- De eenheid van AI-werk verschuift van een los bericht naar een gedelegeerde taak — en daarmee verandert wat je moet kunnen.
- OpenAI’s data: in mei 2026 gaf 70,2% van de gebruikers een opdracht van 1+ uur mensenwerk; binnen OpenAI loopt 99,8% van de output via de agent.
- Goede prompt coaching gaat nu over afbakenen, context geven en beoordelen — niet over slimme zinnetjes.
- Het goede nieuws: dit is een vaardigheid die je kunt leren, los van techniek.
Toen ik begon met mensen te helpen beter met AI te werken, ging het bijna altijd over de prompt: hoe formuleer je je vraag zo dat je een bruikbaar antwoord krijgt? Die vaardigheid blijft nuttig, maar het zwaartepunt verschuift. OpenAI’s onderzoek van 25 juni 2026 laat zien waarheen: van losse vragen naar gedelegeerde taken. En dat verandert wat goede prompt coaching eigenlijk is.
Agent loops: de simpele vorm
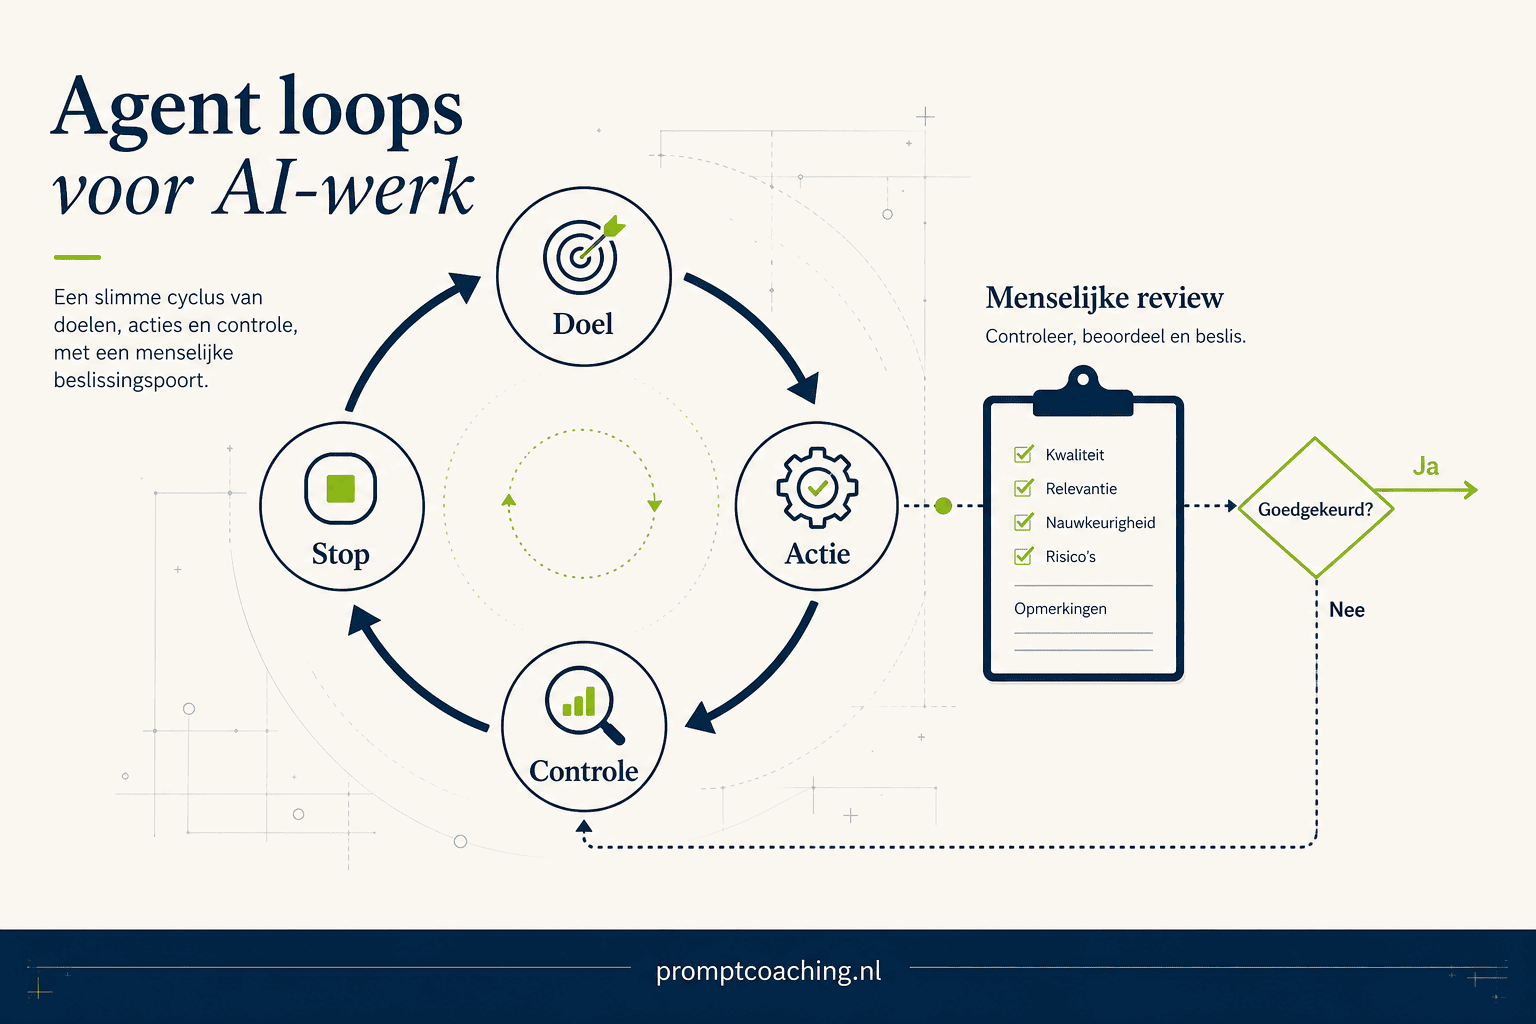
Een agent loop is een taak die zichzelf herhaalt totdat een controle zegt: doorgaan, aanpassen, stoppen of naar een mens. Zonder controle is het geen loop, maar een agent die druk bezig lijkt. Dat is precies waarom de uitleg van Nate Herk goed landt: de kern is niet “autonome AI”, maar een herhaalbare cyclus met een duidelijke uitkomst.
De simpele versie is: doel, actie, controle, stop. Als een van die vier ontbreekt, krijg je output die op werk lijkt maar lastig te vertrouwen is.
De fout: een vaag doel als stopregel gebruiken
“Maak dit beter” is geen loop-opdracht. De agent kan dan eindeloos herschrijven, extra bronnen erbij halen of details toevoegen die niemand nodig heeft. Je krijgt meer tekst, niet per se meer kwaliteit.
Een betere opdracht klinkt saaier, maar werkt beter:
Doel: maak van deze transcriptie een publiceerbare blogupdate.
Actie: haal claims, voorbeelden, hook en bruikbare lessen uit de video.
Controle: check cannibalisatie, bronkwaliteit, interne links en anti-slop.
Stop: publiceer alleen als de pagina een echte lezersvraag oplost.
Slecht versus bruikbaar
| Vage loop | Bruikbare loop |
|---|---|
| Schrijf betere content tot het goed is. | Schrijf een concept, controleer tegen de publicatiegate en stop bij twijfel. |
| Zoek extra bronnen. | Zoek maximaal vijf bronnen en noteer welke claim door welke bron wordt gedragen. |
| Verbeter SEO. | Controleer owner, intent, interne links, titel en de eerste screen. |
| Ga door tot je klaar bent. | Stop na één verbetercyclus of als bewijs ontbreekt. |
Wanneer gebruik je een agent loop?
Gebruik loops voor terugkerend werk waar controle net zo belangrijk is als productie: contentrefreshes, technische QA, researchdossiers, interne-linkchecks, codefixes met tests. Gebruik geen loop voor een losse vraag waarbij een goed antwoord voldoende is. Dan maak je het werk onnodig zwaar.
Bronvideo: Nate Herk over agent loops. De sterkste les is nuchter: begin niet met “laat de agent autonoom werken”, maar met “hoe weet de agent dat hij moet stoppen?”
Liever luisteren?
Hieronder staat een korte voice-over voor lezers die de uitleg liever beluisteren dan de hele tekst scannen.
De eenheid van werk is verschoven
Een chatbot werkt per bericht: jij vraagt, het model antwoordt, jij stuurt bij. Een agent werkt per taak: je geeft een doel en het systeem werkt daar minuten tot uren zelfstandig naartoe. Het verschil in de cijfers is groot.
Dat betekent dat “de perfecte prompt” niet langer het eindpunt is. Een taak van een uur kun je niet vangen in één slimme zin. Je moet het werk afbakenen, de juiste context meegeven, een aanpak schetsen, en — cruciaal — het resultaat kunnen beoordelen. Dat lijkt veel meer op een opdracht aan een freelancer dan op een zoekopdracht.
Wat je nu zou moeten leren
Drie vaardigheden worden belangrijker dan promptformulering. Afbakenen: wat is precies klaar, en wat valt erbuiten? Context geven: welke voorbeelden, bronnen en grenzen heeft de agent nodig om het zonder jou te kunnen? Beoordelen: hoe controleer je in vijf minuten of een uur werk klopt? Die laatste wordt het belangrijkst: een agent die uren zelfstandig werkt, kan ook uren de verkeerde kant op werken.
Merk op dat dit géén technische vaardigheden zijn. Het zijn dezelfde dingen die een goede teamlead doet als hij werk uitbesteedt. Dat sluit aan bij wat het onderzoek het sterkst laat zien: niet-developers groeien het hardst. Je hebt geen programmeerachtergrond nodig om hier goed in te worden — je hebt oordeel nodig en oefening.
Oefenen met delegeren hoeft niet abstract. Kies een taak met een duidelijk eindresultaat — videogeneratie is er zo een — en kijk hoe anderen hun opdrachten formuleren. De Veo 3 prompt voorbeelden laten goed zien hoeveel context en grenzen een bruikbare opdracht bevat.
Hoe ik dit in coaching aanpak
In plaats van “laten we je prompts aanscherpen” werk ik nu vaker aan één echte taak van je eigen werk: we bakenen hem samen af, geven de agent de juiste context, laten hem lopen, en we leren vooral van het beoordelen en corrigeren. Wie van een ander gereedschap komt, herkent dit als overdracht: niet de tool, maar je manier van werken verhuist mee. Daarover schreef ik in van een ander AI-werktuig migreren. En hoe teams hun eigen werkwijze rond agents inrichten, las ik terug in hoe teams hun workflow rond agents inrichten.
De sprong die telt is niet van een goede prompt naar een betere prompt. Het is van vrágen naar delégeren. De cijfers van deze week laten zien dat de mensen die die sprong maken, AI op een heel ander niveau inzetten — en dat het een vaardigheid is, geen talent.
Cijfers uit OpenAI’s onderzoekspaper The shift to agentic AI: evidence from Codex (25 juni 2026). Bron: openai.com — How agents are transforming work. De tijdsschattingen zijn door OpenAI model-geschat en richtinggevend, niet exact.