Gepubliceerd op 9 juni 2026; aangevuld op 18 oktober 2026.
Vibe coding testen begint niet bij de vraag of de app start. Dat is de ondergrens. De betere vraag is: kan iemand deze AI-code reviewen, aanpassen en veilig mergen zonder de hele boel opnieuw te moeten bouwen?
Cognition raakt met FrontierCode precies dit punt. De benchmark meet volgens Cognition niet alleen of code werkt, maar of een maintainer de pull request zou accepteren. Voor iedereen die met Cursor, Codex, Claude Code, Lovable of Bolt bouwt, is dat een nuttiger criterium dan “de demo doet het”.
AI-output controleren: een fout bedrag
AI-output controleren met alleen een JSON Schema liet in onze proef het verkeerde bedrag door. 173.99 werd geaccepteerd waar 173.42 was afgesproken. De velden en typen klopten; de uitkomst niet.
Bij AI-output controleren is een schema daarom één controle, geen eindbeoordeling. Leg de verwachte inhoud vast buiten de uitvoer die je probeert te controleren.
Het schema accepteerde ook het verkeerde bedrag
We draaiden een echte JSON Schema-validator en daarnaast een aparte vergelijking met Decimal. De invoer bestond uit vier gemaakte testgevallen. Er is geen taalmodel aangeroepen en er is geen AI-foutpercentage gemeten.
| Testgeval | Schema geldig? | Aparte inhoudscontrole akkoord? |
|---|---|---|
Bedrag 173.42, aanwezige itemlijst |
Ja | Ja |
Bedrag 173.99, aanwezige itemlijst |
Ja | Nee |
| Verplicht bedrag ontbreekt | Nee | Nee |
Afgesproken leeg resultaat: 0.00 en [] |
Ja | Ja |
Het JSON Schema-objectcontract kan bijvoorbeeld vastleggen welke velden verplicht zijn en of extra eigenschappen zijn toegestaan. Het weet niet welk bedrag jouw bronfactuur of berekening had moeten opleveren, tenzij je die voorwaarde afzonderlijk vastlegt.
Bereken het verwachte bedrag onafhankelijk
De aparte controle vergeleek het bedrag met een vooraf gekozen verwachting. Decimal hield de vergelijking bij decimale waarden; Python documenteert waarom die representatie bestaat.
Dit volledige controlevoorbeeld bevat de vier gemaakte gevallen. Het vraagt Python met het pakket jsonschema; Decimal zit in Python zelf. Bewaar de code als check_totals.py en voer python3 check_totals.py uit. De code installeert niets en roept geen AI of API aan.
#!/usr/bin/env python3
"""Four fictional cases; JSON Schema validation followed by a separate expected-value check.
Requires the jsonschema Python package. Installs nothing and calls no AI/API.
"""
from decimal import Decimal,InvalidOperation
from jsonschema import Draft202012Validator
import json
SCHEMA={'type':'object','required':['total','items'],'additionalProperties':False,'properties':{'total':{'type':'string','pattern':r'^[0-9]+\.[0-9]{2}$'},'items':{'type':'array'}}}

def check(value,expected):
    schema_ok=Draft202012Validator(SCHEMA).is_valid(value)
    if not schema_ok:return {'schema_valid':False,'amount_matches':False}
    try:amount_ok=Decimal(value['total'])==Decimal(expected)
    except (InvalidOperation,TypeError):amount_ok=False
    return {'schema_valid':True,'amount_matches':amount_ok}
if __name__=='__main__':
    cases=[('correct',{'total':'173.42','items':['a']},'173.42'),('wrong_amount',{'total':'173.99','items':['a']},'173.42'),('missing_field',{'items':['a']},'173.42'),('valid_empty',{'total':'0.00','items':[]},'0.00')]
    print(json.dumps([{'case':name,**check(value,expected)} for name,value,expected in cases],indent=2))
Het verkeerde bedrag geeft schema_valid: true en amount_matches: false. Het ontbrekende veld geeft twee keer false; het juiste bedrag en het afgesproken lege resultaat geven twee keer true. De verwachting is vast testmateriaal, geen door een model bepaald antwoord.
Wij vinden een gegenereerde validator onvoldoende als zijn verwachte antwoord uit dezelfde ongecontroleerde uitvoer komt. Dan kan hij dezelfde fout bevestigen. Geef hem een bekende afwijking en controleer of hij die werkelijk afwijst. Een opdracht aanscherpen met de Prompt Coach is een andere stap; daarmee is de uitvoer nog niet onafhankelijk gevalideerd.
Een lege lijst kan precies goed zijn
Alles wat leeg is afkeuren klinkt streng, maar in de vierde proef was het afgesproken lege resultaat juist. De juiste vraag is welke combinatie van bedrag en items je toepassing toestaat. Een lege inventaris, nul gevonden fouten of geen nieuwe berichten kan een geldig antwoord zijn.
Ook onze eigen aparte controle kan het verkeerde uitgangspunt bevatten. De vooraf gekozen verwachting moet daarom uit een betrouwbare bron of onafhankelijke berekening komen. Decimal maakt een onjuiste verwachting niet waar.
Pas dit toe vóór je AI-sitecontrole voor publicatie: maak één bewust fout bedrag, één ontbrekend veld en één legitiem leeg resultaat. Controleer welke gevallen jouw eigen software accepteert. Wie met een codemodel werkt, heeft daarmee een concreter gesprek dan “schrijf betere tests”.
Bij prompt coaching helpt zo’n vast tegenvoorbeeld om een concrete wijziging te beoordelen. Bij de volgende gegenereerde versie moeten dezelfde tegengevallen opnieuw de afgesproken uitslag geven. Een geldige JSON-vorm blijft het begin van de controle.
Bronnen en leeswijzer
| Bron en datum | Waarvoor in dit stuk |
|---|---|
| Cognition, “Introducing FrontierCode”, 8 juni 2026 | Opzet van de benchmark en de beoordelingscriteria |
| Cognition, FrontierCode-resultaten (data.json), gecontroleerd 19 oktober 2026 | Diamond-scores per systeem in de tabel hieronder |
| SWE-bench, officiële ranglijsten, geraadpleegd 19 oktober 2026 | Achtergrond bij SWE-bench Verified |
| METR, “Many SWE-bench-passing PRs would not be merged into main”, 10 maart 2026 | Hoe vaak test-passing PR’s toch niet mergewaardig zijn |
| Terminal-Bench, geraadpleegd 19 oktober 2026 | Leeswijzer: een andere benchmark voor agents in de terminal |
| JSON Schema, object-referentie, geraadpleegd 19 oktober 2026 | Verplichte velden en extra eigenschappen in de bedragproef |
| Python-documentatie, decimal, geraadpleegd 19 oktober 2026 | Decimale vergelijking in de bedragproef |
De aanleiding
Cognition introduceerde FrontierCode als nieuwe coding eval voor moeilijkheid en kwaliteit. De taken zijn volgens Cognition gebouwd met open-source maintainers en kostten meer dan 40 uur werk per taak. De benchmark vraagt niet alleen of een oplossing de tests haalt. Hij vraagt of de code mergewaardig is.
Dat woord is belangrijk voor vibe coding. Veel beginners gebruiken AI alsof de eerste werkende output het eindpunt is. Ze beschrijven een app, de tool bouwt iets, de preview opent en de conclusie is: het werkt. Maar “werkt in preview” betekent weinig. De echte problemen komen later: state die niet klopt, auth die lekt, routes die niet indexeerbaar zijn, componenten die niet te onderhouden zijn, tests die ontbreken, of code die een volgende prompt niet meer stabiel kan aanpassen.
Promptcoaching.nl is gebouwd rond prompting, vibe coding en de Prompt Coach. Test AI-code op de verwachte uitkomst, ontbrekende gegevens en foutieve waarden, ook als de uitvoer er correct uitziet. Dit artikel hoort daarom niet als algemeen AI-nieuws, maar als praktische beoordelingsgids: hoe test je AI-code voordat je ermee verder bouwt?
Waarom “maak dit werkend” een matige prompt is
Een AI-tool optimaliseert vaak op het criterium dat jij zichtbaar maakt. Vraag je om een werkende knop, dan krijg je een werkende knop. Vraag je om een route die getest, toegankelijk, onderhoudbaar en rollbackbaar is, dan krijgt het model een andere opdracht.
De meeste vibe coding fouten beginnen niet bij het model. Ze beginnen bij een te vage succesdefinitie. Drie versies van dezelfde opdracht:
| Opdracht | Reviewbaar? |
|---|---|
| “Maak een dashboard” | Nee, er staat niet in wanneer het klaar is |
| “Maak een dashboard met drie states, expliciete loading/error states, geen mockdata in productie, herbruikbare componenten en tests voor filters” | Beter |
| “Wijzig alleen deze componenten, leg aannames vast, voeg testcases toe en geef een diff-samenvatting.” | Nog beter |
FrontierCode maakt die tweede manier van denken zichtbaar. Cognition zegt dat de benchmark criteria gebruikt voor correctness, test quality, scope discipline, style en adherence to codebase standards. Dat zijn precies de criteria die je in een goede prompt moet zetten als je met AI code laat schrijven.
| Testcriterium | Concreet geval | Uitkomst in onze validator |
|---|---|---|
| Vorm én bedrag kloppen | 173.42 bij verwacht 173.42 | Schema en bedragcontrole slagen |
| Geldige vorm, verkeerd bedrag | 173.99 bij verwacht 173.42 | Schema slaagt; bedragcontrole faalt |
| Verplicht veld ontbreekt | Bedragveld ontbreekt | Schema faalt |
| Leeg resultaat mag volgens afspraak | Geldige lege lijst | Controle slaagt; leeg is hier geen fout |
Wat de FrontierCode scores zeggen over vibe coding
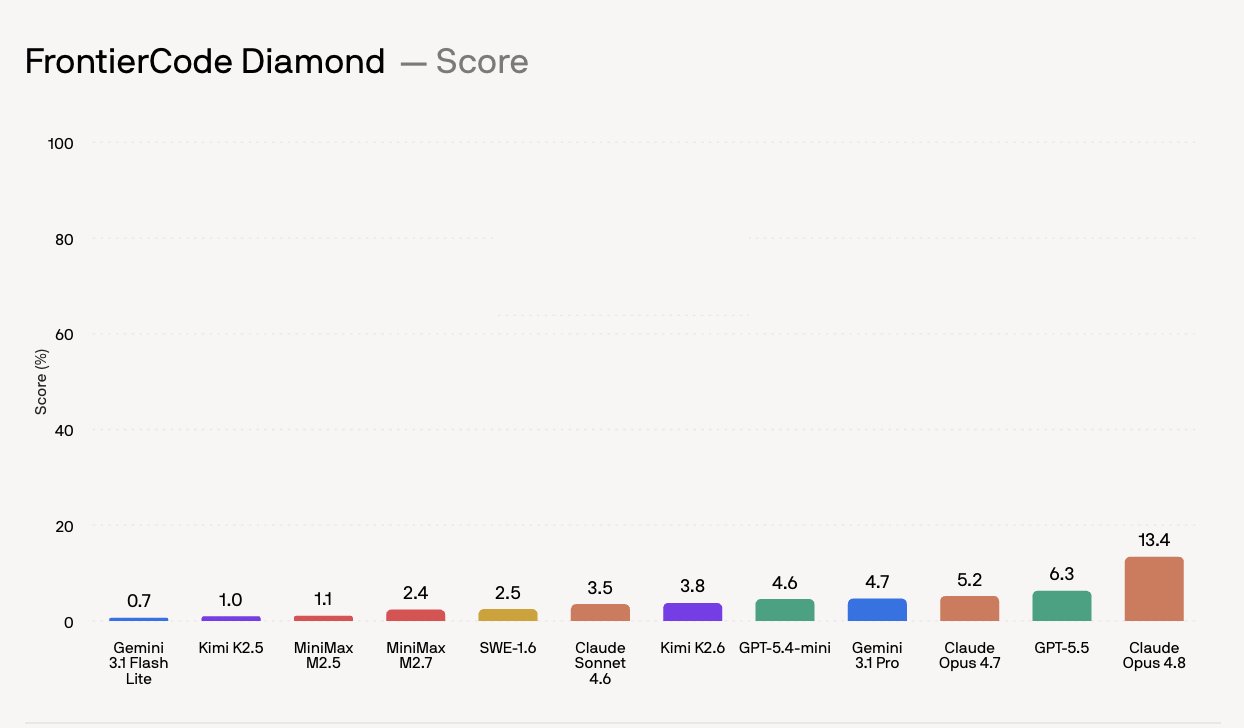
De hardste FrontierCode-subset heet Diamond. Daar scoort Claude Opus 4.8 via Claude Code volgens de Cognition-data 13,4%. GPT-5.5 via Codex haalt 6,3%. Claude Opus 4.7 via Claude Code haalt 5,2%. Zelfs de beste systemen zitten dus laag wanneer de vraag verschuift van “maak iets werkends” naar “maak iets dat een maintainer zou mergen”.
| Model | Werkomgeving | Instelling | Diamond-score |
|---|---|---|---|
| Claude Opus 4.8 | Claude Code | xhigh | 13,4% |
| GPT-5.5 | Codex | medium | 6,3% |
| Claude Opus 4.7 | Claude Code | medium | 5,2% |
Je moet die cijfers niet lezen als reden om AI-code te negeren. Lees ze als reden om je proces serieuzer te maken. AI kan enorm versnellen. Maar de versnelling heeft alleen waarde als je reviewlaag meegroeiet. Anders ruil je bouwtijd in voor onderhoudsschuld.
OpenAI liet bij SWE-bench Verified al zien hoe lastig benchmarkkwaliteit is. Bij het maken van SWE-bench Verified werd 68,3% van de beoordeelde samples weggefilterd omdat issuebeschrijvingen, tests of andere criteria problematisch waren. METR liet later zien dat test-passing SWE-bench PR’s door maintainers veel minder vaak mergewaardig werden gevonden dan de automatische scores suggereren. FrontierCode is Cognition’s poging om die reviewrealiteit directer te meten.
Een betere prompt voor AI-code
Als je met vibe coding werkt, moet je prompt niet alleen de feature beschrijven. Je prompt moet de reviewcriteria beschrijven. Gebruik bijvoorbeeld dit patroon:
Doel:
Bouw [feature] voor [gebruikerstaak].

Scope:
Wijzig alleen [bestanden/componenten].
Maak geen brede refactor.

Kwaliteit:
- Voeg loading, empty en error states toe.
- Houd bestaande stijlen en componentpatronen aan.
- Voeg tests toe voor [cases].
- Leg aan het einde uit welke aannames je maakte.

Acceptatie:
De wijziging is pas klaar als de app buildt, tests slagen en de diff klein genoeg is om te reviewen.
Dit is geen magische prompt. Het is een manier om de agent niet alleen te laten produceren, maar ook te laten werken binnen een reviewbaar contract. De Prompt Coach kan hierbij helpen omdat je prompts kunt beoordelen op rol, taak, context, constraints en outputformat. Voor code moet je daar acceptatiecriteria en testgedrag aan toevoegen.
Maak je eigen mini-FrontierCode voor projecten
Je hebt geen groot benchmarkteam nodig om beter te testen. Maak per project een kleine evalset met taken die jij echt belangrijk vindt. Voor een Lovable-app kunnen dat SEO-rendering, formulierfouten, mobile layout en routing zijn. Voor een interne tool kunnen dat permissies, export, filters en auditlogs zijn. Voor een WordPress plugin kunnen dat hooks, backwards compatibility en settings validation zijn.
Laat de AI-tool dezelfde taak meerdere keren oplossen. Beoordeel niet alleen of de output werkt. Leg de runs naast elkaar:
| Reviewvraag | Waar je naar kijkt |
|---|---|
| Was de diff klein genoeg? | Aantal gewijzigde bestanden en regels per run |
| Bleef de agent binnen de afgesproken scope? | Wijzigingen buiten de genoemde bestanden of componenten |
| Zijn er tests of controlecases toegevoegd? | Nieuwe tests, en of ze falen zonder de wijziging |
| Is de code begrijpelijk voor iemand anders? | Of een collega de diff kan uitleggen zonder de chat te lezen |
| Kan de wijziging later veilig worden aangepast? | Vaste waarden, gekopieerde logica en aannames die nergens staan |
Dit is precies waar veel vibe coding beginners te weinig aandacht aan geven. Ze vergelijken tools op snelheid en uiterlijk. De betere vergelijking gaat over herstelbaarheid. Welke tool maakt fouten die je kunt vinden? Welke tool houdt instructies vast? Welke tool raakt minder vaak bestanden aan die buiten scope liggen? Welke tool legt zijn aannames helder uit?
Privétaken maken FrontierCode niet zelfstandig narekenbaar
FrontierCode is niet volledig reproduceerbaar voor buitenstaanders, omdat Cognition de taken prive houdt om contaminatie te voorkomen. Dat is verdedigbaar, maar het betekent dat je de benchmark niet zelfstandig kunt narekenen. De ranking combineert ook model en agentharness. Claude Code, Codex en Gemini CLI zijn verschillende werkomgevingen. Een score zegt dus niet alleen iets over het model, maar ook over de tooling eromheen.
Voor jou als vibe coder maakt dat weinig uit als je de benchmark gebruikt als denkkader. Gebruik de ranking niet als simpele toolkeuze. Gebruik de benchmarkvraag: zou ik deze wijziging mergen?
Praktische implicaties voor PromptCoaching-lezers
Als je begint met vibe coding, test dan niet op gevoel. Maak per project een korte acceptatielijst.
| Je werkt met | Doe dit |
|---|---|
| Cursor, Lovable of Bolt | Laat de tool die lijst zichtbaar volgen. |
| Codex-achtige workflows | Gebruik de voorbeelden uit OpenAI Codex use cases, maar voeg altijd je eigen projectregels toe. |
Mijn oordeel: vibe coding wordt pas serieus wanneer je stopt met juichen bij de eerste preview. De eerste preview is een schets. De mergewaardige versie begint daarna. Wie dat verschil snapt, haalt veel meer uit AI-tools en bouwt minder wegwerpcode.
De beste prompt vraagt dus niet: “maak dit werkend.” De beste prompt vraagt: “maak dit reviewbaar.”