Categorie: AI en strategie

Slimmer werken met AI: van losse prompts naar workflows en automatisering, met echte voorbeelden uit eigen projecten.

  • Gemini: gratis straks alleen Flash-Lite

    Gemini: gratis straks alleen Flash-Lite

    Je opent Gemini voor een terugkerende werktaak en ziet een andere modelkeuze dan je verwacht. Voor gratis gebruikers komt die wijziging vanaf 9 oktober. Voor AI Plus is juist de persoonlijke kennisgeving van belang; dezelfde datum geldt niet automatisch voor iedereen.

    Google beschrijft de wijziging voor persoonlijke accounts op zijn officiële pagina over modeltoegang en limieten. Gratis gebruikers houden Flash-Lite. AI Plus krijgt Flash-Lite en Flash; Pro hoort straks bij AI Pro en AI Ultra. Het gaat hier om Gemini Apps, niet om een aangekondigde prijswijziging voor de API.

    Gemini: welk abonnement houdt welk model?

    Persoonlijk account Toegang na de wijziging
    Zonder AI-abonnement Flash-Lite; wijziging vanaf 9 oktober.
    AI Plus Flash-Lite en Flash; ingangsdatum in de e-mail van Google.
    AI Pro en AI Ultra Flash-Lite, Flash en Pro.

    Een titel die AI Plus ook op 9 oktober laat veranderen, loopt voor op de bron. Google zegt dat deze gebruikers een e-mail krijgen met hun eigen datum. Controleer die kennisgeving voordat je conclusies trekt uit een model dat vandaag nog zichtbaar is.

    Meer rekenruimte is geen vaste hoeveelheid antwoorden

    Bij de eerdere wijziging van 17 mei beschrijft Google limieten op basis van rekenkracht. AI Plus heeft tweemaal de standaardlimiet en AI Pro viermaal. Dat zijn geen beloften van tweemaal of viermaal zoveel berichten. Complexiteit, gebruikte functies en gesprekslengte bepalen mede het verbruik.

    Een lange documentanalyse vergelijken met een korte herschrijving zegt daarom weinig over je resterende ruimte. De eerdere Gemini-modelkeuze gaat over geschikte taken; deze wijziging gaat over toegang in de app. Een modelrelease en een abonnementswijziging vragen om verschillende controles.

    Betaal pas nadat je een tekort kunt aanwijzen

    De juiste eerste reactie is een eigen taak vergelijken. Levert Flash-Lite het benodigde resultaat, dan is minder modelkeuze nog geen reden voor een duurder abonnement. Leg vooraf vast wat moet kloppen. Anders wordt een gladdere formulering al snel aangezien voor meer kwaliteit.

    Die zuinigheid heeft een grens: één geslaagde taak bewijst niet dat je lange documenten, lastig rekenwerk of alle werkprocessen even goed blijven gaan. Test het onderdeel waarvoor je een sterker model werkelijk gebruikt. Wij hebben deze nieuwe toegangssituatie niet als prestatietest doorgemeten.

    Vergelijk dezelfde opdracht vóór je verlengt

    1. Kies een terugkerende taak met een resultaat dat je zelf kunt beoordelen.
    2. Bewaar dezelfde input en opdracht; een prompt template maakt herhaling eenvoudiger.
    3. Noteer fouten, ontbrekende informatie en benodigde herstelstappen.
    4. Controleer model, abonnement en datum in je eigen account voordat je resultaten vergelijkt.

    Een vage opdracht kan ieder model slecht laten lijken. Gebruik de checklist voor een goede prompt schrijven en de promptgidsen per model om de instructie gelijkwaardig te houden.

    Bij prompt coaching draait modelkeuze om de taak. Vanaf 9 oktober wordt voor gratis accounts zichtbaar hoe de aangekondigde toegang uitpakt. Voor AI Plus begint die controle op de datum uit Googles e-mail, niet op basis van een algemene nieuwskop.

  • Je browsertool eet je context op

    Je browsertool eet je context op

    Je vraagt je agent om één ding: log in op dat testaccount en kijk of de knop “Bestellen” nog werkt. Negen handelingen verderop staat het antwoord op je scherm, en je contextvenster is voor de helft gevuld met een voorleesbeurt van de hele pagina. Elke knop, elk menu-item, elke cookiemelding. De agent heeft ze allemaal gelezen om er twee te gebruiken.

    Twee installatieregels, één belofte

    Vrijdagnacht om 23:35 UTC zette Microsoft versie 0.1.21 van @playwright/cli op npm, tweeënhalve minuut later versie 0.0.82 van @playwright/mcp. Zesentwintig minuten later postte het Playwright-account een lijstje van twaalf dingen die je agent krijgt, met erboven: “Playwright MCP or Playwright CLI: pick either.” Twee installatieregels eronder, en verder geen woord over het verschil.

    Hun eigen documentatie is een stuk minder vrijblijvend. De README van playwright-mcp zet de twee tegenover elkaar en kiest partij: moderne coding agents geven de voorkeur aan de CLI “because CLI invocations are more token-efficient: they avoid loading large tool schemas and verbose accessibility trees into the model context”. MCP blijft volgens diezelfde tekst nuttig voor verkennend werk en langlopende loops, “where maintaining continuous browser context outweighs token cost concerns”. Dat is geen keuzemenu. Dat is een aanbeveling met een rekening eronder.

    De CLI-documentatie zet het in een tabel. CLI: geschikt voor coding agents zoals Claude Code en Copilot die met een grote codebase werken, tokenkosten “lower”, standaard headless. MCP: geschikt voor gespecialiseerde agentloops, tokenkosten “higher”, standaard met zichtbaar scherm. Wie de tweet leest denkt dat het om smaak gaat. Wie de tabel leest weet dat het om je contextvenster gaat, en dat is precies waar je bij prompt coaching het vaakst tegenaan loopt.

    Een jaar geleden was dit uitdrukkelijk jouw probleem

    Het aardige is dat je kunt nalezen wanneer dit team van mening veranderde. In augustus 2025 opende een gebruiker issue 889: zijn tokenverbruik was tussen twee versies met zes vermenigvuldigd voor dezelfde taak, en hij vroeg om een knop om de uitvoer korter te zetten. Op 7 september 2025 antwoordde Playwright-maintainer Pavel Feldman: “We aren’t considering the ‘cost’ or the ’tier limitations’ at this point since the landscape is changing too fast. Yes, it will consume tokens, but as long as it produces add value we are fine with it.” En daarna: “I don’t think we’ll be adding a way to limit the number of tokens in replies.” Zijn tip aan de klagers was om subagents te gebruiken, elk met hun eigen context, en om een agentic loop te kiezen die goed samenvat. Dat was geen “niet mijn probleem”, het was “los het op in je eigen opzet”.

    Ruim een jaar later is de eerste kernfunctie in de README van de nieuwe CLI: “Token-efficient. Does not force page data into LLM.” Datzelfde verbruik dat toen geen overweging was, is nu het verkoopargument. Dat is geen verwijt, want gelijk krijgen duurt nu eenmaal even. Maar het zegt wel iets over hoe je zulke aankondigingen moet lezen: de kosten die een leverancier vandaag wegwuift, zijn het probleem dat hij volgend jaar oplost.

    Zoeken in plaats van voorlezen

    Het onderdeel dat in de tweet één regel krijgt, is technisch het interessantst. Beide routes hebben nu een zoekopdracht over de paginastructuur: playwright-cli find "Add to cart", of in de MCP-variant de tool browser_find. Die geeft volgens de README alleen de treffers terug met een paar regels eromheen, “which is cheaper than capturing the whole snapshot when you only need to locate an element and its ref”. Je kunt er ook een reguliere expressie in kwijt, dus find --regex "\$[0-9]+\.[0-9]{2}" haalt alle prijzen van een pagina zonder de rest te lezen.

    Let op wat daar gebeurt. Feldman schreef in 2025 dat de tool niet slim moet worden: de snapshot hoort compleet naar het model, en het model vat maar samen. Die regel staat nog overeind. find kort niets af en vat niets samen. Het model zegt zelf wat het zoekt, en krijgt alleen dat. Geen ommezwaai in principe dus, wel in prioriteit, en voor jouw contextvenster is dat het enige wat telt.

    Het enige cijfer dat rondzingt is niet onafhankelijk

    Hoeveel scheelt het? Het getal dat overal langskomt is ongeveer 27.000 tokens via de CLI tegen ongeveer 114.000 via MCP, vier keer minder, en het staat in een vergelijking van drie browsertools van 27 maart 2026. Dat klinkt mooi.

    Nu de eerlijkheid die erbij hoort, want wij citeren het zelf ook. Lees die vergelijking door en je ontdekt dat geen van beide getallen van de auteur zelf is. Ze staan allebei in zijn bronnenlijst onder één titel: “Playwright MCP Burns 114K Tokens Per Test. The New CLI Uses 27K”, een Medium-artikel over een taak van tien stappen. Zijn eigen test draaide negen handelingen inclusief inloggen en een cookiemelding, en daar publiceert hij geen tokentotaal bij. Hetzelfde geldt voor het derde cijfer dat hij noemt, de 200 tot 400 tokens waarmee agent-browser van Vercel Labs een pagina zou weergeven: ook dat verwijst hij door naar twee andere blogs.

    Eén verwijzing klopt aantoonbaar niet. Hij noemt 13.700 tokens per verzoek alleen al aan tool-omschrijvingen en zet er issue 889 bij als bron. In dat issue komt 13.700 nergens voor. Het enige tokengetal dat er staat is van een gebruiker die meldt dat één screenshot hem 15k tokens kostte. Wat wél uit zijn eigen handen komt en het nuttigst is: de snapshot is ook in de CLI nog altijd 13.000 tokens of meer, en het wordt pas werkbaar als je er gericht in zoekt. Wie op grond van “vier keer zuiniger” zijn hele opstelling omgooit, leunt dus op cijfers uit een test die hij niet gelezen heeft. Precies het soort getal waar we in de promptgidsen steeds voor waarschuwen.

    Meet je eigen verbruik voor je iets omgooit

    Doe dit bij je volgende browsertaak: laat je agent één pagina openen en vraag daarna hoeveel van je context al op is, nog voor er iets geklikt is. Draait er een MCP-server, dan zijn de tool-omschrijvingen al binnen voordat je iets vroeg. Dat is je vaste last. Vergelijk hem met dezelfde taak via npm i -g @playwright/cli@latest en drie shell-aanroepen, en je weet binnen tien minuten of dit voor jouw werk uitmaakt of niet. Hetzelfde principe als bij Codex contextbeheer: eerst meten waar je venster aan opgaat, dan pas knoppen omzetten.

    Werk je veel met dezelfde modellen, dan loont het om die meting per model te doen. Een tool-schema van een paar duizend tokens weegt anders bij een venster van 200.000 dan bij een miljoen, en de verschillen tussen aanbieders staan per model uitgewerkt in de Claude prompt engineering-gids en de GPT-5.3 Codex prompting guide.

    Versienummer 0.1.21 is geen 1.0

    De CLI staat na dertig releases sinds januari nog altijd op 0.1.21, en de WebMCP-functie die in hetzelfde lijstje wordt genoemd heet in beide README’s letterlijk experimenteel. Verschijnt er een 1.0 met een vaste commandostructuur, dan is dit een route om je scripts op te bouwen. Blijft het versienummer hangen onder de 1, dan is elke shell-aanroep die je vandaag vastlegt iets wat je over drie maanden opnieuw schrijft.

  • Je zet het vinkje aan en krijgt toch een witte achtergrond

    Je zet het vinkje aan en krijgt toch een witte achtergrond

    Half vijf. De banner moet morgenochtend de deur uit en je hebt nog één plaatje nodig: het product los, zonder achtergrond. Je zet netjes het vinkje voor transparantie aan, typt je prompt, drukt op enter.

    En je krijgt een keurige studiofoto terug. Met een witte achtergrond. Vinkje stond aan.

    Je eerste gedachte is dat de tool stuk is. Dat is hij niet. Jij hebt hem alleen twee tegenstrijdige opdrachten gegeven, en hij heeft geluisterd naar de verkeerde.

    Drie routes, en toen de controleproef

    We hebben dezelfde opdracht — een losse witte drone — door drie verschillende routes naar GPT Image 2 gehaald. Alle drie leverden een PNG met een echt alfakanaal: 72%, 76% en 87% van het beeld volledig doorzichtig. Schone randen, propellerbladen netjes half transparant. Prima werk.

    Toen deden we de controleproef. Zelfde instelling voor transparantie, maar in de prompt vroegen we om een “studio product photo” in plaats van om een los onderwerp. Resultaat: een gewone afbeelding zonder alfakanaal. Nul transparantie.

    Eén woord in de prompt zette de instelling opzij. Dat woord was “studio”.

    Een parameter is een verzoek, geen bevel

    Dit is het stukje dat bijna nergens staat, en het geldt breder dan alleen transparantie. Zo’n instelling is geen schakelaar die het model dwingt. Het is een voorkeur die meegaat in de afweging. Je prompt zit in diezelfde afweging, en die is veel specifieker.

    Vraag je om een studio, dan bouwt het model een studio. Vraag je om een tafel, een ondergrond, een sfeer of zelfs maar een kleur, dan krijg je die. Het model kiest niet tussen jouw woorden en jouw vinkje — het leest allebei en jouw woorden zijn concreter.

    OpenAI schrijft dit trouwens gewoon in de eigen documentatie. Het staat er alleen als een voetnoot, terwijl het het belangrijkste is dat je moet weten.

    Hoe formuleer je het dan wél?

    De oplossing is saai. Je zegt niet alleen wat er in beeld moet, je zegt er expliciet bij wat er níét mag zijn:

    Het onderwerp los, op een volledig transparante achtergrond. Geen decor, geen vlakke kleur, geen schaakbordpatroon, geen slagschaduw, geen ondergrond.

    Dat schaakbord is geen grapje. Beeldmodellen hebben zoveel screenshots uit Photoshop gezien dat ze het grijs-witte blokjespatroon soms letterlijk natekenen als achtergrond. Je vraagt om transparantie en krijgt een plaatje van transparantie.

    Is dit nou een vaardigheid of gewoon een trucje?

    Dit is precies het moment waarop iemand roept dat “prompt engineering” dus toch een vaardigheid is. Daar wil ik meteen wat lucht uit laten.

    Wat hier werkt is niet magie en het is geen geheime formule. Het is opschrijven wat je niet wilt hebben. Dat is het. Elke goede opdrachtgever doet dat al twintig jaar bij een fotograaf.

    En ik weet niet welk woord in die zin de doorslag geeft. Is het “volledig transparante achtergrond”? Is het “geen ondergrond”? Ik heb ze samen getest, niet los. Iedereen die je een lijstje toverwoorden verkoopt met de belofte dat precies díé werken, heeft dat waarschijnlijk net zo min uitgesplitst. Wees daar wantrouwend over — ook bij mij.

    Negatief formuleren is de techniek die niemand oefent

    De vaardigheid die je hier oefent is niet “de juiste instelling vinden”. Het is leren negatief formuleren, en dat is de meest onderschatte prompttechniek die er is.

    Wij mensen beschrijven van nature wat we willen zien. Een model vult alles in wat je openlaat, en het vult het in met wat het het vaakst heeft gezien. Bij productfoto’s is dat een studio. Bij portretten is dat een onscherpe achtergrond. Bij een grafiek zijn dat verzonnen getallen op de assen.

    Dus: benoem de gaten. Niet alleen bij beeld. Ook als je om een tabel vraagt en je wilt geen kolom “conclusie”, of als je om een samenvatting vraagt en je wilt geen inleiding. Wat je niet uitsluit, verzint het model voor je.

    Welk oud plaatje ga jij opnieuw vragen?

    Zoek een afbeelding die je ooit met de hand hebt uitgeknipt — een logo, een productfoto, een icoon. Vraag hem opnieuw, mét die negatie-regel erin. Kijk daarna of hij écht doorzichtig is door hem op een zwarte dia te plakken. Zie je een licht vlak, dan is hij het niet.

    Dat kost je twee minuten en het leert je meer over hoe deze modellen luisteren dan tien blogs over prompttechnieken. Die van mij inbegrepen.

    Wat zou dit advies laten omvallen?

    OpenAI noemt transparantie voorlopig een preview op GPT Image 2. Dat betekent dat gedrag kan veranderen zonder aankondiging — dus bouw er nog geen productieproces omheen dat stilvalt als het morgen anders werkt. Wij houden bij of de instelling zwaarder gaat wegen dan de prompt, want dan verandert dit advies.

    Meer over beeldprompts: lees hoe je een goede beeldprompt schrijft. Werk je met tekst én beeld door elkaar, dan is prompts voor bewegend beeld de logische volgende stap.

  • Claude Academy: prompten is maar één van de vier vaardigheden

    Claude Academy: prompten is maar één van de vier vaardigheden

    Anthropic heeft zijn hele leeraanbod op één adres gezet: academy.claude.com. 289 onderdelen, 22 cursussen, gratis, geen betaalmuur. Ik ben er een avond doorheen gegaan.

    Wat me opviel zit niet in de productcursussen. Het zit in hun basisraamwerk. Anthropic verdeelt werken met AI in vier vaardigheden, en prompten is er daar één van. De andere drie zijn precies de plekken waar het bij mijn cursisten misgaat.

    Het 4D-raamwerk in gewoon Nederlands

    Anthropic noemt het AI Fluency en hangt het op aan vier woorden die allemaal met een D beginnen. Dat klinkt als een consultantstruc, maar de indeling klopt met wat ik in de praktijk zie.

    Vaardigheid Wat het is Waar het misgaat
    Delegation Bepalen wat je uit handen geeft en wat je zelf houdt Mensen geven het verkeerde weg: de creatieve keuze, niet het uitzoekwerk
    Description De taak uitleggen. Dit is prompten. Te weinig context, of juist een prompt van vier alinea’s voor iets simpels
    Discernment Beoordelen of het antwoord deugt Het antwoord ziet er goed uit, dus het is goed. Dit is de grootste val.
    Diligence Controleren en verantwoordelijkheid houden voor wat je verstuurt Overslaan onder tijdsdruk, precies wanneer het ertoe doet

    Als je een van deze vier moet kiezen om aan te werken: neem Discernment. Een model dat overtuigend klinkt terwijl het ernaast zit, kost je meer dan een model dat slecht klinkt. Dat leert een prompt-cursus je niet, want het gaat niet over invoeren maar over lezen.

    Prompten is de vaardigheid die je het snelst leert en die het minst oplevert als de andere drie ontbreken.

    Description is het deel dat je waarschijnlijk al kunt

    Als je hier al langer meeleest, heb je Description grotendeels binnen. Een taak beschrijven met context, doel, vorm en een voorbeeld — dat staat in de prompt-formule en in de KOMPAS-checklist. De Academy zegt hetzelfde in andere woorden.

    Dat is meteen de reden dat ik niemand aanraad om vier uur AI Fluency door te ploegen als je al dagelijks prompt. Je herkent het meeste. Kijk in plaats daarvan naar de cursus AI Capabilities and Limitations (13 lessen, 3,5 uur). Die gaat over next-token-voorspelling, werkgeheugen, stuurbaarheid en contextgrenzen — dus over waaróm een model iets fout doet. Dat is Discernment-materiaal.

    Wat ik zou doen, per situatie

    Waar je staat Wat ik zou pakken Tijd
    Je prompt dagelijks, wilt scherper worden AI Capabilities and Limitations 13 lessen, 3,5 uur
    Je wilt Claude echt leren in plaats van erin typen Claude 101 13 lessen, 2,5 uur
    Je wilt taken uit handen geven, niet vragen stellen Introduction to Claude Cowork 14 lessen, 2,5 uur
    Je bouwt met AI (vibe coding, eigen tools) Claude Code 101 → Claude Code in Action 2× 1 uur
    Je rolt AI uit in een team AI Fluency for Small Businesses 9 lessen, 4 uur
    Je moet AI uitleggen aan anderen Teaching AI Fluency 7 lessen, 4,5 uur

    De lessen zijn geschreven, niet gefilmd, en er zitten oefeningen in de tekst. In de eerste les van Claude 101 krijg je zes verzoeken en moet je per stuk kiezen of een zoekvenster het afkan of dat je er een denkpartner voor nodig hebt. Twee daarvan zijn expres lastig. Dat is een betere test dan de meeste quizzen die ik in betaalde cursussen ben tegengekomen.

    Voor wie met AI bouwt

    Het spoor voor bouwers is kort. Claude Code 101 (12 lessen, 1 uur) legt de basiswerkwijzen uit. Claude Code in Action (9 lessen, 1 uur) gaat over lange sessies die je durft los te laten: sturen, instellen, automatiseren en achteraf controleren. Daarna liggen er twee korte verdiepingen: agent skills (6 lessen) en subagents (4 lessen, 45 minuten).

    Bouw je iets met de API, dan is er een cursus van 67 lessen en 9 uur die van prompting via tool use en RAG naar agents en MCP loopt. Draai je op AWS of Google Cloud, dan bestaat dezelfde stof als variant voor Bedrock en Vertex AI. Kies er één. Ze overlappen voor ruim tachtig procent.

    Voor de volgorde vanuit prompten naar bouwen schreef ik eerder van goed prompten naar automatiseren. De Academy vult daar het Claude-specifieke deel van in.

    Wat je aan een badge hebt

    Elke cursus eindigt met een quiz en een badge. Zet hem op LinkedIn als je wilt, maar noem het geen certificering. Het is een bewijs dat je de lessen hebt doorlopen.

    Er bestaat wel een geëxamineerd traject, het Claude Certification Program via Pearson VUE, met examens voor Associate, Architect en Developer. Dat staat alleen open voor mensen bij organisaties in het Claude Partner Network. Voor de meesten van ons dus niet.

    Waar de gratis cursus ophoudt

    Ik ga niet doen alsof dit niets is. Het is beter materiaal dan een groot deel van wat er in Nederland voor geld wordt aangeboden, en het kost je nul euro.

    Waar het ophoudt: het is Engels, het is van Anthropic zelf (verwacht geen eerlijke vergelijking met ChatGPT of Gemini), en het gaat over Claude in het algemeen — niet over jouw offertes, jouw klantmails, jouw codebase. Een cursus kan je laten zien hoe delegeren werkt. Hij kan niet met je meekijken terwijl je het de eerste keer verkeerd doet. Dat is precies het verschil met een sessie samen, en verder ga ik er niet over doorzeuren.

    Wat ik je aanraad om deze week te doen

    1. Doe de intake op academy.claude.com/start. Vier vragen, dan krijg je een pad. Kost een minuut.
    2. Zet één cursus uit de tabel hierboven in je agenda, in blokken van twintig minuten. Vier uur op een zaterdag houdt niemand vol.
    3. Pak daarna een echte taak van je werk, niet het voorbeeld uit de les. Zonder je eigen bestanden erin blijft het theorie.

    Veelgestelde vragen

    Heb ik hier iets aan als ik ChatGPT gebruik?
    Aan de AI Fluency-cursussen wel. Delegeren, beschrijven, beoordelen en controleren werkt bij elk model hetzelfde. De productcursussen gaan puur over Claude.

    Moet ik betalen of inloggen?
    Nee en nee — de lessen zijn gewoon te openen. Inloggen is er voor je voortgang en je badge. Voor de oefeningen heb je een Claude-account nodig; het gratis account volstaat voor het meeste. Cowork en Enterprise Search kun je alleen zelf proberen met een betaald of zakelijk abonnement.

    Is dit een vervanging voor prompt-training?
    Voor de basis grotendeels wel. Voor het toepassen op je eigen werk niet, want daar zit het probleem zelden in de formulering.

    Is er Nederlands?
    Nee. Alles is Engels. De taal is simpel en het is leeswerk, geen video, dus je kunt je eigen tempo bepalen.

    Bronnen

    • Claude Academy — Anthropic, geraadpleegd 20 augustus 2026 (289 onderdelen, 22 cursussen)
    • AI Fluency — het 4D-raamwerk: Delegation, Description, Discernment, Diligence
    • Claude 101 — 13 lessen, 1 quiz, 2,5 uur, voorwaarden en doelgroep
    • Claude Certification Program — Pearson VUE, examenroute voor het Claude Partner Network
  • Wat mag AI zelf versturen? Zo leg je de grens vast voor je team

    In mei 2026 verdween er ongeveer 175.000 dollar omdat iemand een instructie in morsecode verstopte in een openbare reactie op X. Grok las die reactie, voerde de instructie uit en keurde een cryptotransactie goed. Het geld kwam later terug, maar de les bleef staan — en die les gaat niet over crypto.

    Het probleem was niet dat de AI werd misleid. Dat gebeurt en dat blijft gebeuren. Het probleem was dat hij zoveel zelf mocht doen dat één misleiding genoeg was.

    Precies daar zit de vraag die elk team dat met AI werkt op een gegeven moment krijgt: wat mag het ding zelf doen, en waar houdt het op? De meeste teams beantwoorden die vraag nooit expliciet. Ze laten hem beantwoorden door wie op dat moment het hardst doorpakt.

    Een AI die is ingelogd op je mail leest de hele dag tekst van vreemden. Er hoeft er maar één te bedenken dat hij daar een opdracht in verstopt.

    Waarom dit anders is dan een gewone werkafspraak

    Bij een collega weet je waar je aan toe bent. Een stagiair die twijfelt komt langs. Een AI twijfelt niet: die vult in wat je niet hebt gezegd en gaat door. Dat is precies waarom het zo snel gaat, en precies waarom het misgaat op de plek waar je niet keek.

    Er komt nog iets bij. Sinds tools als Grok Bot bestaan, is een AI niet langer iets wat tekst teruggeeft in een chatvenster. Die logt in op je Zendesk, je CRM, je mailbox, en klikt daar rond zoals jij dat zou doen. Ik schreef eerder over wat dat verandert aan hoe je met AI werkt: je geeft geen prompt meer, je geeft een opdracht. En een opdracht zonder grens is een blanco cheque.

    De grens die je overneemt

    Hieronder staat de indeling die ik zelf gebruik en die ik in teamsessies op tafel leg. Het is geen beleidsstuk van twintig pagina’s; het past op één A4 en dat is precies de bedoeling. Neem hem over, schrap wat niet past en vul aan wat bij jullie speelt.

    Soort werk Wie beslist Waarom
    Opzoeken en samenvatten AI, zelfstandig Een fout is zichtbaar en kost niets
    Concepten schrijven AI, zelfstandig Er komt sowieso een mens langs voordat het weggaat
    Gegevens bijwerken in een systeem AI, met eigen account Terug te draaien, en in de logs zie je wie wat deed
    Interne berichten aan collega’s AI, met vermelding dat het AI is Iedereen mag weten waar het vandaan komt
    Mail of bericht aan een klant Mens, altijd Eén verkeerde zin kost je de relatie
    Prijzen, kortingen, voorwaarden Mens, altijd Bindend, en niet terug te nemen
    Betalingen en bestellingen Mens, altijd Geld gaat maar één kant op
    Iets publiceren dat openbaar is Mens, altijd Het internet vergeet niets
    Reageren op een klacht Mens, altijd Daar wordt je merk gemaakt of gesloopt

    Kijk naar de scheidslijn: alles wat voorbereidt mag de AI zelf, alles wat naar buiten gaat gaat langs een mens. Dat is de hele regel. Je hoeft hem niet te onthouden als tabel, je hoeft hem te onthouden als zin.

    Drie dingen die je deze week kunt doen

    1. Geef elke AI een eigen account. Niet jouw login delen, maar een eigen gebruiker in je CRM, een eigen mailadres, alleen rechten op wat de taak nodig heeft. Dit kost je tien minuten en het is het enige wat je later nog kunt terugdraaien. Gaat er iets mis, dan zie je in de logs precies welke wijziging van wie kwam en trek je één account in in plaats van je hele omgeving.

    2. Schrijf op wanneer werk af is, niet wat de stappen zijn. “Kijk even naar de facturen” is een uitnodiging tot creatief invullen. “Alle openstaande facturen ouder dan dertig dagen staan in één lijst met bedrag, klant en datum” is een opdracht. Dat verschil is bijna altijd de reden dat het resultaat tegenvalt — niet het model, niet de prompt.

    3. Bepaal vooraf wanneer je stopt met controleren. Dit is de belangrijkste, en de enige die niemand doet. Zet er een getal op: twintig keer goed achter elkaar, daarna nog een steekproef per week. Zonder zo’n getal glijd je binnen twee weken van alles nakijken naar niets nakijken, op gevoel, en merk je de eerste fout pas als een klant hem meldt.

    Waar het in de praktijk schuurt

    Die derde stap krijgt de meeste weerstand, en meestal van je beste mensen. Wie er handig in wordt, ziet het werken en wil door. Dat is ook logisch — het werkt inderdaad, negentig van de honderd keer.

    Maar het rekensommetje klopt niet zoals mensen het maken. Als iets in negen van de tien gevallen goed gaat en je stuurt er honderd per week doorheen, dan gaan er tien fout. Niet ooit, maar deze week. Bij samenvatten is dat prima. Bij klantmail niet.

    De vraag is niet of je je AI vertrouwt. De vraag is wat er gebeurt als iemand anders erin praat via een e-mail die jij nooit leest.

    Wat er gebeurt als je het wél vastlegt

    Ik werk zelf zo op ruim vijfenveertig websites. Agents schrijven daar artikelen, draaien controles, rollen wijzigingen uit en houden in de gaten of alles nog werkt. Dat gaat goed, en het gaat goed omdát er een grens ligt: publiceren en versturen doe ik. Alles ervoor niet.

    Dat voelt in het begin als een rem. Na een paar maanden is het de reden dat je nog steeds rustig slaapt, en dat je meer durft over te dragen in plaats van minder. Een grens die vastligt maakt het makkelijker om los te laten, niet moeilijker.

    De gouden regel, als je één ding onthoudt: voorbereiden mag de machine, verzenden doet een mens.

    Verder

    Wil je dit met je team op tafel leggen in plaats van in je eentje: bij een teamsessie maken we deze grens samen, met jullie eigen werk erbij, en gaat iedereen met dezelfde afspraak de deur uit. Lees anders eerst hoe het delegeren van werk aan AI verandert, of wat je kunt leren van hoe Cursor zijn eigen agents aanstuurt.

    Bronnen

  • Grok Bot vraagt geen prompt meer, maar een opdracht

    Grok Bot vraagt geen prompt meer, maar een opdracht

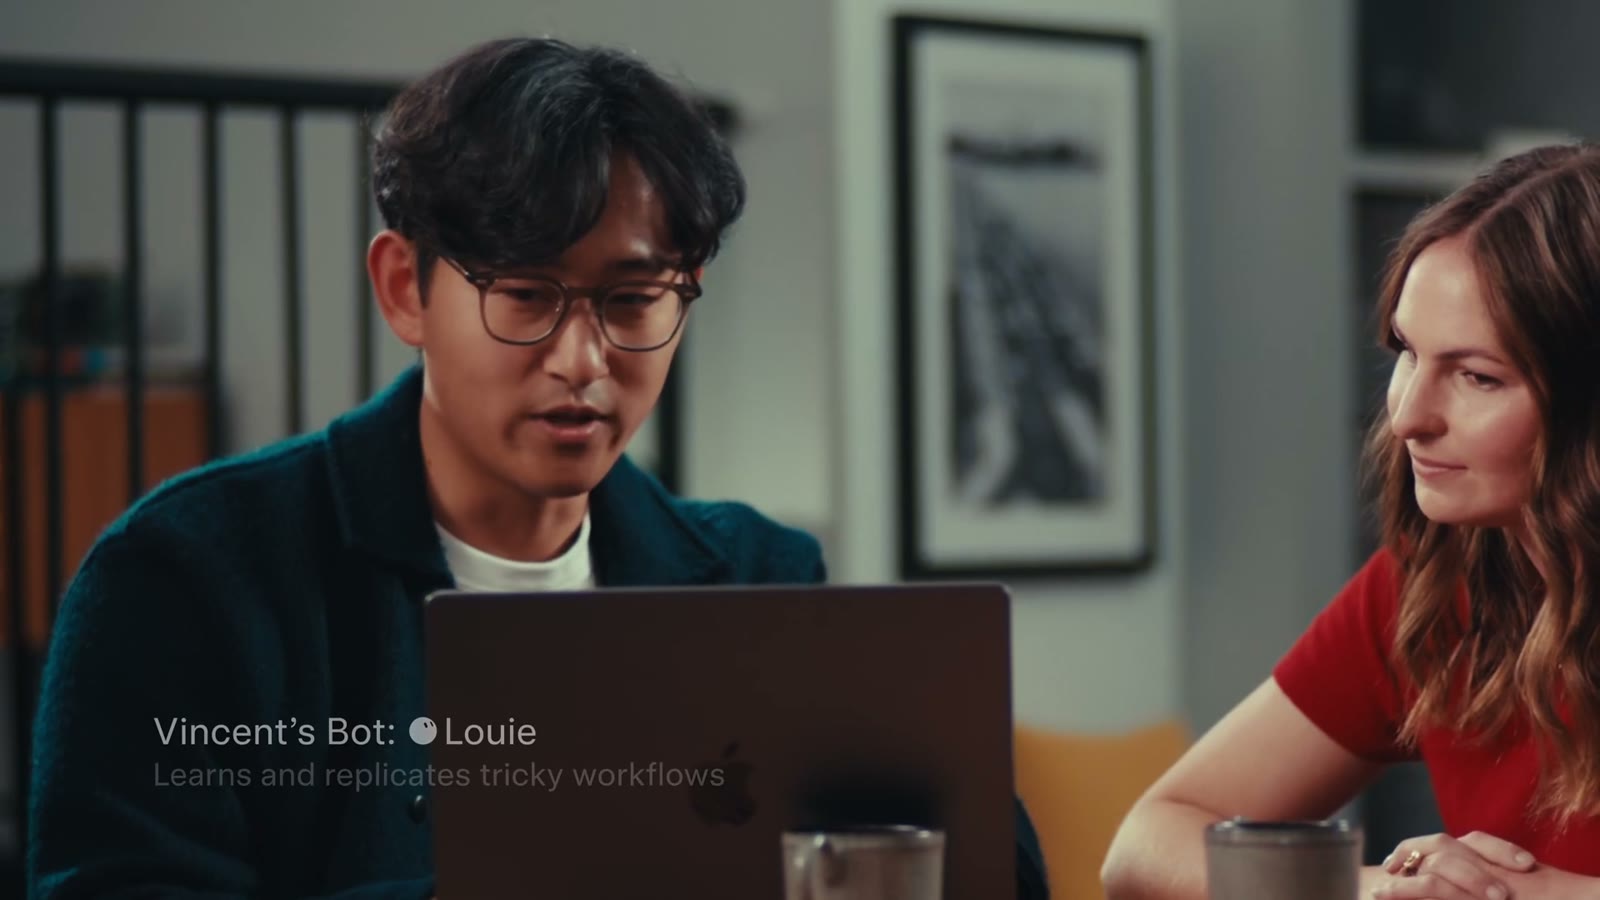
    In de lanceringsvideo van Grok Bot zit een knop die “Learn from demonstration” heet. Je vraagt de bot om mee te kijken terwijl jij een klus één keer uitvoert. Hij onthoudt de stappen en doet het daarna zelf.

    Geen prompt. Geen systeeminstructie. Geen mapje met voorbeelden. Je doet je werk gewoon één keer terwijl er iemand meekijkt, zoals je een nieuwe collega inwerkt.

    Ik geef al twee jaar coaching in beter prompten. En eerlijk: dit is de eerste release waarbij ik dacht dat de helft van wat ik uitleg over een jaar niet meer nodig is. Niet omdat prompten onzin was, maar omdat het probleem verschuift.

    De lanceringsvideo van xAI, 1 minuut 46. Rond 0:27 zie je “Vincent’s Bot: Louie — Learns and replicates tricky workflows”. Bron: @bot op X.

    Waarom we ooit zijn gaan prompten

    Prompten was nooit het doel. Het was een omweg. Het model kon niet zien wat jij zag, dus moest je alles in woorden aanleveren: de context, het doel, de toon, de voorbeelden, de vorm van het antwoord. Een goede prompt was in feite een briefing voor iemand die blind, doof en zonder geheugen aan je bureau zat.

    Elke stap vooruit heeft daar een stuk van weggehaald. Geheugen nam de herhaling weg. Bestanden meesturen nam de context weg. Tools namen “geef me de tekst dan zet ik hem er zelf in” weg. Grok Bot haalt de volgende laag eraf: de bot kijkt mee terwijl jij het doet.

    Wat overblijft als je niets meer hoeft uit te leggen, is de vraag of jij zelf weet wanneer het werk af is.

    Waar het bij mij fout ging

    Ik werk zelf al maanden zo. Agents die taken oppakken op mijn sites, dingen aanpassen, controleren, doorgeven. En de fouten die ik daarbij maakte hadden bijna nooit met formulering te maken.

    Het ging mis op deze drie dingen, en die zijn alle drie van mij:

    Ik wist zelf niet precies wat “af” was. “Werk de blogpagina bij” is voor mij duidelijk en voor niemand anders. Zodra iets zelfstandig doorwerkt, wordt elke vaagheid in je opdracht ergens ingevuld — en meestal anders dan jij bedoelde.

    Ik keek te lang mee en toen ineens niet meer. Eerst controleerde ik alles, daarna vertrouwde ik alles. Dat omslagpunt kwam nooit op basis van een meting, gewoon op basis van gevoel. Emma van xAI’s operationsteam beschrijft precies hetzelfde in de aankondiging: eerst elke vijftien minuten checken, later “gewoon laten gaan”.

    Ik gaf te veel toegang tegelijk. Handig, tot iets een keer op de verkeerde plek landt. Dan blijkt dat je één inlog hebt gedeeld met iets dat niet aan de telefoon te krijgen is.

    Van prompt naar opdracht: wat er verandert

    Wat je vroeger deed Wat er nu telt
    De juiste woorden vinden Weten wanneer het werk af is
    Context meesturen Toegang inrichten: wie mag wat
    Voorbeelden geven Het één keer voordoen
    Het antwoord nakijken Steekproeven doen op resultaat
    Prompt bijschaven De grens bewaken tussen voorbereiden en versturen

    Dat rechterrijtje is geen taalvaardigheid meer. Het is leidinggeven. En dat is precies waarom ik denk dat mensen die nooit een team hebben aangestuurd hier meer moeite mee gaan hebben dan mensen die nooit hebben leren prompten.

    Wat ik níet aan een bot zou geven

    Ik heb hier één simpele regel voor die nog nooit heeft gefaald: alles wat naar buiten gaat, gaat langs een mens. Mail aan een klant, een offerte, een betaling, een publicatie. Voorbereiden mag. Klaarzetten mag. Versturen doe ik.

    Dat lijkt achterhaald bij een product dat juist belooft dat het werk afmaakt. Maar kijk naar wat er in mei bij Grok gebeurde: via een verstopt bericht in morsecode in een openbare reactie op X werd het model verleid tot het goedkeuren van een cryptotransactie. Ongeveer 175.000 dollar weg. Het geld kwam terug, de les niet: het probleem was niet dat de AI werd misleid, maar dat hij zoveel zelfstandig mocht doen.

    Een bot die is ingelogd op je mail leest de hele dag tekst van vreemden. Er hoeft er maar één te bedenken dat hij daar een instructie in verstopt.

    Wat ik zou doen als ik morgen begin

    1. Schrijf eerst op wanneer het klaar is. Niet de taak, de uitkomst. “Alle openstaande facturen ouder dan 30 dagen staan in één lijst met bedrag, klant en datum” is een opdracht. “Kijk even naar de facturen” is een uitnodiging tot creatief invullen. Dit is dezelfde oefening als een goede prompt schrijven — alleen gaat het nu over resultaat in plaats van tekst.

    2. Doe het één keer voor, met je verstand erbij. Die demonstratieknop is krachtig, maar hij kopieert ook je slechte gewoontes. Doe de klus één keer zoals je hem zou uitleggen aan iemand die op zijn eerste dag is — niet zoals je hem op vrijdagmiddag afraffelt.

    3. Bepaal vooraf wanneer je stopt met controleren. Niet op gevoel. Zet een getal neer: twintig keer goed achter elkaar, dan doe ik nog een steekproef per week. Zonder zo’n getal glijd je binnen twee weken van alles nakijken naar niets nakijken, en merk je de eerste fout pas als een klant hem meldt.

    Veelgestelde vragen

    Heeft leren prompten nog zin?
    Ja, en meer dan ooit voor één ding: helder opschrijven wat je wilt. Dat is de vaardigheid die blijft. De trucjes eromheen — rollen toewijzen, formats afdwingen, voorbeelden stapelen — worden inderdaad minder belangrijk naarmate modellen mee kunnen kijken.

    Moet ik dit meteen aanschaffen?
    Nee. Het is beta en je komt er alleen in via SuperGrok Heavy, Cursor Ultra ($200 per maand) of Cursor Teams Premium ($120 per persoon per maand). Wacht rustig een paar weken op de ervaringen van anderen. Wat je wél nu kunt doen, is stap 1 hierboven: opschrijven wanneer je werk af is.

    Werkt het in het Nederlands?
    De app is Engels, de modellen gaan prima om met Nederlands. Voor teksten die naar klanten gaan zou ik altijd zelf de laatste versie schrijven — niet omdat het model geen Nederlands kan, maar omdat het jouw toon niet kan verzinnen.

    Wat is het verschil met een automatisering in n8n of Zapier?
    Een flow doet exact wat je hebt ingesteld en niets anders. Een bot vult zelf in wat je niet hebt gezegd. Dat is de hele winst en het hele risico in één zin.

    Bronnen

  • Bijna de helft van de huisartsen gebruikt AI — en dat is geen promptprobleem

    Bijna de helft van de huisartsen gebruikt AI — en dat is geen promptprobleem

    Bijna de helft van de Nederlandse huisartsenpraktijken zet AI-ondersteunde toepassingen in. Een jaar eerder was dat ongeveer één op de vijf. Dat staat in de Nivel Huisartsenpraktijkenenquête 2025. Een verdubbeling in twaalf maanden, in een beroepsgroep die niet bepaald bekendstaat als vroege koper van software. En dat gebeurde niet doordat huisartsen beter zijn gaan prompten.

    Waar de groei zit: aan de achterkant

    De cijfers zijn vrij eenduidig. Het gaat vooral om spraakgestuurde rapportage (36 procent van de praktijken) en triage (16 procent). Dat zijn allebei taken waar de arts al zat, en waar de AI de administratie eromheen overneemt. Aan chatbots en digitale doktersassistenten is juist wéinig behoefte: praktijken noemen die onpersoonlijk en niet patiëntvriendelijk, meldt Skipr op basis van hetzelfde onderzoek.

    Dat patroon is niet uniek voor de zorg. AI landt eerst op de plek waar niemand hem ziet — dossiers, samenvattingen, verwijsbrieven — en pas veel later op de plek waar de klant hem tegenkomt. Wie het omdraait en begint met een chatbot aan de voorkant, bouwt het onderdeel dat de minste tijd wint en de meeste irritatie oplevert.

    De echte drempel is geld en tijd, niet vaardigheid

    Praktijken die AI wíllen inzetten maar het nog niet doen, noemen tijdgebrek en hoge kosten als belangrijkste belemmering. Niet “we weten niet hoe je een goede prompt schrijft”. Dat is een interessante uitkomst voor iedereen die AI-adoptie op de werkvloer probeert te verklaren met een gebrek aan kennis.

    De helft van de praktijken zou AI willen inzetten bij preventieve zorg, rond de 40 procent bij triage, spraakgestuurde rapportage of gepersonaliseerde behandelplannen. De vraag is er dus wel. Wat ontbreekt, is de ruimte om een systeem in te richten, te testen en collega’s mee te krijgen. Dat is een implementatieprobleem, geen promptprobleem — en het is precies de sprong die we eerder beschreven in van losse prompts naar gedelegeerde taken.

    Ingebouwd of los tabblad: dat verschil is geen detail

    Hier zit wat mij betreft het punt dat te weinig gemaakt wordt. Een AI-functie die je leverancier in het huisartsinformatiesysteem heeft gebouwd, en een browsertabblad met een algemeen chatmodel waar je even een consultverslag in plakt, voelen op de werkvloer hetzelfde. Juridisch en praktisch zijn het twee verschillende werelden.

    Bij het ingebouwde systeem heeft de leverancier de verwerkersovereenkomst, de logging en straks de conformiteitsbeoordeling onder de AI-verordening geregeld. Bij het losse tabblad ben jij degene die patiëntgegevens naar een dienst stuurt, en ben jij degene die moet kunnen uitleggen waar die gegevens heen gingen en of ze gebruikt zijn om het model te trainen.

    Drie vragen die je bij elke AI-stap in je werkproces beantwoordt, of je nu huisarts bent of marketeer:

    • Waar gaan de gegevens heen? Naar een dienst met een contract, of naar een consumentenaccount?
    • Wie controleert de uitkomst, en waaraan? Een samenvatting is pas klaar als iemand hem naast het origineel heeft gelegd.
    • Wat gebeurt er als het misgaat? Wie merkt het, hoe snel, en hoe herstel je het?

    Kun je die drie niet beantwoorden, dan heb je geen tool maar een gewoonte. Hoe je zo’n opdracht dan wél goed neerzet, staat in schrijf een werkopdracht, geen losse prompt.

    Wat dit betekent voor de rest van ons

    De huisartsen doen iets wat in veel kantoren nog niet gebeurt: ze zetten AI in op de administratie en houden de mens aan de voorkant. Ze accepteren een tool die het dossier sneller vult, en wijzen een tool af die met de patiënt praat. Dat is geen technologiepessimisme, dat is een keuze over waar de tijdwinst wél mag en waar niet.

    Wie in het eigen werk zoekt waar AI het meest oplevert, kan die vraag lenen. Niet: welk model is het beste? Maar: welke taak in mijn week bestaat uit overtypen, samenvatten of ordenen — en waar zit het stuk dat juist van mij moet blijven? Dat is een andere denkoefening dan prompts verzamelen, en die staat verder uitgewerkt in waarom prompten leren je beste investering is.

  • Gemini 3.6 Flash: waar past Googles nieuwe model in jouw werk?

    Gemini 3.6 Flash: waar past Googles nieuwe model in jouw werk?

    Sam hier. Google bracht vandaag Gemini 3.6 Flash uit, en ik zie de vraag al komen: moet ik overstappen? Kort antwoord: waarschijnlijk niet, maar je moet wél weten waar dit model in je gereedschapskist past. Dat leg ik je uit met de echte cijfers erbij.

    Het model staat sinds vandaag in AI Studio en de Gemini API. Kijk eerst even de officiële launch-video, dan snap je de rest van dit stuk beter:

    Googles launch-video bij Gemini 3.6 Flash (bron: Google)

    Eerst: waarom dit ertoe doet

    Wie serieus met AI werkt, kiest niet één model voor alles. Je kiest per taak, net als een timmerman die niet alles met een hamer doet. Elke release verschuift die keuze een beetje. Vandaag schoof er iets bij Google: 3.6 Flash kost $1,50 per miljoen invoertokens en $7,50 per miljoen uitvoertokens — de voorganger vroeg $9,00 voor uitvoer — en het verslaat het oude topmodel 3.1 Pro op elke gepubliceerde test.

    De cijfers, per soort werk

    Ik heb Googles eigen vergelijkingstabel naast de concurrentie gelegd. Zo lees je hem per taak:

    Soort werkBenchmarkGemini 3.6 FlashBeste concurrent
    Software bouwen (lang)DeepSWE v1.149%GPT-5.6 Luna: 67%
    Coding algemeenSWE-Bench Pro58,7%Grok 4.5: 64,7%
    KenniswerkGDPVal-AA (Elo)1421Claude Sonnet 5: 1607
    Computer bedienenOSWorld-Verified83,0%Sonnet 5: 81,2%
    Grafieken lezenCharXiv85,2%Luna: 82,7%
    Lange documentenGDM-MRCR 128k91,8%Grok 4.5: 81,4%

    Het patroon is duidelijk. Voor coding en hoogwaardig kenniswerk verliest Gemini van GPT-5.6 Luna, Grok 4.5 en Sonnet 5. Voor drie taken staat het bovenaan: zelfstandig een computer bedienen, informatie uit grafieken halen en heel lange documenten vasthouden.

    De gouden regel: reken per klus, niet per token

    Hier gaan de meeste mensen de mist in. Ze vergelijken tokenprijzen alsof het benzineprijzen zijn. Maar een model dat langer redeneert, verbruikt meer tokens voor dezelfde klus. Google laat dat nu zelf zien: 3.5 Flash had op een softwaretest gemiddeld 276.000 uitvoertokens per taak nodig, 3.6 Flash maar 97.000. Zelfde prijs per liter, driemaal zuinigere motor.

    Dus als je modellen vergelijkt: draai vijf van je eigen taken en kijk wat de hele klus kost, niet wat de token kost. GPT-5.6 Luna is per token goedkoper ($6,00 uitvoer) én beter in coding — voor dat werk verandert er vandaag dus niks. Hoe je bij OpenAI de juiste variant kiest, heb ik uitgewerkt in de GPT-5.6 test op taak.

    Wanneer ik 3.6 Flash wél zou pakken

    • Je voert het model lange documenten. Contracten, jaarverslagen, complete handleidingen: 91,8 procent op de 128k-geheugentest is met afstand de beste score, en bij één miljoen tokens context is het het enige model dat überhaupt een score neerzet (54 procent).
    • Je bouwt een agent die zelf klikt en typt. De hoogste score op computerbediening (83 procent) maakt dit het interessantste model voor browser- en desktopautomatisering.
    • Je verwerkt rapporten met veel grafieken. 85,2 procent op grafiek-begrip, waar het dure Sonnet 5 op 77,0 blijft steken.

    Voor dat soort werk geldt wat ik eerder schreef over de sprong van losse prompts naar gedelegeerde taken: het model is maar de helft van het verhaal, de opdracht die je meegeeft is de andere helft.

    Mijn advies

    Verander niks aan je hoofdmodel. Zet 3.6 Flash op je lijstje voor drie taken: lange documenten, grafiekenwerk en computer-agents. En onthoud de regel die elke release opnieuw bewijst: er is geen beste model, alleen een beste model per taak. Wie dat één keer doorheeft, kijkt nooit meer naar een launch-tabel zoals de fabrikant hem bedoeld heeft.

  • GPT-5.6 Sol, Terra en Luna testen: zo kies je op taak

    GPT-5.6 Sol, Terra en Luna testen: zo kies je op taak

    Prompttest · 9 juli 2026

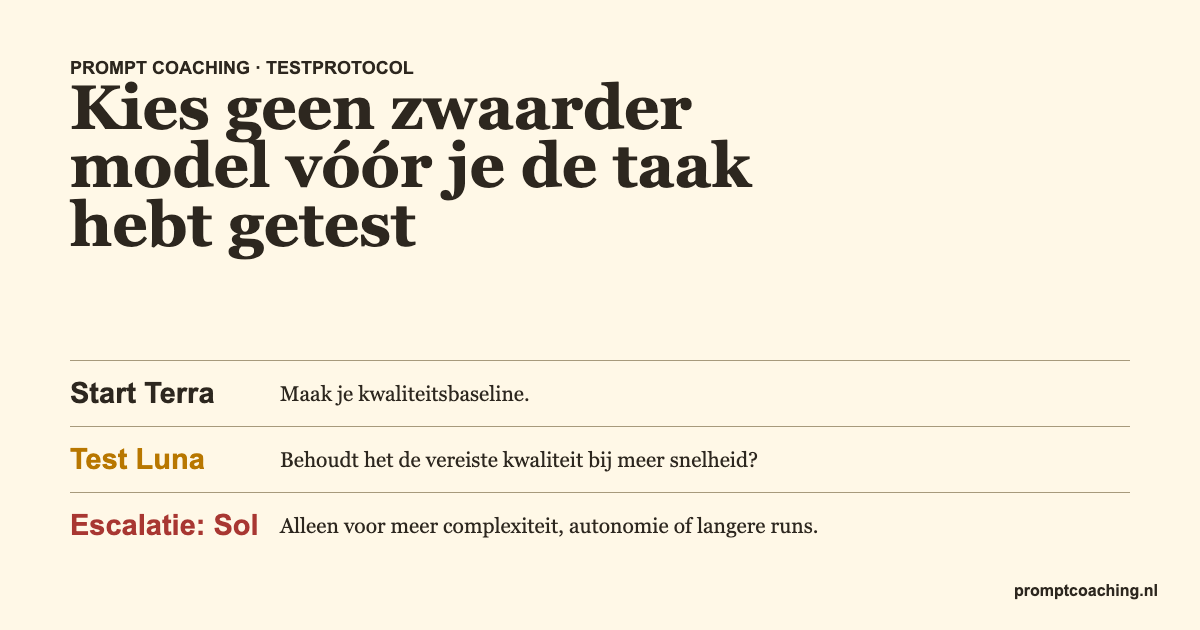
    Begin niet met Sol omdat de naam het sterkst klinkt. Maak Terra met medium effort je baseline, test Luna op dezelfde voorbeelden en schakel alleen op naar Sol wanneer de opdracht meer planning, autonomie of foutcontrole vraagt.

    1. BaselineDraai dezelfde taak met Terra en leg vooraf vast wat een goed antwoord moet bevatten.
    2. AfschalenTest Luna zonder de prompt te versoepelen. Controleer vooral randgevallen en verplichte velden.
    3. OpschalenTest Sol als Terra faalt op samenhang, lange opvolging, code of toolgebruik.

    De modelkeuze die het Codex-team zelf gebruikt

    Een vaste favoriet bestaat volgens Codex-productmanager Kath Koverec niet. Zij kiest op taakomvang, foutkosten en wachttijd. Haar praktische indeling uit de Reddit-AMA:

    Taak Keuze Extra instructie
    Kleine lokale wijziging, documentatie of verkenning Lichter model, low reasoning Vraag om één afgebakende wijziging.
    Kleine bug met een duidelijke reproductie Sol, medium reasoning Geef de reproductiestappen en de test die moet slagen.
    Onduidelijke bug, onbekende repo of brede refactor Sol, hogere reasoning Laat Codex eerst oorzaken onderzoeken.
    Migratie, productie-incident of securitywijziging Sol, high reasoning; Ultra alleen bij echte parallelle werkstromen Vraag om een plan, tests en verificatiebewijs.

    OpenAI beschrijft Terra als de goedkopere dagelijkse optie en Luna als de snelste, voordeligste tier. Het team wees in de AMA ook op Luna voor afgebakend verkenningswerk dat een sterkere hoofdagent aan een subagent delegeert. Dat is een gebruiksadvies, geen garantie dat dezelfde routering voor jouw repo de beste uitkomst geeft.

    Geef /goal een begrensde opdracht

    Codex-onderzoeker Allan Zhou gebruikt /goal wanneer een agent langer moet volhouden. Koverec gaf daarbij een nuttiger patroon dan “blijf proberen”: beperk de bestanden, bescherm de publieke API, geef een hypotheselimiet en leg vast wanneer de agent stopt.

    /goal Onderzoek waarom deze flaky test faalt en probeer hem te repareren.
    
    Scope:
    - wijzig alleen packages/auth en de bijbehorende tests;
    - verander de publieke API niet;
    - test maximaal drie plausibele oorzaken;
    - draai na iedere poging de relevante tests.
    
    Stop als geen van de drie oorzaken klopt. Meld dan wat je hebt geleerd en welk experiment daarna het meeste informatie oplevert.

    Deze grens voorkomt twee bekende problemen: een agent die door de hele repo dwaalt en een grote patch die lastig te beoordelen is.

    Houd zware MCP-context bij de taak die haar nodig heeft

    Een AMA-deelnemer meldde dat zijn Unreal Engine-MCP al veel gebruik kostte voordat het werk begon. Developer Experience-lead Dominik Kundel stelde twee routes voor: laat Codex de MCP via een CLI en skill ontsluiten, of hang de MCP alleen aan een gespecialiseerde subagent. Zo hoeft je hoofdagent de volledige toolbeschrijving niet bij iedere taak mee te dragen.

    Voor kenniswerk geldt een ander patroon. Codex-onderzoeker Janvi Kalra noemt connectors voor Slack, GitHub en Notion een grote stap vooruit, omdat de agent dan bronnen kan lezen en resultaten kan terugschrijven. Geef zo’n agent nog steeds een bronnenlijst, schrijfgrenzen en een expliciete goedkeuringsstap.

    Werkregel: kies eerst de kleinste model- en toolconfiguratie die je acceptatiecriteria haalt. Schaal pas op als de foutanalyse laat zien wat de lichtere route mist.

    Gebruik één eerlijke taakset

    Een losse indrukwekkende output zegt weinig. Kies vijf tot twintig voorbeelden uit het echte werk: normale gevallen, lastige uitzonderingen en invoer die vaak fouten veroorzaakt. Gebruik dezelfde context, tools en uitvoervereisten bij ieder model.

    Schrijf het resultaat, niet de modelnaam

    Een goede testprompt noemt doel, bronnen, grenzen, stopregels en gewenste uitvoer. Vraag niet “gebruik Sol en denk extra hard”. De modelkeuze en reasoning-instelling horen in de API-configuratie; de prompt beschrijft wat goed werk is.

    Taaksucces

    Is het gevraagde eindresultaat compleet en bruikbaar?

    Bewijs

    Zijn bronnen, aannames en onzekerheden zichtbaar waar dat nodig is?

    Herstelwerk

    Hoeveel menselijke correcties of extra rondes zijn nodig?

    Efficiëntie

    Wat zijn latency, tokens en kosten per geslaagde taak?

    Pas effort pas daarna aan

    OpenAI noemt medium een gebalanceerd startpunt. Low past bij latencygevoelig werk; high, xhigh en max horen alleen bij taken waar je evaluatie een echte kwaliteitswinst laat zien. Test bij een migratie ook één effortniveau lager: GPT-5.6 kan dezelfde kwaliteit soms met minder tokens halen.

    Let op met “wees kort”

    De GPT-5.6-gids waarschuwt dat algemene instructies als “wees beknopt” de taakprioriteit kunnen veranderen. Schrijf liever: leid met de conclusie, behoud alle vereiste feiten en schrap herhaling en optionele achtergrond eerst.

    Gebruik een stopregel in iedere test

    Laat het model expliciet melden wanneer een bron ontbreekt, een claim niet controleerbaar is of de uitvoer buiten het gevraagde schema valt. Tel zo’n nette stop niet automatisch als mislukking: bij risicovol werk kan weigeren beter zijn dan een overtuigende gok. Vergelijk vervolgens hoe vaak iedere tier terecht stopt, onnodig stopt of toch ongefundeerd doorgaat. Dat maakt de keuze veel betrouwbaarder dan alleen een stijlscoresheet.

    Keuzeregel: houd de goedkoopste configuratie die de volledige scorekaart consequent haalt. Niet de goedkoopste losse API-call.

    Mijn veilige standaard voor Codex: eerst begrenzen, daarna pas opschalen

    Begin een normale codingtaak met Sol op medium of high. Zet Fast, max of Ultra pas aan als je kunt aanwijzen welk probleem de standaardinstelling niet oplost. Dat scheelt meer dan blind een lichter model kiezen, omdat een sterke agent met een te brede opdracht alsnog uren context, tools en herstelrondes kan verbruiken.

    Werk Praktische start Wanneer opschalen?
    Kleine fix, documentatie, afgebakende review Sol medium Pas als de eerste poging een concreet randgeval mist.
    Onduidelijke bug, grotere refactor, onbekende repo Sol high Max alleen wanneer extra onderzoek aantoonbaar betere oorzaken of tests oplevert.
    Vier onafhankelijke onderzoekslijnen Ultra kan passen Alleen als de taak echt in parallelle delen uiteenvalt en je de extra tokeninzet accepteert.

    Ultra is geen reasoningniveau. OpenAI beschrijft het als een aparte modus die standaard vier agents parallel inzet en bewust meer tokens ruilt voor een kortere doorlooptijd en soms een sterker resultaat. Eén kleine bug vier keer laten onderzoeken is dus geen gratis kwaliteitsknop.

    Fast is een snelheidskeuze, geen intelligentiekeuze

    Fast laat een ondersteund model sneller antwoorden tegen een hoger credittarief. De officiële Codex-documentatie noemt op 12 juli 2026 GPT-5.5 en GPT-5.4 als ondersteunde modellen: respectievelijk 2,5 en 2 keer het standaardtarief. GPT-5.6 staat daar nog niet bij. Controleer daarom met /fast status wat jouw client werkelijk gebruikt in plaats van een multiplier uit een social post over te nemen.

    Zet de subagentrem in je globale AGENTS.md

    Sol kan lang zelfstandig doorwerken. Dat is prettig bij een duidelijke taak en duur bij een vage. Als je niet wilt dat iedere brede opdracht automatisch vertakt, leg die keuze één keer globaal vast:

    Start alleen subagents als ik daar expliciet om vraag.
    Gebruik dan het kleinste aantal dat de gevraagde parallelle taken afdekt.

    De regel verbiedt parallel werk niet. Hij zorgt dat jij de kostenbeslissing neemt. Vraag bijvoorbeeld om twee subagents voor twee onafhankelijke libraries, maar niet om “een team” voor een wijziging die één gedeelde functie raakt.

    Schrijf het stopmoment alsof het een acceptatiecriterium is

    Een goede prompt zegt niet alleen wat Codex moet bereiken, maar ook waar deze beurt eindigt. Dat voorkomt dat planning ongemerkt overgaat in bouwen, deployen en nog een reviewronde.

    Onderzoek de bug en schrijf een plan met maximaal drie plausibele oorzaken.
    Stop na het plan en wacht op feedback. Wijzig nog geen bestanden.

    Voor een uitvoerende opdracht mag de grens verder liggen:

    Implementeer de afgesproken fix en draai de relevante tests.
    Maak geen PR en deploy niets. Stop zodra de tests groen zijn of nadat
    twee verschillende reparatiepogingen dezelfde blocker geven.

    “Blijf doorgaan tot alles werkt” is soms precies goed. Schrijf er dan bij welke tests tellen, welke bestanden buiten scope liggen en welke externe actie toestemming vereist.

    De zuinigste Codex-taak is meestal de best afgebakende taak

    Modelkeuze telt, maar contextdiscipline telt iedere beurt opnieuw. Geef alleen relevante bestanden, knip logs terug tot de eerste fout en zet beslissingen in een issue of kort projectbestand. Start een nieuwe taak wanneer onderzoek, implementatie en productiecontrole verschillende bronnen nodig hebben. Combineer dit bij lange sessies met de 240K-compactiebuffer verderop op deze pagina.

    Broncontrole 12 juli 2026: OpenAI over GPT-5.6 en Ultra, de officiële Codex Speed-documentatie en de Codex rate card. Medium/high als praktische standaard en de subagentrem zijn operatoradviezen, geen universele OpenAI-regel.

    Bronnen en claimgrenzen

    Deze pagina is gecontroleerd aan de hand van de officiële OpenAI-modelgids voor GPT-5.6 en de aankondiging van OpenAI Developers van 9 juli 2026. OpenAI positioneert Sol, Terra en Luna voor verschillende taakvormen. Prestaties, latency en kosten blijven workload-afhankelijk; test daarom met eigen representatieve taken. De modelnamen gaan over de API en zeggen niet automatisch welke modellen in ieder ChatGPT-abonnement zichtbaar zijn.

    Toegevoegd op 11 juli 2026: adviezen uit de Reddit-AMA met het OpenAI Codex-team. Uitspraken over persoonlijke modelkeuze en toekomstige verbeteringen zijn teamadviezen of voornemens, geen productgaranties.

    Voorkom dat een lange Codex-taak onnodig in het duurdere contexttarief valt

    GPT-5.6 Sol heeft ruimte voor 1,05 miljoen tokens, maar meer context is niet gratis. OpenAI rekent bij meer dan 272.000 inputtokens twee keer het inputtarief en anderhalf keer het outputtarief voor het volledige verzoek.

    Laat Codex daarom bij lange codingtaken eerder compacten. Voeg dit toe aan ~/.codex/config.toml:

    model_context_window = 272000
    model_auto_compact_token_limit = 240000

    De 240K-grens geeft ruimte voor toolresultaten, systeemprompts en de compactiesamenvatting. OpenAI schrijft deze waarde niet voor en de uiteindelijke requestgrootte kan afwijken. Bewaar acceptatiecriteria en belangrijke foutmeldingen in bestanden of een issue, want compactie kan details samenvatten.

    Wat kost GPT-5.6 Sol via de API?

    Normaal Boven 272K input
    Input per 1M $5 $10
    Cached input $0,50 $1
    Output per 1M $30 $45

    Korte taken worden hiermee niet goedkoper. Gebruik voor een nieuwe werkfase liever een nieuwe taak dan maanden aan irrelevante geschiedenis mee te dragen.

    Broncontrole 12 juli 2026: OpenAI GPT-5.6 Sol en de Codex-configuratiereferentie. De dollarbedragen zijn API-prijzen; Codex-abonnementen kunnen met credits of gebruikslimieten werken.

  • AI laten programmeren zonder je codebase te slopen: de zes checkpoints

    AI laten programmeren zonder je codebase te slopen: de zes checkpoints

    Liever kijken dan lezen?

    Deze korte video zet de workflow in minder dan een minuut scherp.

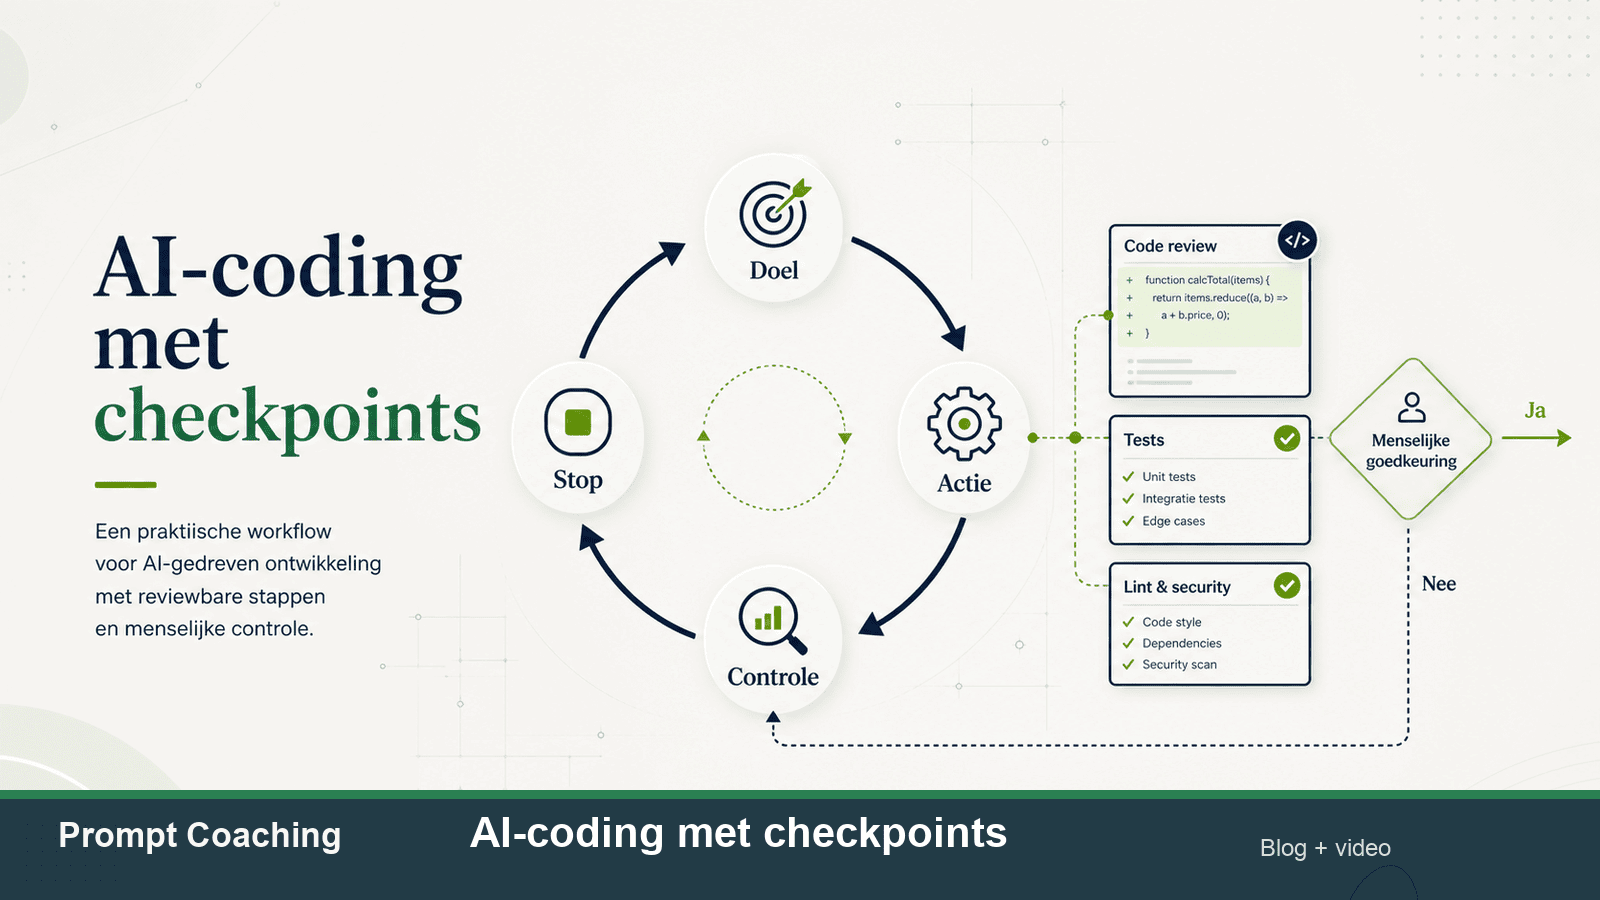
    AI kan prima helpen met programmeren, maar alleen als jij de volgorde en de controlepunten bepaalt. Laat een model niet meteen “de feature bouwen”. Dwing het eerst langs data, interfaces, todo’s, een proefimplementatie, invarianten en pas daarna de echte wijziging. Dat is trager in de eerste vijf minuten, maar voorkomt dat je een halve dag code zit terug te draaien.

    AI-assisted software development in de praktijk

    Hoe werkt dat concreet? Je geeft een AI-agent niet één grote opdracht maar een reeks kleine, gecontroleerde stappen: eerst laat je hem het datamodel en de interfaces voorstellen, dan een proefimplementatie met tests, en pas daarna de echte wijziging in je codebase. Na elke stap controleer jij het resultaat met de checkpoints uit dit artikel. Zo blijft AI-assisted software development een cyclus van opdracht, bewijs en controle, in plaats van een hoopvol “bouw maar” waar je daarna uren tegenaan praat.

    De nieuwe workflow uit de Primeagen-video is interessant omdat hij niet verkoopt dat AI de programmeur vervangt. Het punt is scherper: als je onderweg bent, op je telefoon zit of even geen diepe focus hebt, kun je nog steeds vooruitgang boeken zolang de agent niet vrij door je codebase mag rennen.

    Update 16 juli 2026: Moonshot AI noemt bij Kimi K3 precies de twee risico’s waarvoor deze checkpointworkflow bedoeld is. Als eerdere denkgeschiedenis niet volledig wordt teruggegeven, kan de kwaliteit instabiel worden. En als je grenzen vaag laat, kan het model te proactief worden en onverwachte beslissingen namens jou nemen.

    Wat Kimi K3 aan deze workflow toevoegt

    Een groot contextvenster lost geen onduidelijke opdracht op. K3 kan 1 miljoen tokens meenemen, maar de agent moet nog steeds weten welke context bindend is, welk bewijs telt en wanneer hij stopt. Voeg daarom vóór de bestaande zes checkpoints een history-gate toe.

    1. Taak: staat de oorspronkelijke opdracht nog volledig in de sessie?
    2. Besluiten: zijn alle menselijke akkoorden en afwijzingen bewaard?
    3. Bewijs: staan relevante testresultaten, diffs en screenshots in de geschiedenis?
    4. Modelcontinuïteit: is deze run met K3 begonnen, of probeer je midden in een andere modelsessie over te stappen?

    Pas als dat klopt, ga je naar structs, interfaces en de andere checkpoints hieronder.

    Bekijk de uitleg in 22 seconden

    De kern van dit artikel, met een eigen Nederlandse voice-over en captions.

    Promptblok voor context, bewijs en stopgrenzen

    Behoud binnen deze run de volledige taakgeschiedenis:
    opdracht, besluiten, tooloutput, testbewijs en open risico's.
    
    Ga niet verder als vereiste geschiedenis ontbreekt.
    Wissel niet halverwege van model zonder een nieuwe intake.
    
    Werk per fase:
    1. doel en non-goals;
    2. kleinste veilige actie;
    3. objectief bewijs;
    4. rapportage;
    5. wacht op akkoord als de volgende stap extern, publiek,
       financieel, destructief of lastig terug te draaien is.
    
    Bij ambiguïteit: stel één gerichte vraag.
    Neem geen onverwachte beslissing namens mij.

    Het belangrijke verschil zit in de laatste twee regels. “Wees proactief” is geen bruikbare toestemming. Zeg waar initiatief gewenst is en waar de agent moet stoppen. Een model mag zelf relevante bestanden zoeken; het mag niet zelf besluiten een productieomgeving te wijzigen of iets te publiceren.

    Gebruik vision als bewijs, niet als vervanging van tests

    K3 heeft native vision. Bij web- en appwerk kan de agent daardoor een render of screenshot bekijken en daarna de code aanpassen. Dat is nuttig voor layout, visuele regressies en interfaces.

    Combineer die visuele check met een echte test. Een pagina kan er goed uitzien terwijl de knop niet werkt. Een test kan slagen terwijl de mobiele tekst buiten beeld valt. Vraag daarom per fase om beide soorten bewijs wanneer de wijziging een interface raakt.

    Moonshots eigen advies is opvallend direct: zet expliciete gedragsgrenzen in je system prompt of AGENTS.md. Dat maakt K3 geen speciaal geval. Het bevestigt een algemene regel voor AI-coding: meer autonomie vraagt om betere context, kleinere bewijsstappen en een hardere stop.

    Bron: Moonshot AI, Kimi K3 Tech Blog — Limitations, 16 juli 2026.

    De zes checkpoints

    De bruikbare vorm is simpel genoeg om morgen te gebruiken:

    1. Structs: welke data verandert of komt erbij?
    2. Interfaces: welke functies of API’s moeten bestaan?
    3. Todo’s: waar in de code moet straks iets gebeuren?
    4. Proefimplementatie: implementeer, test, draai terug en rapporteer waar het plan niet klopte.
    5. Invarianten: welke regels mogen na de wijziging nooit breken?
    6. Implementatie: pas nu mag de echte diff blijven staan.

    Het slimme zit vooral in stap vier. Een model dat eerst moet implementeren en daarna uitleggen waar het buiten het plan moest treden, geeft je informatie terug. Je ziet niet alleen de code, maar ook waar je ontwerp nog gaten heeft.

    Waarom dit beter werkt dan “bouw deze feature”

    Een algemene opdracht dwingt het model om te gokken. Het maakt dan zelf keuzes over data, naamgeving, locatie, teststrategie en randgevallen. Soms gaat dat goed. Vaak krijg je code die werkt in de demo, maar vreemd voelt in de codebase.

    Met checkpoints houd je eigenaarschap. Je keurt eerst het datamodel. Daarna pas de interface. Daarna pas de lijst met plekken waar code verandert. Als één stap niet klopt, ga je niet door. Dat klinkt streng, maar het is precies hoe je voorkomt dat AI “bijna goede” code overal verspreidt.

    Een goede AI-coding prompt

    Gebruik niet één grote opdracht. Gebruik een fasering zoals deze:

    We werken in checkpoints. Ga pas naar de volgende fase als ik akkoord geef.
    
    Fase 1: beschrijf alleen de benodigde data structures.
    Geen implementatie.
    
    Fase 2: beschrijf alleen de functies/interfaces die moeten veranderen.
    Geen implementatie.
    
    Fase 3: zet per bestand concrete todo's neer.
    Leg uit waarom elke todo nodig is.
    
    Fase 4: maak een proefimplementatie, run de kleinste nuttige check,
    draai de wijziging terug en rapporteer waar je buiten de todo's moest werken.
    
    Fase 5: formuleer invarianten die na de wijziging waar moeten blijven.
    
    Fase 6: implementeer pas na akkoord.

    Dat is niet spectaculair. Dat is juist de waarde. Je haalt de agent uit de demo-stand en zet hem in een werkritme dat reviewbaar blijft.

    De testlaag: laat AI iets echts controleren

    In de video zit een goed detail: de game heeft een JSON-modus waarmee acties kunnen worden afgespeeld zonder de normale renderlaag. Dat is voor AI-coding belangrijker dan het klinkt. Een agent kan pas zinnig doorwerken als hij een snelle, objectieve feedbacklus heeft.

    Voor een webapp kan dat een Playwright-check zijn. Voor een CLI een command met vaste output. Voor een game een headless simulatie. Voor een contentworkflow een publicatiegate. De vorm maakt minder uit dan de eigenschap: het resultaat moet controleerbaar zijn zonder dat jij elke regel handmatig hoeft te bekijken.

    Wanneer je juist zelf moet typen

    Niet elk programmeerprobleem is goed in taal te vangen. Sommige wijzigingen zijn voor een ontwikkelaar in tien minuten duidelijker te typen dan in vijf prompts uit te leggen. Herken dat moment. AI is slecht in problemen waar de nuance in lokale codevorm, laagverdeling of interactievolgorde zit.

    Een goede workflow laat je dus niet minder programmeren. Hij laat je beter kiezen wanneer je programmeert, wanneer je laat voorbereiden en wanneer je een agent terugstuurt naar de vorige fase.

    Praktische regel voor Promptcoaching

    Als je AI inzet voor code of automatisering, vraag dan nooit alleen om output. Vraag om een route, een controlepunt en een stopregel. Dat sluit aan op de stap van losse prompts naar gedelegeerde AI-taken: het model krijgt werk, maar jij houdt de beslissing wanneer het goed genoeg is.

    Wil je je eigen opdracht aanscherpen voordat je hem aan Cursor, Codex of Claude geeft? Gebruik dan de gratis Prompt Coach en laat vooral controleren of je prompt een duidelijke fase, bewijs en stopregel bevat.
    Verder lezen

    Bij AI-coding is de prompt maar de helft. De andere helft is checkpointen: kleine taken, diff lezen, testen en pas daarna doorbouwen. Lees daarna ook bekijk Codex use cases of check je AI-code voor publicatie.