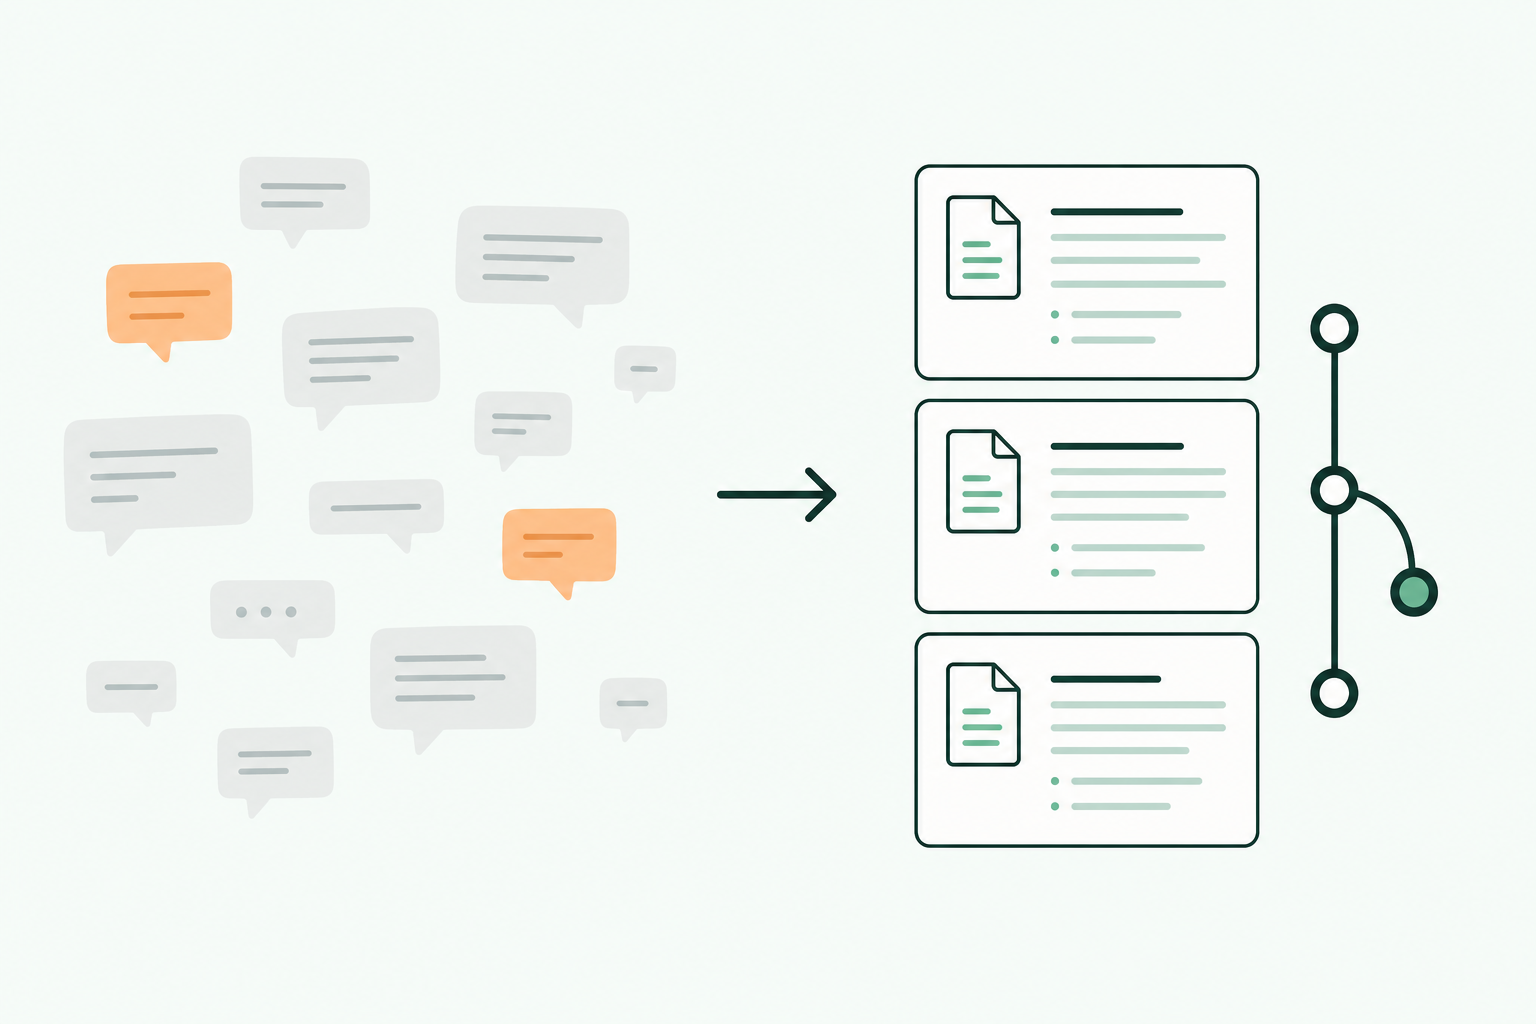
De eenheid van AI-werk verschuift van een los bericht naar een gedelegeerde taak — en daarmee verandert wat je moet kunnen.
OpenAI’s data: in mei 2026 gaf 70,2% van de gebruikers een opdracht van 1+ uur mensenwerk; binnen OpenAI loopt 99,8% van de output via de agent.
Goede prompt coaching gaat nu over afbakenen, context geven en beoordelen — niet over slimme zinnetjes.
Het goede nieuws: dit is een vaardigheid die je kunt leren, los van techniek.
Toen ik begon met mensen te helpen beter met AI te werken, ging het bijna altijd over de prompt: hoe formuleer je je vraag zo dat je een bruikbaar antwoord krijgt? Die vaardigheid blijft nuttig, maar het zwaartepunt verschuift. OpenAI’s onderzoek van 25 juni 2026 laat zien waarheen: van losse vragen naar gedelegeerde taken. En dat verandert wat goede prompt coaching eigenlijk is.
Agent loops: de simpele vorm
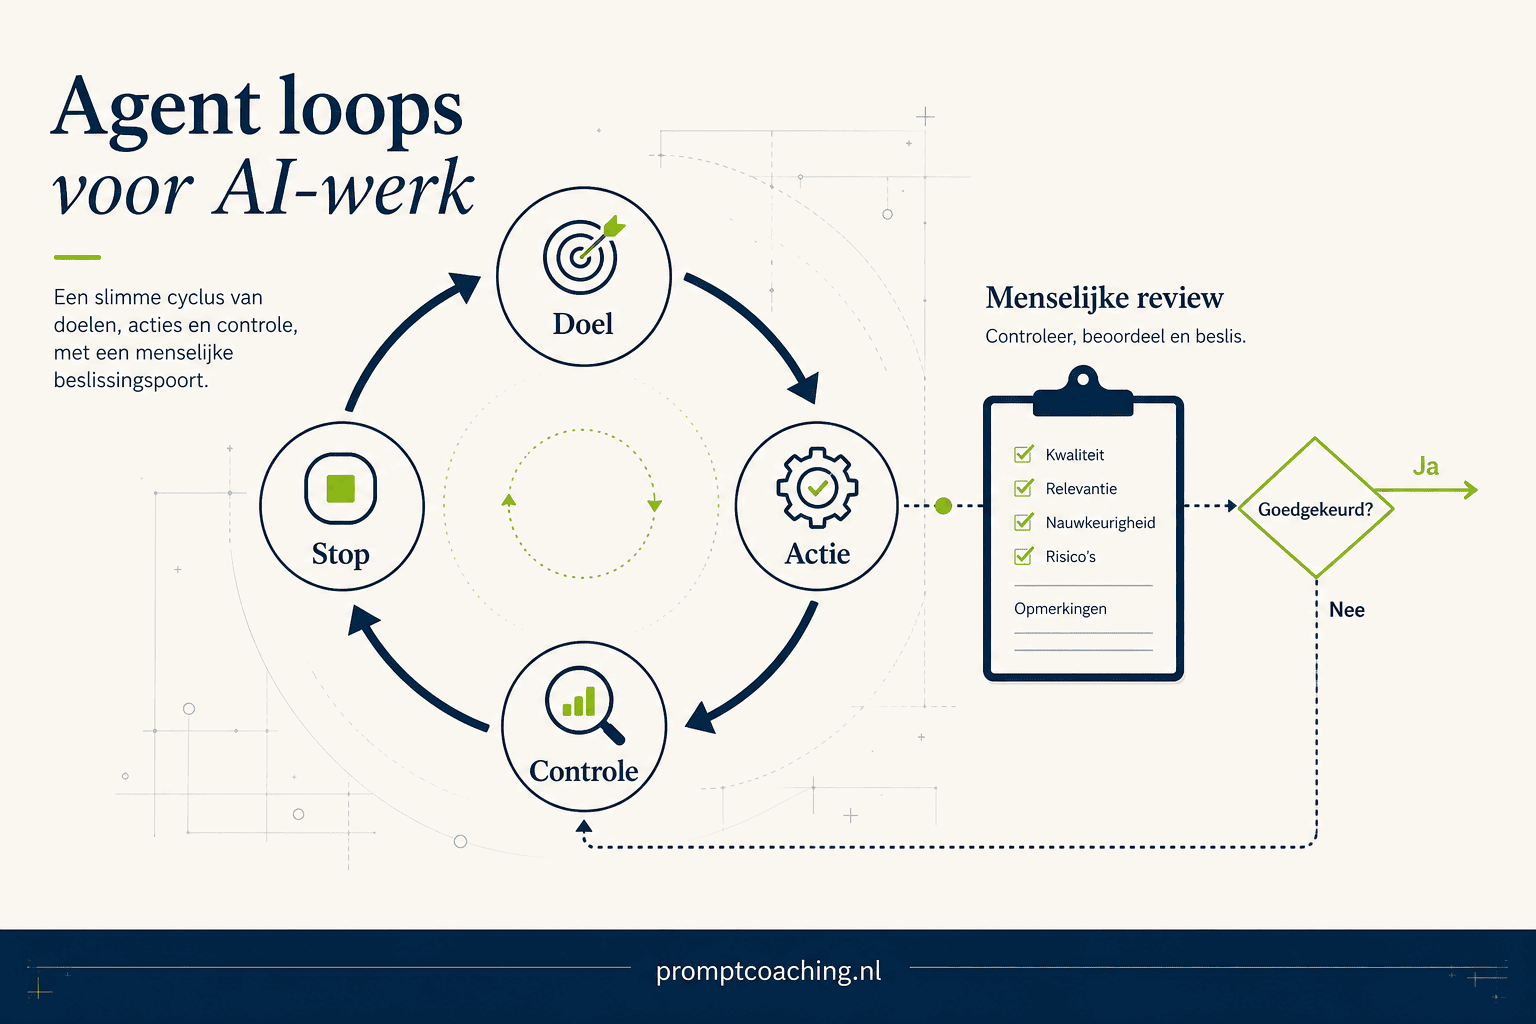
Een agent loop is een taak die zichzelf herhaalt totdat een controle zegt: doorgaan, aanpassen, stoppen of naar een mens. Zonder controle is het geen loop, maar een agent die druk bezig lijkt. Dat is precies waarom de uitleg van Nate Herk goed landt: de kern is niet “autonome AI”, maar een herhaalbare cyclus met een duidelijke uitkomst.
De simpele versie is: doel, actie, controle, stop. Als een van die vier ontbreekt, krijg je output die op werk lijkt maar lastig te vertrouwen is.
Een goede agent loop heeft altijd een controlepunt en een stopregel.
De fout: een vaag doel als stopregel gebruiken
“Maak dit beter” is geen loop-opdracht. De agent kan dan eindeloos herschrijven, extra bronnen erbij halen of details toevoegen die niemand nodig heeft. Je krijgt meer tekst, niet per se meer kwaliteit.
Een betere opdracht klinkt saaier, maar werkt beter:
Doel: maak van deze transcriptie een publiceerbare blogupdate.
Actie: haal claims, voorbeelden, hook en bruikbare lessen uit de video.
Controle: check cannibalisatie, bronkwaliteit, interne links en anti-slop.
Stop: publiceer alleen als de pagina een echte lezersvraag oplost.
Slecht versus bruikbaar
Vage loop
Bruikbare loop
Schrijf betere content tot het goed is.
Schrijf een concept, controleer tegen de publicatiegate en stop bij twijfel.
Zoek extra bronnen.
Zoek maximaal vijf bronnen en noteer welke claim door welke bron wordt gedragen.
Verbeter SEO.
Controleer owner, intent, interne links, titel en de eerste screen.
Ga door tot je klaar bent.
Stop na één verbetercyclus of als bewijs ontbreekt.
Wanneer gebruik je een agent loop?
Gebruik loops voor terugkerend werk waar controle net zo belangrijk is als productie: contentrefreshes, technische QA, researchdossiers, interne-linkchecks, codefixes met tests. Gebruik geen loop voor een losse vraag waarbij een goed antwoord voldoende is. Dan maak je het werk onnodig zwaar.
Bronvideo: Nate Herk over agent loops. De sterkste les is nuchter: begin niet met “laat de agent autonoom werken”, maar met “hoe weet de agent dat hij moet stoppen?”
Liever luisteren?
Hieronder staat een korte voice-over voor lezers die de uitleg liever beluisteren dan de hele tekst scannen.
Korte voice-over: agent loops zonder hype uitgelegd.
De eenheid van werk is verschoven
Een chatbot werkt per bericht: jij vraagt, het model antwoordt, jij stuurt bij. Een agent werkt per taak: je geeft een doel en het systeem werkt daar minuten tot uren zelfstandig naartoe. Het verschil in de cijfers is groot.
80,6%
gaf een taak van 30+ min werk
70,2%
gaf een taak van 1+ uur
25,6%
gaf een taak van 8+ uur
99,8%
van OpenAI’s output via de agent
Dat betekent dat “de perfecte prompt” niet langer het eindpunt is. Een taak van een uur kun je niet vangen in één slimme zin. Je moet het werk afbakenen, de juiste context meegeven, een aanpak schetsen, en — cruciaal — het resultaat kunnen beoordelen. Dat lijkt veel meer op een opdracht aan een freelancer dan op een zoekopdracht.
Wat je nu zou moeten leren
Drie vaardigheden worden belangrijker dan promptformulering. Afbakenen: wat is precies klaar, en wat valt erbuiten? Context geven: welke voorbeelden, bronnen en grenzen heeft de agent nodig om het zonder jou te kunnen? Beoordelen: hoe controleer je in vijf minuten of een uur werk klopt? Die laatste wordt het belangrijkst: een agent die uren zelfstandig werkt, kan ook uren de verkeerde kant op werken.
Merk op dat dit géén technische vaardigheden zijn. Het zijn dezelfde dingen die een goede teamlead doet als hij werk uitbesteedt. Dat sluit aan bij wat het onderzoek het sterkst laat zien: niet-developers groeien het hardst. Je hebt geen programmeerachtergrond nodig om hier goed in te worden — je hebt oordeel nodig en oefening.
Oefenen met delegeren hoeft niet abstract. Kies een taak met een duidelijk eindresultaat — videogeneratie is er zo een — en kijk hoe anderen hun opdrachten formuleren. De Veo 3 prompt voorbeelden laten goed zien hoeveel context en grenzen een bruikbare opdracht bevat.
Hoe ik dit in coaching aanpak
In plaats van “laten we je prompts aanscherpen” werk ik nu vaker aan één echte taak van je eigen werk: we bakenen hem samen af, geven de agent de juiste context, laten hem lopen, en we leren vooral van het beoordelen en corrigeren. Wie van een ander gereedschap komt, herkent dit als overdracht: niet de tool, maar je manier van werken verhuist mee. Daarover schreef ik in van een ander AI-werktuig migreren. En hoe teams hun eigen werkwijze rond agents inrichten, las ik terug in hoe teams hun workflow rond agents inrichten.
De sprong die telt is niet van een goede prompt naar een betere prompt. Het is van vrágen naar delégeren. De cijfers van deze week laten zien dat de mensen die die sprong maken, AI op een heel ander niveau inzetten — en dat het een vaardigheid is, geen talent.
Cijfers uit OpenAI’s onderzoekspaper The shift to agentic AI: evidence from Codex (25 juni 2026). Bron: openai.com — How agents are transforming work. De tijdsschattingen zijn door OpenAI model-geschat en richtinggevend, niet exact.
Verder lezen
Prompt engineering wordt pas nuttig als je de fout kunt aanwijzen: ontbrekende context, verkeerde rol, geen voorbeeld of geen controle op het antwoord. Lees daarna ook bekijk de AI-prompt hub of gebruik de Prompt Coach.
TL;DR In een lang bericht op X legde Microsoft-CEO Satya Nadella uit waarom de huidige AI-transitie fundamenteel anders is dan eerdere platformverschuivingen. Bedrijven (en professionals) moeten niet alleen menselijk kapitaal beheren, maar ook “token capital”: de AI-capaciteit die je zelf bouwt en bezit. Voor iedereen die prompts, agents en AI-tools professioneel gebruikt, betekent dit een verschuiving. Betere prompts en slimmere modelkeuzes zijn nuttig, maar op den duur onvoldoende. De echte voorsprong komt van het systematisch vastleggen van je eigen expertise, oordelen en resultaten in systemen die blijven verbeteren — een leerlus die alleen van jou is.
De aanleiding
Op 14 juni 2026 deelde Satya Nadella een uitgebreide reflectie op de toekomst van organisaties in een door AI gedreven economie. Het bericht is opvallend strategisch en waarschuwend van toon.
Hij beschrijft dat eerdere digitale transities vooral gingen over het versterken van menselijk kapitaal met tools. Deze transitie creëert een directe “cognitive loop” tussen mensen en digitale systemen. Dat verandert hoe kennis wordt vastgelegd, hoe organisaties leren en hoe waarde wordt verdeeld.
Het centrale nieuwe begrip: human capital (kennis, oordeel, relaties, patroonherkenning van mensen) én token capital (de AI-capaciteit die een organisatie of individu zelf bouwt en bezit). Mensen blijven de richting aangeven; zonder menselijke sturing draaien de systemen in het rond. Maar de organisaties die hun menselijke expertise omzetten in verbeterende AI-systemen, bouwen een compounding voordeel op.
Het risico dat hij noemt is scherp: als alle waarde naar een klein aantal frontier-modellen vloeit terwijl de rest van de economie haar kennis laat commoditiseren, ontstaat een situatie zonder maatschappelijk draagvlak — vergelijkbaar met de uitholling die globalisering en outsourcing in sommige sectoren veroorzaakten.
Het grotere verhaal: prompts zijn geen strategie
Voor mensen die professioneel met AI werken — of dat nu als coach, consultant, power user, teamlead of ondernemer is — voelt dit als een bevestiging van iets wat al langer in de lucht hangt.
De eerste golf van AI-adoptie ging over toegang en prompting. Iedereen leerde hoe je betere instructies geeft, chain-of-thought toepast, few-shot voorbeelden gebruikt, rollen definieert en modellen vergelijkt. Dat leverde echte productiviteitswinsten op.
De tweede golf ging over agents en workflows: in plaats van een eenmalige vraag, bouw je multi-step systemen die tools aanroepen, context ophalen en acties uitvoeren.
Wat Nadella nu benadrukt, is de derde laag: de leerlus eromheen. Niet alleen wat je een model vraagt, maar wat je terugkrijgt, hoe je dat beoordeelt, hoe je je eigen correcties en domeinspecifieke kennis vastlegt, en hoe je dat alles gebruikt om het systeem de volgende keer beter te maken — specifiek voor jouw werk, jouw klanten, jouw domein.
Een betere prompt is een tactische verbetering. Een eigen leerlus is een strategisch asset.
Je kunt een taak of zelfs een hele job “offloaden” naar AI, maar je kunt je leren nooit offloaden. Dat is de kernzin uit het bericht. Wie alleen consumeert wat generieke modellen produceren, bouwt geen eigen vermogen op. Wie zijn eigen oordelen, correcties, klantcontext en resultaten structureel terugvoert in zijn systemen, bouwt iets op dat compoundeert.
Van losse prompts naar een “hill climbing machine” voor je eigen expertise
Nadella noemt het beeld van een “hill climbing machine” die elke verbeterde workflow omzet in beter trainingssignaal, wat leidt tot snellere opbouw van unieke, taciete kennis.
Voor professionals en coaches die met AI werken, ziet dat er in de praktijk ongeveer zo uit:
Je legt niet alleen de prompts vast, maar ook de context die je meegeeft (klantdata, eerdere beslissingen, domeinspecifieke regels, toonvoorkeuren).
Je definieert evaluatiecriteria die écht voor jouw werk tellen (niet alleen “is het grammaticaal correct en klinkt het aardig”, maar “past dit bij de specifieke situatie van deze klant en levert het het gewenste resultaat op?”).
Je registreert systematisch waar het model goed presteert en waar het faalt of hallucineert, en je gebruikt die informatie om instructies, retrieval of agent-logica aan te passen.
Je bouwt een groeiende, eigen kennisbank van “hoe wij dit doen” die je agenten en prompts steeds sterker maakt, onafhankelijk van welk onderliggend model je op dat moment gebruikt.
Dit is precies de “company veteran” expertise die je niet wilt verliezen als je van model wisselt. Het is ook de reden waarom veel serieuze gebruikers al experimenteren met memory, vector stores, custom instructions die evolueren, en feedbackmechanismen in hun tools.
De verschuiving is van “ik ben goed in prompts” naar “ik bouw en bezit een systeem dat mijn expertise elke week beter maakt en dat ik kan meenemen”.
Wat we (nog) niet zeker weten
Hoe toegankelijk deze vorm van “private evals en feedbacklussen” wordt voor individuen en kleine teams versus grote organisaties met eigen engineering resources.
Welke tooling het snelst volwassen wordt voor niet-technische professionals (eenvoudige interfaces voor memory, eval en feedback versus full developer stacks).
Hoe sterk de grote providers hun enterprise-oplossingen (Copilot Studio, custom agents, etc.) positioneren als “jouw leerlus” terwijl ze toch grotendeels op hun infrastructuur en modellen draaien.
Wat de werkelijke kosten en baten zijn voor een solo-professional of klein team om dit serieus op te zetten versus blijven werken met de beste beschikbare consumententools.
Wat dit voor jou betekent als je professioneel met AI werkt
De meeste mensen die nu “promptcoaching” of geavanceerd AI-gebruik doen, helpen anderen om beter te worden in het stellen van vragen en het structureren van interacties. Dat blijft waardevol. Maar de volgende laag is minstens zo belangrijk: helpen (of zelf) de stap maken van losse, herhaalbare prompts naar een systeem dat je eigen expertise compoundeert.
Praktische richtingen die passen bij hoe veel power users en coaches al werken:
1. Behandel je eigen prompts, correcties en klantcases als data. Bouw (of begin klein) een persoonlijke of team-kennisbank waarin je vastlegt wat werkte, wat niet werkte, welke context cruciaal was en welke uitzonderingen je tegenkwam.
2. Definieer private evaluatiecriteria. Maak een set van 10-30 concrete scenario’s uit je eigen praktijk met een duidelijke “goede” uitkomst volgens jouw standaarden. Gebruik die regelmatig om te testen of je prompts, agents of retrieval beter worden.
3. Sluit de feedbacklus expliciet. Wanneer je een output beoordeelt, corrigeert of aanpast, zorg dat die correctie ergens terechtkomt waar je systeem er de volgende keer iets aan heeft — in een memory-laag, een updated instruction set, een retrieval document of een trainingssignaal.
4. Test model-onafhankelijkheid. Kijk of je de kern van je werk (de context, de evaluatiecriteria, de feedback) kunt verplaatsen naar een ander model of een ander platform zonder dat je alles opnieuw moet opbouwen. Dat is een sterke test voor of je écht token capital aan het opbouwen bent.
De boodschap van Nadella is ongemakkelijk maar gezond. De meeste waarde in de AI-economie zal niet zitten in wie op dit moment de beste prompts schrijft of het populairste model gebruikt. Die voorsprong is tijdelijk en makkelijk in te halen.
De blijvende waarde zit bij wie erin slaagt zijn eigen expertise, oordelen en resultaten om te zetten in systemen die blijven leren en die alleen hij of zij echt bezit. Dat geldt voor grote bedrijven, maar net zo goed voor professionals, coaches, consultants en kleine teams.
Prompt engineering was de eerste, noodzakelijke vaardigheid. Het opbouwen en onderhouden van een eigen leerlus is de volgende. Wie daar nu serieus mee begint — hoe klein ook — legt de basis voor een voordeel dat compoundeert in plaats van elke paar maanden opnieuw te moeten bevechten.
Dat is wat Nadella bedoelt met human capital en token capital die elkaar versterken. En dat is de reden waarom “gewoon beter prompten” op den duur niet genoeg is.
Prompt engineering wordt pas nuttig als je de fout kunt aanwijzen: ontbrekende context, verkeerde rol, geen voorbeeld of geen controle op het antwoord. Lees daarna ook bekijk de AI-prompt hub of gebruik de Prompt Coach.
Een goede prompt is geen eindpunt, maar een bouwsteen. Wie scherp en gestructureerd leert prompten, heeft de helft van het werk voor een automatisering al gedaan. Van je schrijfproces tot terugkerende klusjes: de stap van losse prompts naar een herhaalbare AI-workflow is kleiner dan je denkt.
Waarom een scherpe prompt de basis is van elke automatisering
Als je een AI-model elke keer iets anders vraagt, krijg je elke keer iets anders terug. Dat is prima om te brainstormen, maar funest zodra je een taak honderd keer wilt herhalen. Automatiseren betekent dat je een proces zo betrouwbaar maakt dat het zonder jou draait, en dat lukt alleen als je input voorspelbaar is.
Daarom begint automatiseren bij prompt-discipline. Een prompt die expliciet de rol, het doel, het gewenste formaat en de randvoorwaarden benoemt, levert consistente output. Diezelfde discipline die je leert om beter te schrijven met een AI-assistent, vertaalt zich direct naar machineleesbare, herhaalbare instructies.
Je schrijfproces automatiseren: zo pak je het aan
De meeste mensen willen niet “iets met AI”, maar gewoon sneller door hun schrijfwerk: blogs, nieuwsbrieven, productteksten, rapportages. Precies dat werk is de beste kandidaat om te automatiseren, omdat het elke keer dezelfde stappen volgt.
Een schrijfproces bestaat bijna altijd uit dezelfde vijf stappen: onderwerp kiezen, research doen, opzet maken, schrijven, redigeren. Je hoeft ze niet alle vijf tegelijk te automatiseren. Begin bij de stap die jou het meeste tijd kost:
Research: een vaste prompt die bronnen samenvat in een vast format — kernpunten, cijfers en citaten met bron.
Opzet: een prompt die van elk onderwerp dezelfde soort outline maakt, met koppen en per kop één kernvraag.
Redigeren: een prompt met jouw eigen stijlregels die elke tekst langsloopt: te lange zinnen, jargon, clichés eruit.
Elke stap apart is een gewone prompt die je vandaag al kunt maken. De automatisering ontstaat zodra je ze aan elkaar knoopt: de outline uit stap twee gaat automatisch je schrijfprompt in, en dat resultaat gaat automatisch door je redactieprompt. Twijfel je of je prompts scherp genoeg zijn voor zo’n keten? Haal ze eerst door de Prompt Coach.
Het verschil tussen prompten en workflow-bouwen
In 2026 is een duidelijke verschuiving zichtbaar: van losse prompt engineering naar workflow engineering. De winst zit niet langer in dat ene perfecte antwoord, maar in het aan elkaar koppelen van stappen tot een proces dat zichzelf herhaalt. Bedrijven die handmatig werk vervangen door geautomatiseerde workflows verkorten hun productietijd aanzienlijk.
Losse prompt
Je typt een vraag, leest het antwoord, kopieert het en plakt het ergens anders. Werkt prima eenmalig, maar schaalt niet.
Workflow
De output van de ene stap voedt automatisch de volgende. Geen kopieer-en-plak, geen handmatige tussenstappen, wel een resultaat dat reproduceerbaar is.
Van prompt naar proces in vier stappen
Het mooie is dat je geen developer hoeft te zijn om de denkstap te maken. De KOMPAS-aanpak die je leert om helder te formuleren, is precies wat je nodig hebt om een proces uit te tekenen voordat je het automatiseert.
Beschrijf de taak als een herhaalbaar recept. Welke input gaat erin, welke stappen volgen, welk resultaat komt eruit? Schrijf het uit alsof je het aan een collega uitlegt.
Maak elke stap een aparte, scherpe prompt. In plaats van een mega-prompt die alles tegelijk doet, knip je het op. Elke stap heeft een duidelijke taak en een vast outputformaat.
Koppel de stappen aan elkaar. Dit heet prompt chaining: de uitkomst van stap een wordt de input van stap twee. Een tool of API zet de stappen op een rij zonder dat jij ertussen hoeft te zitten.
Test, meet en verfijn. Draai de workflow een paar keer met echte data en kijk waar het misgaat. Bijna altijd ligt het aan een vage prompt, niet aan het model.
Een concreet voorbeeld: video automatiseren
Stel dat je elke week tien korte video’s wilt maken, telkens met dezelfde opbouw maar andere tekst en beelden. Handmatig in een video-editor wordt dat snel sloom. Met heldere prompts kun je elke stap aansturen: een prompt schrijft het script, een prompt kiest de scènes, een prompt bepaalt de ondertiteling. Vervolgens laat je een API het echte montagewerk doen.
Hier komt SamAutomation in beeld. SamAutomation is een Nederlands initiatief rond AI-automatisering dat praktische workflows uitlegt en onderzoekt hoe je tools aan elkaar koppelt. Een goed voorbeeld is het stuk over workflows automatiseren met de CapCut API: het legt eerlijk uit dat CapCut zelf geen kant-en-klare publieke render-API biedt, en bespreekt welke open-source projecten en alternatieven dat gat opvullen om video’s programmatisch in elkaar te zetten.
Belangrijk: de officiële mogelijkheden van zo’n platform veranderen regelmatig. Controleer altijd de actuele documentatie voordat je een workflow in productie neemt.
De vaardigheden die meeschalen
Wat dit voorbeeld laat zien, is dat de echte vaardigheid niet de tool is, maar het denken. Wie leert om een doel op te knippen in heldere stappen en elke stap precies te formuleren, kan dat patroon toepassen op tekst, beeld, video, e-mail of data-analyse. De tool wisselt, de aanpak blijft.
Formuleer doelen meetbaar, zodat je achteraf kunt zien of het werkte.
Houd output strak gestructureerd, want een machine leest geen losse zinnen maar vaste velden.
Bouw klein en breid pas uit als de basis betrouwbaar draait.
Veelgestelde vragen
Moet ik kunnen programmeren om AI-workflows te bouwen?
Voor de denkstap niet. Het opknippen van een taak in heldere prompts kun je volledig in gewone taal doen. Voor de koppeling tussen stappen helpt een no-code automatiseringstool of een API, en daar is steeds minder technische kennis voor nodig.
Wat is prompt chaining precies?
Bij prompt chaining gebruik je de uitkomst van de ene prompt automatisch als invoer voor de volgende. Zo bouw je een keten van kleine, betrouwbare stappen in plaats van een grote, onvoorspelbare prompt.
Waar begin ik het beste?
Kies een taak die je vaak en op dezelfde manier doet. Schrijf het proces eerst uit, maak van elke stap een aparte prompt en test handmatig. Pas als dat werkt, automatiseer je de koppeling.
Conclusie
Goed leren prompten is niet alleen handig om betere antwoorden te krijgen, het is de directe opstap naar automatiseren. Zodra je gewend bent om doelen scherp te formuleren en in stappen te denken, verandert elke herhaalde taak in een kandidaat voor een workflow. Begin klein, blijf je prompts aanscherpen, en je merkt dat de stap van prompten naar automatiseren kleiner is dan hij lijkt.
Verder lezen
Prompt engineering wordt pas nuttig als je de fout kunt aanwijzen: ontbrekende context, verkeerde rol, geen voorbeeld of geen controle op het antwoord. Lees daarna ook bekijk de AI-prompt hub of gebruik de Prompt Coach.
De Cursor Team Kit is een gratis plugin waarmee Cursor zijn eigen interne workflows publiceert: 18 skills, 2 agents en 2 rules voor CI, code review, shippen en het opruimen van AI-rommel. De kit zelf is alleen interessant voor teams die al in Cursor met GitHub en CI werken. De échte waarde zit in wat je eruit leert: het beste AI-dev-team ter wereld vertrouwt zijn agents niet blind, eist bewijs (verify-this), ruimt AI-slop actief op (deslop) en legt elke werkafspraak vast in een markdown-bestand. Dat patroon kun je vandaag kopiëren, ook buiten Cursor.
Cursor heeft een marketplace voor plugins, en het opvallendste item daarin komt van Cursor zelf: de Cursor Team Kit. Geen demo-materiaal, maar de interne workflows die Cursor-developers zelf gebruiken voor CI, code review en shippen. De broncode staat open op GitHub onder MIT-licentie. Ik heb alles doorgespit en dit is mijn eerlijke oordeel: de kit is voor de meeste lezers van deze site niet de juiste download, maar wel verplichte leesstof. Hieronder leg ik uit waarom.
Wat is de Cursor Team Kit precies?
De kit is een plugin voor de Cursor-editor. Je installeert hem met één commando in de chat: /add-plugin cursor-team-kit. Daarna heeft je AI-agent in Cursor een set extra vaardigheden tot zijn beschikking. Cursor omschrijft het zelf als “internal workflows used by Cursor developers for CI, code review, shipping, test reliability, code cleanup, and work summaries”, bewust gebouwd zonder koppelingen met externe diensten. Alles draait lokaal of via GitHub.
Een plugin bestaat in Cursor uit drie soorten bouwstenen, en alle drie zitten in deze kit:
Skills: markdown-bestanden met een stappenplan dat de agent volgt zodra een taak erom vraagt. De kit bevat er 18, van fix-ci tot deslop.
Agents: zelfstandige hulpjes voor terugkerend werk. De kit levert ci-watcher (houdt je CI-checks in de gaten en meldt pass of fail) en een review-subagent.
Rules: vaste afspraken die de agent bij élke taak meekrijgt. Hier twee stuks: imports bovenaan het bestand houden en exhaustive switches afdwingen in TypeScript.
Dat klinkt technisch, en dat is het ook. Maar onthoud dit ene punt: een skill is gewoon een tekstbestand met instructies. Geen code, geen magie. Wie een goede prompt kan schrijven, kan een skill schrijven. Daarom is deze kit ook voor niet-Cursor-gebruikers interessant studiemateriaal. Lees onze KOMPAS-checklist ernaast en je ziet dezelfde principes terugkomen: kader, opdracht, paalwerk, afwerking.
Wat zit erin: de 18 skills in vier groepen
De lijst van 18 oogt indrukwekkend, maar valt netjes uiteen in vier groepen. Zo zie je in één oogopslag wat de kit wél en níet voor je doet.
Statusupdates uit je git-historie en werkvoorkeuren destilleren uit oude chats.
De drie skills die het installeren waard zijn
1. verify-this: eis bewijs van je AI
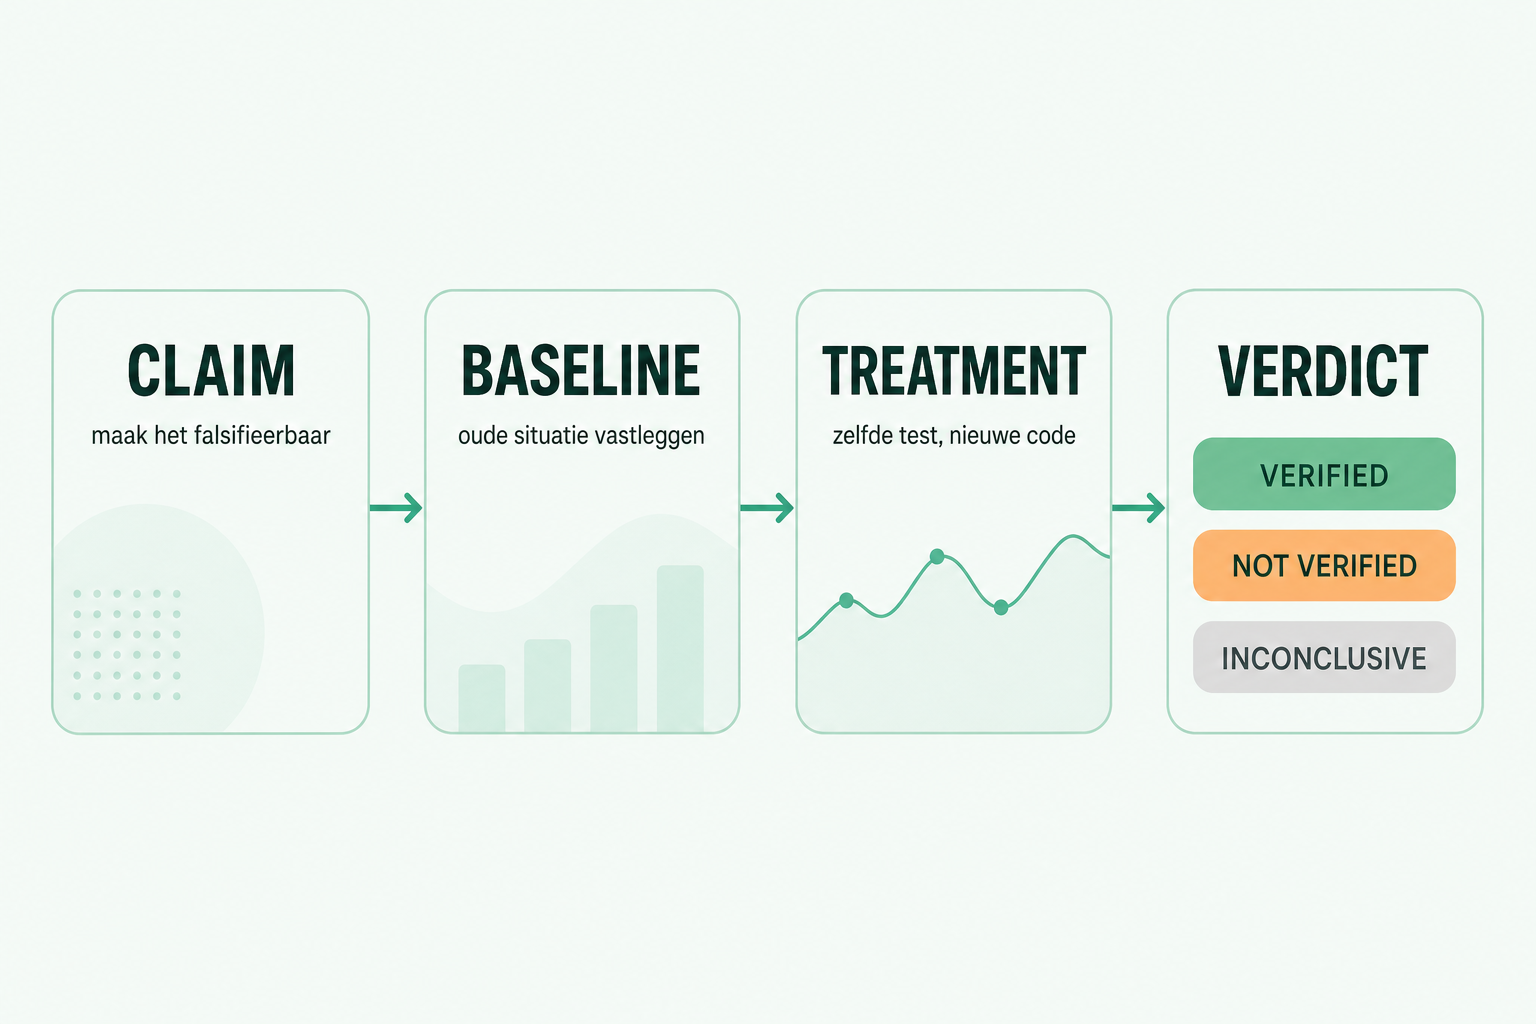
Het verify-this protocol: van claim naar hard oordeel.
Dit is de beste skill van de hele kit, en het document opent met een zin die elke AI-gebruiker op zijn monitor zou moeten plakken: “Verification is not a recap.” Een agent die zegt “de bug is opgelost” heeft niets bewezen. De skill dwingt een hard protocol af: herformuleer de claim falsifieerbaar, leg de oude situatie vast (baseline), meet de nieuwe situatie onder exact dezelfde omstandigheden, en vergelijk de ruwe bewijsstukken: testoutput, screenshots, terminaltranscripten, API-responses. Het eindoordeel kent maar drie smaken: VERIFIED, NOT VERIFIED of INCONCLUSIVE. Geen “het lijkt te werken”. Dit is precies de denkstap die ik in coaching-sessies het vaakst mis bij mensen die met AI werken, of dat nu code is of een marketingtekst.
2. deslop: Cursor erkent dat AI rommel produceert
Deslop in één beeld: zelfde gedrag, minder rommel.
De naam alleen al. Slop is het scheldwoord voor herkenbare AI-uitwas, en Cursor levert een eigen opruimskill mee. Deslop vergelijkt je branch met main en verwijdert de typische sporen van gegenereerde code: overbodige comments, paranoïde try/catch-blokken op plekken waar dat ongebruikelijk is, any-casts die alleen het typesysteem omzeilen, en diep geneste code die met early returns simpeler kan. De spelregel: gedrag blijft ongewijzigd, edits blijven minimaal. Dat de bouwer van de populairste AI-editor dit nodig vindt, zegt genoeg. AI-output is een eerste versie, geen eindproduct. Voor tekst geldt hetzelfde; daarover schreef ik al in betere prompts schrijven.
3. workflow-from-chats: je chats als grondstof
Deze vind ik conceptueel de slimste. De skill leest je Cursor-chats van de afgelopen week en zoekt naar duurzame voorkeuren: momenten waarop je “altijd”, “nooit” of “dit is niet wat ik vroeg” typte. Die observaties zet hij om in nieuwe skills, rules of werkdocumenten, met per voorkeur een betrouwbaarheidsscore. Je corrigeert je AI dus niet langer twintig keer voor hetzelfde, maar laat die correcties één keer vastleggen. Dit idee werkt overal: ook in ChatGPT of Claude kun je je beste correcties verzamelen en in je custom instructions zetten.
De echte les: workflows zijn bestanden, geen losse prompts
Van losse chatberichten naar benoemde, herbruikbare bestanden.
Zoom uit en je ziet wat Cursor hier eigenlijk laat zien. Het team typt zijn werkafspraken niet telkens opnieuw in een chatvenster. Elke afspraak leeft als bestand in versiebeheer: skills voor terugkerende taken, rules voor permanente voorkeuren, agents voor werk dat parallel kan lopen. Nieuwe collega (of nieuwe agent) erbij? Die krijgt dezelfde bestanden en werkt direct volgens de teamnorm.
Vergelijk dat met hoe de meeste mensen met AI werken: elke dag dezelfde instructies opnieuw intypen, elke dag nét iets anders geformuleerd, elke dag wisselende kwaliteit terug. Het verschil tussen die twee werelden is geen talent maar administratie. Schrijf je beste prompts één keer goed op, geef ze een naam en hergebruik ze. Dat is wat een skill is. En dat kun je vandaag nog doen, welk AI-gereedschap je ook gebruikt.
Wat is hype? Een nuchtere blik
Niet alles in de kit verdient applaus. Een flink deel van de 18 skills is gewoon nette basishygiëne met een naam erop. What-did-i-get-done vat je git-commits samen in een statusupdate; prima, maar dat regelt elke agent ook met een losse vraag. New-branch-and-pr maakt een branch aan en opent een pull request. Dat is geen workflow, dat is een werkdag. De twee rules zijn TypeScript-specifiek en voor andere talen waardeloos.
Belangrijker: er zit geen geheime saus in. Het zijn markdown-bestanden, en de kwaliteit van je resultaat hangt nog steeds af van je codebase, je tests en je eigen oordeel. Wie verwacht dat zijn team na /add-plugin opeens schoner werkt, koopt een checklist en denkt dat het discipline is. De kit beloont teams die hun proces al serieus nemen; hij repareert geen team dat dat niet doet.
Voor wie wel, voor wie niet
Situatie
Advies
Team van developers, dagelijks in Cursor, GitHub + CI
Installeren. Vooral verify-this, deslop en de CI-skills verdienen zich direct terug.
Solo-developer of vibe coder met eigen projecten
Cherry-picken. Pak verify-this en deslop, sla de PR- en teamskills over.
Gebruikt geen Cursor maar wel Claude Code, Codex of Copilot
Niet installeren, wel lezen. De SKILL.md-bestanden op GitHub zijn een gratis masterclass in agent-instructies en het patroon is overal na te bouwen.
Geen programmeur, wel dagelijks AI-gebruiker
De kit zelf overslaan. De drie principes meenemen: eis bewijs, ruim AI-output op, leg je beste instructies vast als herbruikbare bestanden.
Zelf aan de slag
Cursor-gebruiker? Typ /add-plugin cursor-team-kit in de chat en de kit staat erin. Bekijk daarna vooral de cursor/plugins-repository: daar staan naast de Team Kit nog acht officiële plugins, waaronder orchestrate (grote taken verdelen over parallelle cloud-agents) en continual-learning (je AGENTS.md automatisch bijwerken met geleerde lessen). Geen Cursor? Open dezelfde repository, lees drie willekeurige SKILL.md-bestanden en let op hoe ze zijn opgebouwd: een trigger, een stappenplan, guardrails en een afgebakende output. Herschrijf daarna je eigen meest gebruikte prompt in dat formaat. Grote kans dat hij er beter van wordt. Wil je daar hulp bij, kijk dan hoe wij dat aanpakken in onze KOMPAS-methode.
Veelgestelde vragen
Is de Cursor Team Kit gratis?
Ja. De kit staat onder MIT-licentie op GitHub en installeren via de marketplace kost niets. Je betaalt alleen je normale Cursor-abonnement en het modelgebruik van de taken die je draait.
Werkt de kit ook buiten Cursor, bijvoorbeeld in Claude Code?
Niet rechtstreeks; het plugin-formaat is van Cursor. Maar omdat skills gewone markdown-bestanden zijn, kun je de inhoud met weinig moeite overzetten naar vergelijkbare systemen in andere agent-tools. De instructies zelf zijn tool-onafhankelijk geschreven.
Heb ik externe diensten of API-keys nodig?
Nee. Cursor heeft de kit bewust gebouwd zonder verplichte koppelingen met externe diensten. De CI- en PR-skills gaan er wel van uit dat je met git en GitHub werkt.
Wat is het verschil tussen een skill, een rule en een agent?
Een skill is een stappenplan dat de agent oppakt wanneer de taak erom vraagt. Een rule geldt altijd, bij elke opdracht. Een agent is een zelfstandige hulp die een afgebakende taak op de achtergrond uitvoert, zoals ci-watcher die je CI-checks volgt en alleen het eindresultaat meldt.
Update: skills geven agents echte vermogens
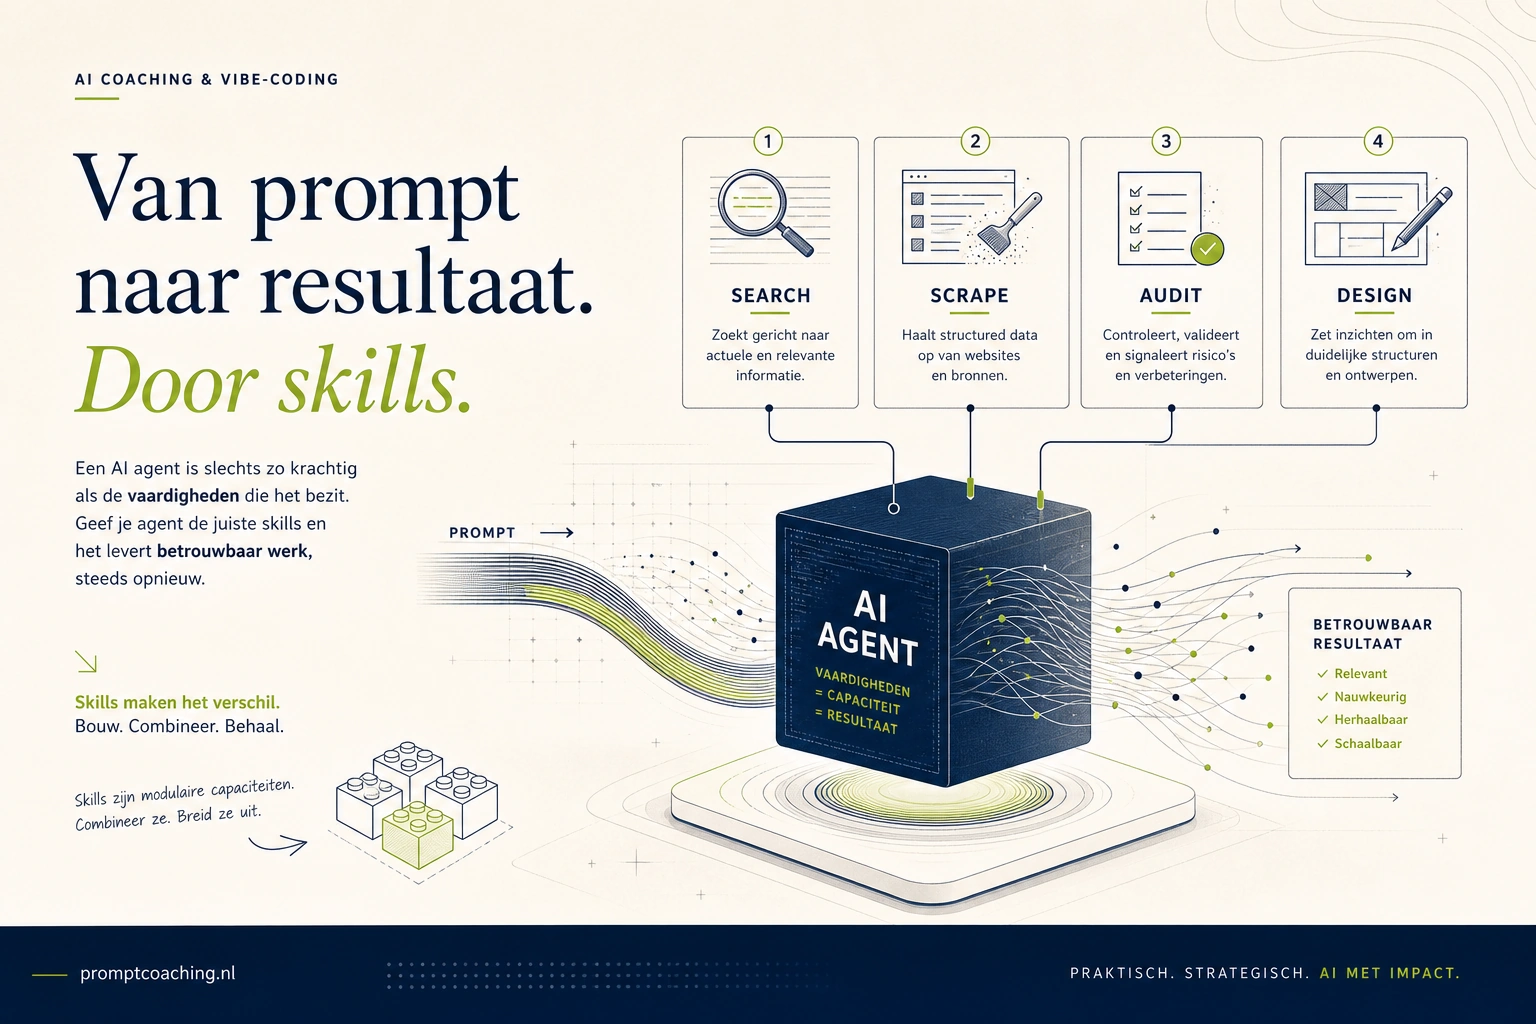
Een goede skill is geen betere promptzin, maar een herhaalbare werkwijze met gereedschap, bewijs en een stopregel. Dat is de praktische les uit de Firecrawl-video over zestien nieuwe Claude Code-skills. De sterke voorbeelden zijn niet de style-skills, maar skills die een agent echt iets laten doen: zoeken, scrapen, crawlen, marktonderzoek uitvoeren, een SEO-audit draaien of een designsysteem ontleden.
Daar zit het verschil tussen een leuk promptmapje en een werkbaar agentsysteem. Een prompt kan zeggen wat je wilt. Een skill legt vast hoe de agent het werk moet aanpakken, welk materiaal hij mag gebruiken en wanneer het resultaat goed genoeg is om door te gaan.
Skills zijn pas waardevol als ze het gedrag van de agent controleerbaar maken.
Style-skill of vermogens-skill?
Veel teams noemen alles een skill: tone of voice, format, persona, checklist. Dat helpt, maar het verandert niet wat de agent kan. Een vermogens-skill voegt drie lagen toe:
Gereedschap: welke bronnen, CLI’s, API’s of bestanden gebruikt mogen worden.
Bewijs: welk artifact moet overblijven, bijvoorbeeld een crawlrapport, screenshot, diff, tabel of checklist.
Stopregel: wanneer de agent moet stoppen, terugvragen of escaleren.
Daarom blijft de Cursor Team Kit nuttig naast dit soort Claude Code-skills. verify-this en deslop zijn geen glimmende features; ze dwingen bewijs en redactie af. Firecrawl-achtige skills voegen daar een tweede laag aan toe: ze geven de agent een concrete informatiebron en een manier om die bron herhaalbaar te gebruiken.
De prompt die ik hiervoor zou gebruiken
Gebruik de relevante workflow-skill expliciet.

Doel: maak een publiceerbaar advies, geen samenvatting.
Bronnen: gebruik alleen de opgegeven URL's, transcriptie en crawlresultaten.
Bewijs: lever een claimtabel, gemarkeerde onzekerheden en een publicatieadvies.
Stopregel: publiceer niet als de bron onvoldoende is of als er cannibalisatie is.
Die laatste regel is de belangrijkste. Een agent die alles probeert te publiceren is geen goede agent. Een goede agent weet wanneer een concept nog niet door de publicatiegate mag.
Wat je niet moet kopiëren
Maak geen map met twintig losse skills omdat een video dat spectaculair laat klinken. Begin met drie skills die je elke week gebruikt: research, verificatie en redactie. Als die aantoonbaar betere output geven, pas dan wordt een extra scrape-, audit- of designsysteem-skill interessant.
Bronvideo: Firecrawl over Claude Code-skills. De waarde zit voor mij niet in het aantal skills, maar in het onderscheid tussen tekstinstructie en echt uitvoerbaar vermogen.
Liever luisteren?
Ik heb de kern hieronder als korte audio/video samengevat: wat een skill wél moet regelen, en waarom bewijs belangrijker is dan een mooi klinkende agentnaam.
Korte voice-over: wanneer wordt een AI-skill een echt agentvermogen?
Verder lezen
Bij AI-coding is de prompt maar de helft. De andere helft is checkpointen: kleine taken, diff lezen, testen en pas daarna doorbouwen. Lees daarna ook bekijk Codex use cases of controleer je AI-workflow.