Categorie: Prompting

Beter leren prompten: technieken, frameworks en voorbeelden waarmee je AI-output direct verbetert.

  • Codex contextbeheer aanzetten

    Codex contextbeheer aanzetten

    Je zit midden in een bouwklus. Codex stelt opnieuw een aanpak voor die je eerder al had afgewezen. Dan mag je weer uitleggen waarom. Experimenteel contextbeheer moet helpen om zulke eerdere details beter beschikbaar te houden. Je kunt het aanzetten in de configuratie van Codex, maar een gegarandeerde besparing op je verbruik is het niet.

    Een bericht van MaxForAI op X bracht de instelling onder de aandacht met de belofte van flink lager GPT-6-verbruik. De functie zelf staat inderdaad in de documentatie van OpenAI. Die documentatie bevestigt de werking en de toegangseisen, maar noemt bij deze instelling geen besparingspercentage.

    Hoe werkt het nieuwe Codex-contextbeheer?

    Een taalmodel kan maar een begrensde hoeveelheid informatie tegelijk meenemen. Dat heet het contextvenster. Bij lange opdrachten moet een code-agent dus bepalen welke eerdere informatie beschikbaar blijft.

    Volgens de configuratiereferentie van OpenAI gebruikt deze experimentele modus notities en doorzoekbare geschiedenis, in plaats van de context herhaaldelijk tot één samenvatting te comprimeren. Het doel is eerder opgebouwde details te bewaren. De functie staat standaard uit en vereist een ChatGPT-login met Plus, Pro of Pro Lite.

    Denk aan een boekingsformulier. Je hebt afgesproken dat een klant eerst een tijdslot kiest en pas daarna zijn e-mailadres invult. Halverwege moet Codex een fout in de beschikbaarheidscontrole oplossen. Die oorspronkelijke keuze moet dan nog meetellen. Een zoekbare eerdere afspraak kan daarbij helpen; alleen een korte samenvatting kan de reden achter de volgorde missen. Dit is een voorbeeld van het probleem, geen gemeten testresultaat.

    Minder opnieuw uitleggen is de goede reden om dit te proberen

    Ik vind dit vooral interessant voor opdrachten die langer duren dan één kleine wijziging. Wie met AI bouwt, wil dat afgewezen oplossingen afgewezen blijven en dat eerdere afspraken terug te vinden zijn. Daar heb je in de praktijk meer aan dan aan een indrukwekkend besparingsgetal zonder vergelijkbare test.

    Het zwakke punt van dat enthousiasme: meer geschiedenis maakt een fout besluit niet goed. Als je aan het begin een onduidelijke opdracht geeft, kan Codex ook die onduidelijkheid bewaren. Een concrete opdracht blijft nodig. In de uitleg over betere prompts schrijven staat hoe je grenzen en gewenste uitkomsten vastlegt.

    Hoe zet je de instelling aan zonder dubbele configuratie?

    Open je persoonlijke bestand ~/.codex/config.toml en maak eerst een kopie. Gebruik je de Codex-extensie in je editor, dan beschrijft OpenAI de route via het tandwiel: Codex Settings → Open config.toml. De uitleg over configuratie vermeldt ook dat projectinstellingen je persoonlijke standaard kunnen overschrijven.

    Zoek eerst op context_management. Staat de instelling al op true, voeg dan niets toe. Ontbreekt hij, dan kun je dit blok gebruiken:

    [features.context_management]
    experimental_mode = true

    Heb je al een blok [features], dan kun je daar ook deze ene regel onder zetten:

    context_management.experimental_mode = true

    Kies één schrijfwijze. TOML, het bestandsformaat van deze configuratie, accepteert geen dubbele definitie van dezelfde instelling. De korte regel hoort binnen [features], vóór het volgende blok tussen vierkante haken. Plak hem dus niet zomaar onderaan het bestand.

    Sla het bestand op en begin een nieuwe taak om de instelling te proberen. Meldt je client dat hij de instelling niet kent, controleer dan of er een update beschikbaar is. Alleen een API-key voldoet niet aan de door OpenAI genoemde ChatGPT-loginvoorwaarde. Wil je terug, zet dezelfde waarde op false.

    Een vinkje bewijst nog geen lager verbruik

    Op 6 september 2026 hebben we de eigen Codex-configuratie gecontroleerd. De instelling stond al op true. Daarmee is vastgesteld dat de optie aanstond. We hebben geen vergelijking van het verbruik met en zonder deze functie uitgevoerd.

    Wil je zelf vergelijken, gebruik dan twee kopieën van dezelfde beginversie van een klein project. Geef dezelfde opdracht met hetzelfde model en dezelfde denkstand, één keer met de functie uit en één keer aan. Noteer het zichtbare verbruik én of het resultaat werkt. Eén poging per stand is hooguit een eerste aanwijzing: modelgedrag kan tussen runs verschillen.

    Je eerste handeling kan nog kleiner: controleer vandaag of de instelling al in je bestand staat. Bij een volgende langere bouwklus kun je vervolgens letten op een concrete afspraak die Codex eerder vergat. Blijft die behouden en hoef je minder te corrigeren, dan merk je waar deze functie nuttig kan zijn. Voor een eerste oefenproject kun je de stappen voor vibe coding leren gebruiken. Een herhaalde vergelijking moet daarna uitwijzen of ook het verbruik daalt.

    Geschreven door Sam. Instelling en documentatie gecontroleerd op 6 september 2026.
  • Claude Academy: prompten is maar één van de vier vaardigheden

    Claude Academy: prompten is maar één van de vier vaardigheden

    Anthropic heeft zijn hele leeraanbod op één adres gezet: academy.claude.com. 289 onderdelen, 22 cursussen, gratis, geen betaalmuur. Ik ben er een avond doorheen gegaan.

    Wat me opviel zit niet in de productcursussen. Het zit in hun basisraamwerk. Anthropic verdeelt werken met AI in vier vaardigheden, en prompten is er daar één van. De andere drie zijn precies de plekken waar het bij mijn cursisten misgaat.

    Het 4D-raamwerk in gewoon Nederlands

    Anthropic noemt het AI Fluency en hangt het op aan vier woorden die allemaal met een D beginnen. Dat klinkt als een consultantstruc, maar de indeling klopt met wat ik in de praktijk zie.

    Vaardigheid Wat het is Waar het misgaat
    Delegation Bepalen wat je uit handen geeft en wat je zelf houdt Mensen geven het verkeerde weg: de creatieve keuze, niet het uitzoekwerk
    Description De taak uitleggen. Dit is prompten. Te weinig context, of juist een prompt van vier alinea’s voor iets simpels
    Discernment Beoordelen of het antwoord deugt Het antwoord ziet er goed uit, dus het is goed. Dit is de grootste val.
    Diligence Controleren en verantwoordelijkheid houden voor wat je verstuurt Overslaan onder tijdsdruk, precies wanneer het ertoe doet

    Als je een van deze vier moet kiezen om aan te werken: neem Discernment. Een model dat overtuigend klinkt terwijl het ernaast zit, kost je meer dan een model dat slecht klinkt. Dat leert een prompt-cursus je niet, want het gaat niet over invoeren maar over lezen.

    Prompten is de vaardigheid die je het snelst leert en die het minst oplevert als de andere drie ontbreken.

    Description is het deel dat je waarschijnlijk al kunt

    Als je hier al langer meeleest, heb je Description grotendeels binnen. Een taak beschrijven met context, doel, vorm en een voorbeeld — dat staat in de prompt-formule en in de KOMPAS-checklist. De Academy zegt hetzelfde in andere woorden.

    Dat is meteen de reden dat ik niemand aanraad om vier uur AI Fluency door te ploegen als je al dagelijks prompt. Je herkent het meeste. Kijk in plaats daarvan naar de cursus AI Capabilities and Limitations (13 lessen, 3,5 uur). Die gaat over next-token-voorspelling, werkgeheugen, stuurbaarheid en contextgrenzen — dus over waaróm een model iets fout doet. Dat is Discernment-materiaal.

    Wat ik zou doen, per situatie

    Waar je staat Wat ik zou pakken Tijd
    Je prompt dagelijks, wilt scherper worden AI Capabilities and Limitations 13 lessen, 3,5 uur
    Je wilt Claude echt leren in plaats van erin typen Claude 101 13 lessen, 2,5 uur
    Je wilt taken uit handen geven, niet vragen stellen Introduction to Claude Cowork 14 lessen, 2,5 uur
    Je bouwt met AI (vibe coding, eigen tools) Claude Code 101 → Claude Code in Action 2× 1 uur
    Je rolt AI uit in een team AI Fluency for Small Businesses 9 lessen, 4 uur
    Je moet AI uitleggen aan anderen Teaching AI Fluency 7 lessen, 4,5 uur

    De lessen zijn geschreven, niet gefilmd, en er zitten oefeningen in de tekst. In de eerste les van Claude 101 krijg je zes verzoeken en moet je per stuk kiezen of een zoekvenster het afkan of dat je er een denkpartner voor nodig hebt. Twee daarvan zijn expres lastig. Dat is een betere test dan de meeste quizzen die ik in betaalde cursussen ben tegengekomen.

    Voor wie met AI bouwt

    Het spoor voor bouwers is kort. Claude Code 101 (12 lessen, 1 uur) legt de basiswerkwijzen uit. Claude Code in Action (9 lessen, 1 uur) gaat over lange sessies die je durft los te laten: sturen, instellen, automatiseren en achteraf controleren. Daarna liggen er twee korte verdiepingen: agent skills (6 lessen) en subagents (4 lessen, 45 minuten).

    Bouw je iets met de API, dan is er een cursus van 67 lessen en 9 uur die van prompting via tool use en RAG naar agents en MCP loopt. Draai je op AWS of Google Cloud, dan bestaat dezelfde stof als variant voor Bedrock en Vertex AI. Kies er één. Ze overlappen voor ruim tachtig procent.

    Voor de volgorde vanuit prompten naar bouwen schreef ik eerder van goed prompten naar automatiseren. De Academy vult daar het Claude-specifieke deel van in.

    Wat je aan een badge hebt

    Elke cursus eindigt met een quiz en een badge. Zet hem op LinkedIn als je wilt, maar noem het geen certificering. Het is een bewijs dat je de lessen hebt doorlopen.

    Er bestaat wel een geëxamineerd traject, het Claude Certification Program via Pearson VUE, met examens voor Associate, Architect en Developer. Dat staat alleen open voor mensen bij organisaties in het Claude Partner Network. Voor de meesten van ons dus niet.

    Waar de gratis cursus ophoudt

    Ik ga niet doen alsof dit niets is. Het is beter materiaal dan een groot deel van wat er in Nederland voor geld wordt aangeboden, en het kost je nul euro.

    Waar het ophoudt: het is Engels, het is van Anthropic zelf (verwacht geen eerlijke vergelijking met ChatGPT of Gemini), en het gaat over Claude in het algemeen — niet over jouw offertes, jouw klantmails, jouw codebase. Een cursus kan je laten zien hoe delegeren werkt. Hij kan niet met je meekijken terwijl je het de eerste keer verkeerd doet. Dat is precies het verschil met een sessie samen, en verder ga ik er niet over doorzeuren.

    Wat ik je aanraad om deze week te doen

    1. Doe de intake op academy.claude.com/start. Vier vragen, dan krijg je een pad. Kost een minuut.
    2. Zet één cursus uit de tabel hierboven in je agenda, in blokken van twintig minuten. Vier uur op een zaterdag houdt niemand vol.
    3. Pak daarna een echte taak van je werk, niet het voorbeeld uit de les. Zonder je eigen bestanden erin blijft het theorie.

    Veelgestelde vragen

    Heb ik hier iets aan als ik ChatGPT gebruik?
    Aan de AI Fluency-cursussen wel. Delegeren, beschrijven, beoordelen en controleren werkt bij elk model hetzelfde. De productcursussen gaan puur over Claude.

    Moet ik betalen of inloggen?
    Nee en nee — de lessen zijn gewoon te openen. Inloggen is er voor je voortgang en je badge. Voor de oefeningen heb je een Claude-account nodig; het gratis account volstaat voor het meeste. Cowork en Enterprise Search kun je alleen zelf proberen met een betaald of zakelijk abonnement.

    Is dit een vervanging voor prompt-training?
    Voor de basis grotendeels wel. Voor het toepassen op je eigen werk niet, want daar zit het probleem zelden in de formulering.

    Is er Nederlands?
    Nee. Alles is Engels. De taal is simpel en het is leeswerk, geen video, dus je kunt je eigen tempo bepalen.

    Bronnen

    • Claude Academy — Anthropic, geraadpleegd 20 augustus 2026 (289 onderdelen, 22 cursussen)
    • AI Fluency — het 4D-raamwerk: Delegation, Description, Discernment, Diligence
    • Claude 101 — 13 lessen, 1 quiz, 2,5 uur, voorwaarden en doelgroep
    • Claude Certification Program — Pearson VUE, examenroute voor het Claude Partner Network
  • GLM-5.3: kies effort per taak

    GLM-5.3: kies effort per taak

    Gebruik GLM-5.3 niet standaard op de zwaarste stand voor iedere opdracht. Zet max in voor een bug die meerdere bestanden raakt, een migratie of een onduidelijke fout. Voor een kleine uitleg of gerichte wijziging is low vaak een betere eerste proef. Het model kiezen is minder belangrijk dan je taak scherp begrenzen.

    Z.ai bracht GLM-5.3 op 14 augustus 2026 uit voor codewerk en cyberanalyse. Het model is beschikbaar via Coding Plan en werkt volgens de documentatie in onder meer OpenCode en Claude Code.

    Wat verandert er voor je prompt?

    GLM-5.3 is gebouwd om zelfstandig meerdere stappen te zetten. Een vage opdracht als ‘verbeter deze website’ geeft het model daardoor veel ruimte om zelf aannames te maken. Dat klinkt handig, tot de agent precies het onderdeel wijzigt dat je wilde behouden.

    Geef bij codewerk altijd vijf dingen mee:

    1. Doel: welk zichtbaar of meetbaar resultaat moet er zijn?
    2. Scope: welke map, pagina of functie mag veranderen?
    3. Behoud: wat mag beslist niet wijzigen?
    4. Bewijs: welke test of controle moet slagen?
    5. Stopmoment: wanneer moet de agent stoppen en terugkoppelen?

    Dat sluit aan op het verschil tussen een system prompt en een user prompt: vaste veiligheids- en werkinstructies horen niet verstopt te zitten in één losse opdracht.

    Wanneer kies je low, high of max?

    Effort Geschikte taak Let op
    low uitleg, kleine aanpassing, bekende fout snel controleren of de richting klopt
    high meerdere bestanden, lastige testfout meer tijd en verbruik
    max architectuur, migratie, hardnekkige bug alleen met duidelijke grenzen en tests

    Z.ai ondersteunt alleen deze drie reasoning-effortniveaus. ‘Thinking’ helemaal uitschakelen kan bij 5.3 niet. De maker adviseert max voor coding, maar dat is een algemene aanbeveling. Je eigen taak bepaalt of de extra rekentijd iets oplevert.

    Een prompt die GLM-5.3 minder laat gokken

    Doel: los de fout op waardoor het contactformulier na een geldige inzending een 500 geeft.
    
    Scope: alleen de formulier-handler en bijbehorende tests.
    Behoud: verander geen velden, teksten, styling of e-mailontvangers.
    
    Werkwijze:
    1. Reproduceer eerst de fout.
    2. Leg de oorzaak in maximaal vijf regels uit.
    3. Maak de kleinste reparatie.
    4. Draai de bestaande tests en voeg één regressietest toe.
    
    Stop als productiegegevens, secrets of een externe betaling nodig zijn.
    Lever de diff en testuitvoer op.

    Deze opdracht voorkomt niet iedere fout. Hij maakt een fout wel eerder zichtbaar. De agent moet eerst bewijzen dat hij hetzelfde probleem ziet, daarna klein wijzigen en tot slot testen.

    Test GLM-5.3 naast je huidige model

    Gebruik niet twee verschillende bugs om modellen te vergelijken. Geef beide modellen dezelfde afgeronde taak, dezelfde context en dezelfde stopregel. Kijk vervolgens naar vier uitkomsten: is de fout opgelost, zijn alle tests groen, hoeveel herstelwerk was nodig en hoeveel tijd kostte het?

    De officiële GLM-5.3-benchmarks zijn sterk, maar komen bij release vooral van Z.ai zelf. Een model dat hoog scoort op Terminal-Bench kan alsnog minder goed passen bij jouw repository, taal of manier van werken. De aanpak uit onze praktische modelvergelijking blijft gelden: kies op basis van je eigen taak, niet op basis van één ranglijst.

    Mijn advies: maak GLM-5.3 eerst een bewuste tweede optie in OpenCode of Claude Code. Gebruik max op één lastige maar afgebakende taak. Pas als de diff kleiner, de tests beter en het herstelwerk lager uitvallen, heb je een reden om je standaardmodel te veranderen.

  • De prompt achter OpenAI’s wiskundestunt: 7 lessen voor jouw prompts

    De prompt achter OpenAI’s wiskundestunt: 7 lessen voor jouw prompts

    TL;DR: OpenAI publiceerde deze week niet alleen de claim dat GPT-5.6 Sol Ultra een vijftig jaar oud wiskundevermoeden bewees — het publiceerde ook de complete prompt die dat resultaat opleverde. Die twee pagina’s tekst zijn de beste promptles die ik dit jaar heb gelezen, en vrijwel elke techniek erin werkt ook in een gewone chat. Voor de volledigheid: het bewijs zelf moet nog door wiskundigen worden gecontroleerd; de prompt is daarvan losstaand leerzaam.

    Even de context. Op 10 juli meldde OpenAI dat zijn nieuwe topmodel met 64 parallelle agents in een uur een bewijs vond van de Cycle Double Cover-conjecture, een beroemd open probleem uit de graaftheorie. Naast het bewijs staat ook de letterlijke prompt online. Ik heb hem woord voor woord gelezen — beroepsdeformatie — en er zeven lessen uitgehaald die je vandaag kunt toepassen. Ook zonder 64 agents. Ook in ChatGPT, Claude of Gemini.

    Les 1: definieer eerst de begrippen, dan pas de vraag

    De prompt begint niet met “bewijs dit vermoeden”. Hij begint met vier zinnen die vastleggen wat een graaf, een brug en een cykel in déze opdracht betekenen — inclusief randgevallen (“twee parallelle kanten vormen een cykel van lengte twee”). Pas daarna komt de opdracht.

    Vertaling naar jouw praktijk: als in je prompt een woord staat dat op twee manieren uitgelegd kan worden (“rapport”, “samenvatting”, “klant”), leg het dan vast vóór je de taak geeft. De helft van de teleurstellende AI-antwoorden die ik in coaching voorbij zie komen, begint met een definitieverschil.

    Les 2: schrijf op wat NIET telt als antwoord

    Het meest onderschatte blok uit de prompt is een opsomming van alles wat niet als oplossing geldt: deelresultaten, bewijzen voor speciale gevallen, reducties naar een ander onbewezen vermoeden, “kandidaat-tegenvoorbeelden zonder certificaat”. Wie weleens een groot rapport aan een model vraagt, herkent waarom dit nodig is: zonder die lijst lever je het model tien vluchtwegen om met iets half af te komen.

    Doe dit bij elke serieuze opdracht. “Kom niet terug met een opsomming van aandachtspunten; ik wil een besluit met onderbouwing” verandert de uitkomst meer dan welke beleefdheidsformule dan ook.

    Les 3: neem aan dat het kan

    Er staat één zin in die op het eerste gezicht vals spelen lijkt: “Assume for purposes of this task that a complete affirmative proof exists” — neem aan dat er een volledig bewijs bestaat. Waarom zou je dat doen? Omdat een model dat “weet” dat een probleem als onopgelost te boek staat, geneigd is precies dát te antwoorden: dit is een beroemd open probleem, hier is een samenvatting van de literatuur. De aanname snijdt die uitweg af en dwingt het model om te zóéken in plaats van te classificeren.

    In het klein gebruik je dit al als je schrijft: “er bestaat een elegante oplossing voor dit probleem in onze codebase — vind hem”. Let op de grens: je duwt het model naar volharding, niet naar verzinsels. Daarom bestaat les 4.

    Les 4: organiseer je eigen tegenspraak

    De prompt eist “adversarial agents” die elk kandidaat-bewijs aanvallen op een concrete lijst faalwijzen, en verwerpt expliciet “statusrapporten en vaag optimisme”. Precies dit onderdeel maakt les 3 veilig: hard duwen op volharding mag, omdat er een even harde filter achter staat.

    In een gewone chat bootst je dit na met één vervolgbericht: “Val je eigen antwoord nu aan alsof je een strenge reviewer bent. Zoek: aannames zonder bron, stappen die niet volgen, randgevallen die falen. Herstel daarna alleen wat echt stuk is.” Ik noem dat in mijn coaching de tweede-stoel-truc, en het is de snelste kwaliteitswinst die ik ken.

    Les 5: geef een tijdsbudget, geen deadline

    Mijn favoriete zin: “Spend at least 8 hours on this before even thinking of returning or giving up.” Minstens acht uur — een minimum, geen maximum. Wij zetten in prompts bijna altijd een plafond (“houd het kort”, “max 500 woorden”) en zelden een vloer. Terwijl moderne modellen met een redeneervermogen vooral vroegtijdig stóppen als je niets zegt.

    Probeer het verschil: “denk hier eerst grondig over na en werk minstens drie serieuze alternatieven uit voordat je kiest” versus een kale vraag. Bij analyse- en schrijftaken is het gat verbluffend.

    Les 6: bewaak de onafhankelijkheid van pogingen

    De prompt verbiedt de dirigent om alle agents te vertellen welke aanpak favoriet is — anders kruipt de hele zwerm naar dezelfde doodlopende route. Jij doet hetzelfde in het klein wanneer je drie varianten wilt: vraag ze in gescheiden gesprekken, of expliciet “drie wezenlijk verschillende aanpakken, deel geen aannames tussen de varianten”. Drie variaties op één idee is geen keuze.

    Les 7: sluit de sluiproutes naar buiten af

    Het slot van de prompt: zoeken op het web mag alleen voor standaardachtergrond, níet om de oplossing of de status van het probleem op te zoeken. De opstellers wisten precies welke kortere wegen het model zou proberen, en sloten ze één voor één af. Dat is de kern van goed prompten: niet magische woorden vinden, maar de voorspelbare uitwegen dichttimmeren.

    Wat we (nog) niet zeker weten

    • Of het bewijs zelf klopt — wiskundigen zijn nog aan het lezen en peer review ontbreekt vooralsnog. De prompt blijft leerzaam, wat er ook uit die controle komt.
    • Of deze prompt in één keer raak was of de zoveelste iteratie. Mijn geld staat op dat laatste; niemand schrijft zo’n uitsluitingslijst zonder eerst tien keer verkeerd verrast te zijn.
    • Hoeveel van het resultaat aan de prompt hangt en hoeveel aan de multi-agent-infrastructuur die je als gewone gebruiker (nog) niet hebt.

    Mijn oordeel

    Vergeet even of de wiskunde standhoudt — dat oordeel is aan de wiskundigen. Wat mij betreft is de gepubliceerde prompt zelf het nieuws. Hij bevestigt wat ik hier al langer beweer: het verschil tussen een matig en een sterk resultaat zit zelden in het model en bijna altijd in de opdracht. Definities vooraf, een uitsluitingslijst, georganiseerde tegenspraak, een vloer onder de denktijd. Niks daarvan vereist 64 agents. Wil je die technieken systematisch leren toepassen, begin dan bij mijn gids over betere prompts schrijven of test je huidige prompt in de Prompt Coach.

  • ChatGPT Work gebruiken: schrijf een werkopdracht, geen losse prompt

    ChatGPT Work gebruiken: schrijf een werkopdracht, geen losse prompt

    ChatGPT Work vraagt niet om een langere prompt, maar om een betere werkopdracht. Zet doel, bronnen, output, controle en stopregels in dezelfde instructie. Dan weet de agent niet alleen wat hij moet maken, maar ook wanneer hij jouw keuze nodig heeft.

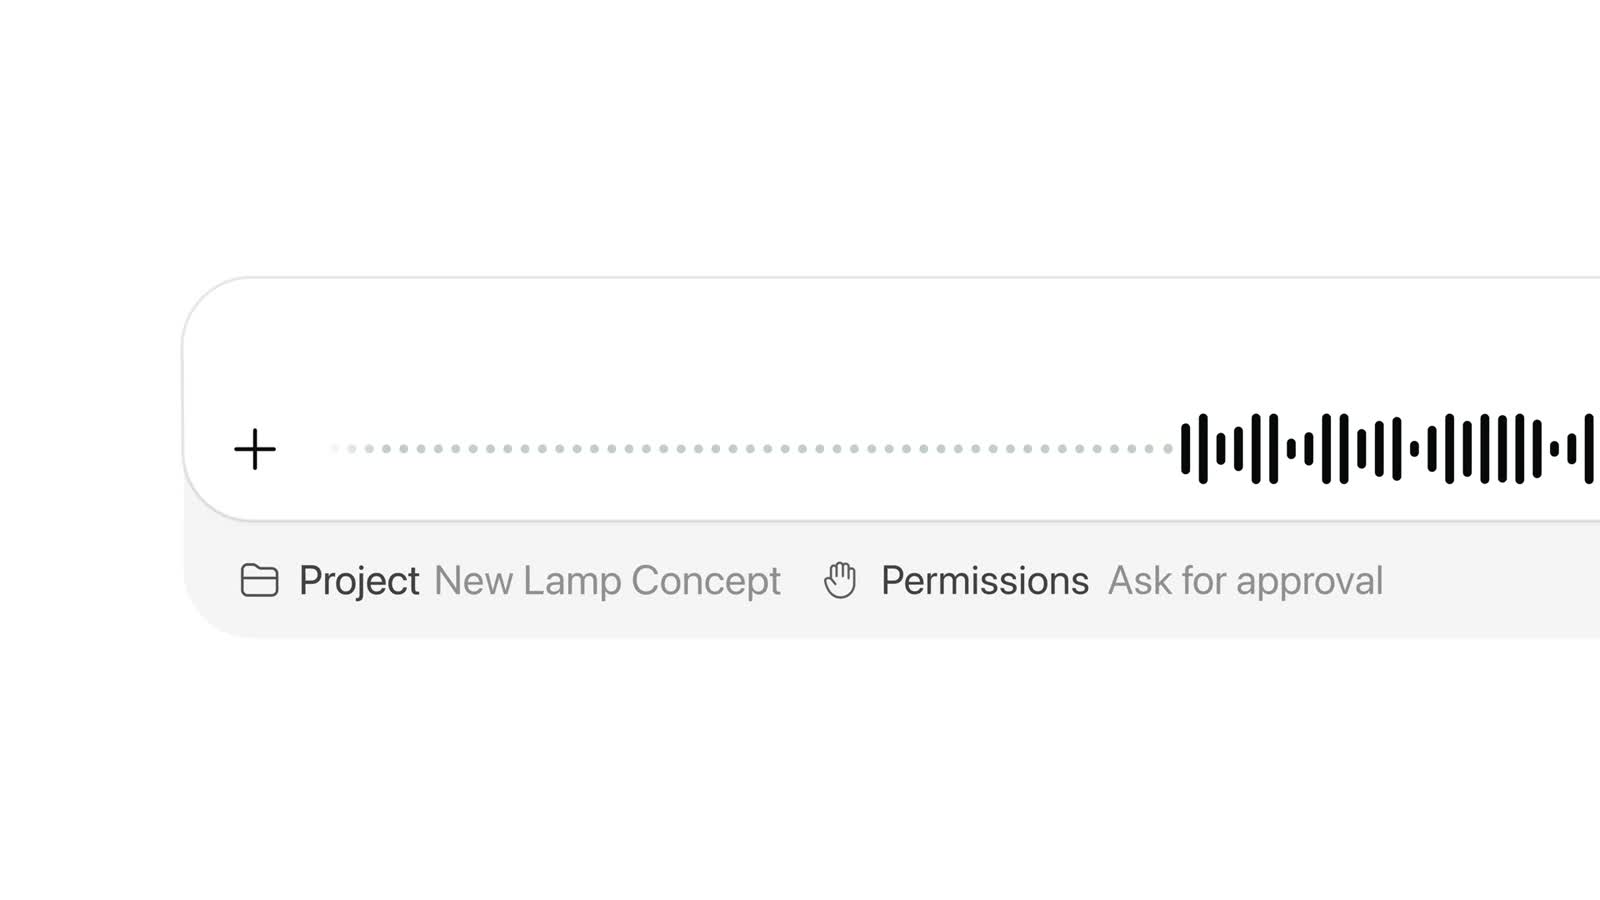
    In OpenAI’s video krijgt Work een producttaak met materiaalkeuzes, financiële projecties, marketinginformatie en een deck. Dat is geen losse vraag. Het is een opdracht met verschillende bronnen en een duidelijk eindproduct.

    Doel Maak [concreet resultaat] voor [doelgroep].

    Bronnen Gebruik alleen [bestanden, apps en links].

    Output Lever [document, spreadsheet, presentatie, rapport of site] op.

    Controle Controleer [claims, cijfers, toon en volledigheid].

    Akkoord Vraag toestemming vóór [mailen, publiceren, betalen of wijzigen].

    Stopregel Stop bij [ontbrekende bron, conflict of onduidelijke keuze].

    Van vage prompt naar controleerbare taak

    Te vaag

    “Maak een campagne voor onze nieuwe lamp.”

    Beter

    “Cluster de feedback uit het aangewezen kanaal, markeer onbewezen productclaims en maak daarna een campagnebrief van één pagina.”

    De betere opdracht maakt het eerste resultaat bewust kleiner. Je controleert eerst of Work de context goed begrijpt. Pas daarna laat je copy, beeld of een presentatie uitwerken.

    Vraag om bewijs van de gebruikte context

    • Laat Work de gebruikte bronnen benoemen.
    • Vraag om tegenstrijdigheden en onzekerheden apart te zetten.
    • Beoordeel eerst een outline of briefing.
    • Geef pas later rechten voor publicatie of klantcontact.
    Werkregel: hoe groter de mogelijke schade van een actie, hoe eerder Work moet stoppen voor jouw akkoord.

    Sommige tools hebben dat bewijs ingebouwd. Bij AI juridisch advies met echte bronnen eindigt elk antwoord met de wetsartikelen en uitspraken waar het op steunt — je hoeft er niet om te vragen, en je controleert het met één klik. Dat is de standaard die je met je eigen prompts probeert af te dwingen.

    Wanneer een gewone chat beter is

    Gebruik geen agenttaak voor een korte uitleg of brainstorm zonder deliverable. Chat is dan directer. Work wordt pas interessant wanneer context, voortgang en meerdere stappen werkelijk nodig zijn om tot het afgesproken resultaat te komen.

    Bronnen en claimgrenzen

    Dit artikel gebruikt de officiële OpenAI-aankondiging op X van 9 juli 2026, OpenAI Help Center: ChatGPT Work and Codex, OpenAI Help Center: Codex met je ChatGPT-plan en het ChatGPT-overzicht. De video laat een productrichting en voorbeeldworkflow zien; beschikbaarheid, koppelingen en accountmogelijkheden kunnen per uitrolmoment verschillen.

  • GPT-Live: spraak wordt je werkinterface — prompts voor full-duplex gesprekken

    GPT-Live: spraak wordt je werkinterface — prompts voor full-duplex gesprekken

    GPT-Live verandert hoe je met ChatGPT praat: het model luistert en spreekt tegelijk, je kunt onderbreken, en complexe vragen worden op de achtergrond door GPT-5.5 beantwoord. OpenAI noemde het op X het slimste spraakmodel tot nu toe. Voor vibe coders en prompt-coaches betekent dat: spraak wordt een serieuze werkinterface — niet alleen een gimmick voor onderweg.

    Wat is GPT-Live in één minuut?

    • Full-duplex — geen turn-based wachten; onderbreken zoals bij een mens
    • GPT-Live-1 (betaald) en GPT-Live-1 mini (gratis) vervangen Advanced Voice Mode
    • Delegatie — zoeken en redeneren gaat naar GPT-5.5 terwijl het gesprek doorloopt
    • Visuele kaarten tijdens het gesprek (weer, data, sport)

    OpenAI ziet spraak als toekomstige primaire interface voor langdurig agentisch werk — vergelijkbaar met Codex, maar hands-free.

    Waarom dit ertoe doet voor prompting

    Tekst-prompts zijn gecontroleerd: je ziet wat je typte. Spraak is rommeliger — aarzelingen, halve zinnen, onderbrekingen. GPT-Live is gebouwd voor die realiteit. Dat verandert hoe je instructies geeft:

    1. Begin met context in één adem — “Ik zit in project X, Python, ik wil functie Y — wacht even, ik bedoel Z” — het model volgt mee
    2. Gebruik onderbreken als sturing — “stop, andere aanpak” werkt nu echt
    3. Vraag om zichtbare output — “laat me een kaart zien” triggert visuele cards
    4. Stel een stopregel — “Als je iets niet weet, zeg het hardop en zoek dan” past bij delegatie naar GPT-5.5

    Test je gespreksopbouw eerst in tekst via de prompt-coach; spreek daarna dezelfde structuur in.

    Sol vs Live: twee launches, één week

    Donderdag kwam GPT-5.6 Sol voor developers (API/Codex). GPT-Live zit nu in ChatGPT voor consumenten. Als coach: leer klanten het verschil — Live voor gesprekken en uitleg, Sol voor code en agents zodra ze API-toegang hebben.

    Companion is nu een hardwaredoel, geen relatiebelofte

    Bloomberg-journalist Mark Gurman meldde op 14 juli 2026 dat OpenAI’s eerste apparaat een verplaatsbare speaker zonder scherm wordt. De gebruiker zou er een band mee moeten opbouwen als met een AI-companion. Dat is bronrapportage, geen productaankondiging van OpenAI.

    Voor prompting verandert er wel iets. Als je niets terugleest, moet je opdracht zelf een controlelus bevatten:

    1. Context: “Ik werk aan project X. Gebruik alleen de planning van vandaag.”
    2. Opdracht: “Maak drie opties en kies er nog geen.”
    3. Teruglezing: “Herhaal wat je gaat doen en welke informatie je bewaart.”
    4. Stopregel: “Voer niets externs uit zonder mijn aparte ja.”

    Een warme stem is geen toestemming. Geheugen, toolrechten en emotionele afhankelijkheid blijven aparte onderwerpen. Bij coaching zou ik voice voor werk en uitleg gebruiken, met schriftelijke controle voor bedragen, berichten, publicaties en andere acties die je niet makkelijk terugdraait.

    Wat een schermloze interface van je prompt vraagt

    Risico Zeg dit hardop
    Verkeerde context “Noem eerst welke context je gebruikt.”
    Te snelle actie “Maak een voorstel, voer nog niets uit.”
    Onduidelijk geheugen “Gebruik dit alleen in dit gesprek en onthoud het niet.”
    Misverstaan commando “Herhaal ontvanger, bedrag en actie vóór bevestiging.”

    Dat is minder soepel dan “regel het even”, maar veel bruikbaarder. Een goede voiceprompt maakt de ontbrekende visuele preview deels goed. Voor de laatste controle blijft een scherm of auditlog nodig.

    Praktische use cases

    Taak Voice-tip
    Code-uitleg tijdens wandeling Vraag om stap-voor-stap; onderbreek bij onduidelijkheid
    Brainstorm feature Laat het model “mhmm” doen terwijl jij nadenkt
    Research met bronnen Vraag expliciet om web search; wacht op visuele card
    Prompt verbeteren Lees je prompt hardop; vraag “wat mist hier?”

    Bronnen

    Verder lezen

    Combineer voice met schriftelijke controle: zes checkpoints voor AI-coding of een coaching-sessie om je spraak-workflow strak te zetten.

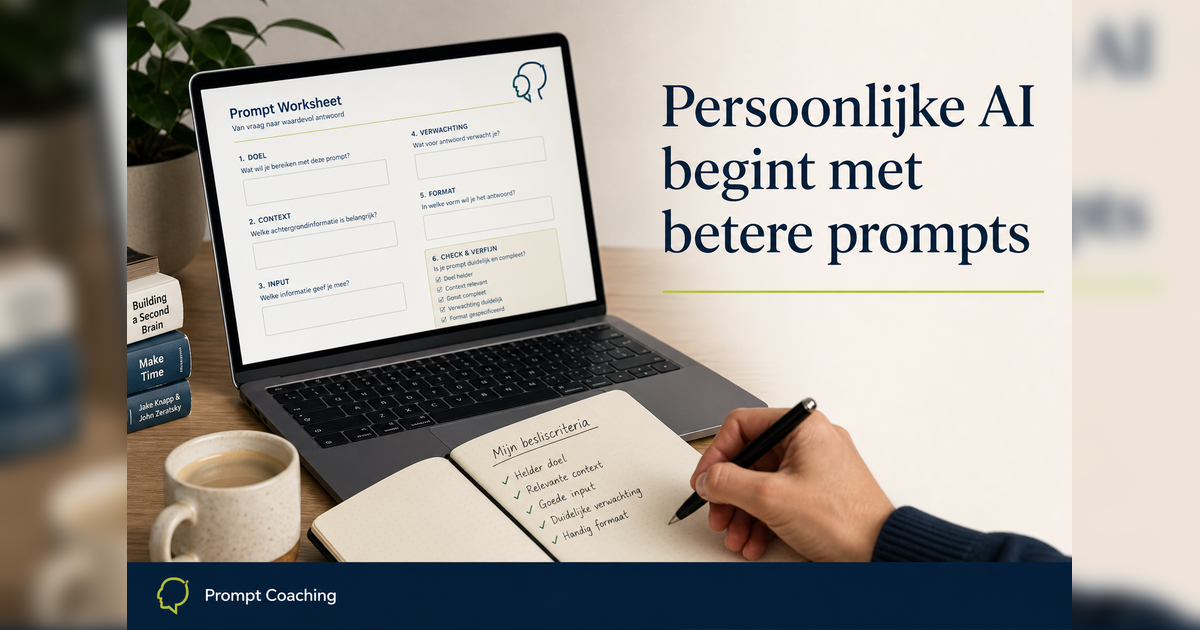
  • Persoonlijke AI begint met betere prompts

    Persoonlijke AI begint met betere prompts

    OpenAI noemt persoonlijke AGI als einddoel, maar voor ondernemers zit de praktische winst nu al in iets kleiners: een AI die uw context, criteria en grenzen goed meekrijgt. Een beter model helpt pas echt wanneer u beter kunt sturen.

    Het plan van OpenAI, Built to benefit everyone: our plan, vergelijkt AI met infrastructuur zoals elektriciteit. Die vergelijking klopt vooral op een punt: waarde ontstaat pas wanneer gewone mensen er werk mee kunnen doen. Niet in een demo. Niet in een abstract toekomstbeeld. In de mailbox, briefing, codebase, klantenservice, offerte of analyse waar u vandaag mee vastloopt.

    Persoonlijke AI begint met betere opdrachtgeving

    Veel mensen wachten op een slimmer model terwijl hun huidige prompts nog geen duidelijke taakgrens hebben. Dat geeft rommelige output, vooral bij werk waar oordeel nodig is: een klantmail herschrijven, een juridisch risico samenvatten, een salespagina beoordelen of een idee omzetten naar een uitvoerbaar plan.

    Een persoonlijke AI werkt beter wanneer u drie dingen vooraf scherp maakt:

    • welke beslissing de AI voorbereidt;
    • welke informatie vaststaat en welke twijfelachtig is;
    • waar u zelf de eindkeuze houdt.

    Dat klinkt simpel. In de praktijk is dit precies waar veel AI-gebruik stukloopt. De gebruiker vraagt om “een strategie” en krijgt een glad document terug. Beter is: “maak drie opties voor mijn nieuwsbrief, beoordeel ze op doelgroepfit, risico op holle taal en verkoopdruk, en adviseer welke ik handmatig moet uitwerken.” Dan helpt AI uw oordeel vooruit in plaats van het te vervangen.

    Gebruik AI als werkruimte, niet als antwoordmachine

    OpenAI benadrukt menselijke sturing: richting kiezen, afwegingen maken, smaak toepassen en verantwoordelijkheid nemen. Voor promptwerk betekent dit dat u AI niet als eindredacteur moet behandelen, maar als werkruimte waarin u sneller kunt denken.

    Een goede werkruimte heeft vaste patronen. Voor zakelijke prompts werkt dit vaak beter dan losse voorbeeldzinnen:

    1. Geef de taak en het echte einddoel.
    2. Geef context die de AI niet kan raden.
    3. Noem de criteria waarop u de output beoordeelt.
    4. Vraag eerst om opties of diagnose, daarna pas om tekst.
    5. Laat de AI expliciet onzekerheden markeren.

    Wie hiermee wil oefenen, kan starten met de Prompt Coach of de promptgidsen per model. Voor softwareteams is de gids met OpenAI Codex use cases een logische volgende stap, omdat daar de grens tussen opdracht, context en controle direct zichtbaar wordt.

    Wat ondernemers vandaag kunnen aanpassen

    Wacht niet tot “persoonlijke AGI” als productlabel volwassen is. Maak nu al een persoonlijke AI-werkwijze voor drie terugkerende taken. Kies taken waar een fout niet meteen schade doet, maar waar context veel verschil maakt. Denk aan contentbriefs, meetingvoorbereiding, e-mailtriage, concurrentieanalyse of conceptvoorstellen.

    Maak per taak een vaste promptkaart met:

    • doel van de taak;
    • input die u altijd meestuurt;
    • regels voor toon, bronnen en aannames;
    • de menselijke check vóór publicatie of verzending;
    • een voorbeeld van goede output.

    Dit is minder spectaculair dan een autonome agent, maar het levert sneller bruikbaar werk op. De bedrijven die hier voordeel uit halen, bouwen geen promptbibliotheek vol losse trucjes. Ze bouwen werkafspraken rond AI.

    Waar coaching zinvol wordt

    Prompting wordt interessanter zodra de vraag niet meer is “welke prompt werkt?”, maar “welke taak mag AI voorbereiden en welke keuze blijft bij mij?”. Daar zit het verschil tussen spelen met ChatGPT en AI inzetten in uw dagelijkse werk.

    In een Prompt Coaching sessie is dat meestal de eerste stap: één echte workflow kiezen, de taakgrens vastzetten en daarna pas prompts schrijven. Zo wordt persoonlijke AI geen vaag toekomstwoord, maar een manier om beter voorbereid aan uw eigen beslissingen te beginnen.

    Verder lezen

    Prompt engineering wordt pas nuttig als je de fout kunt aanwijzen: ontbrekende context, verkeerde rol, geen voorbeeld of geen controle op het antwoord. Lees daarna ook bekijk de AI-prompt hub of gebruik de Prompt Coach.